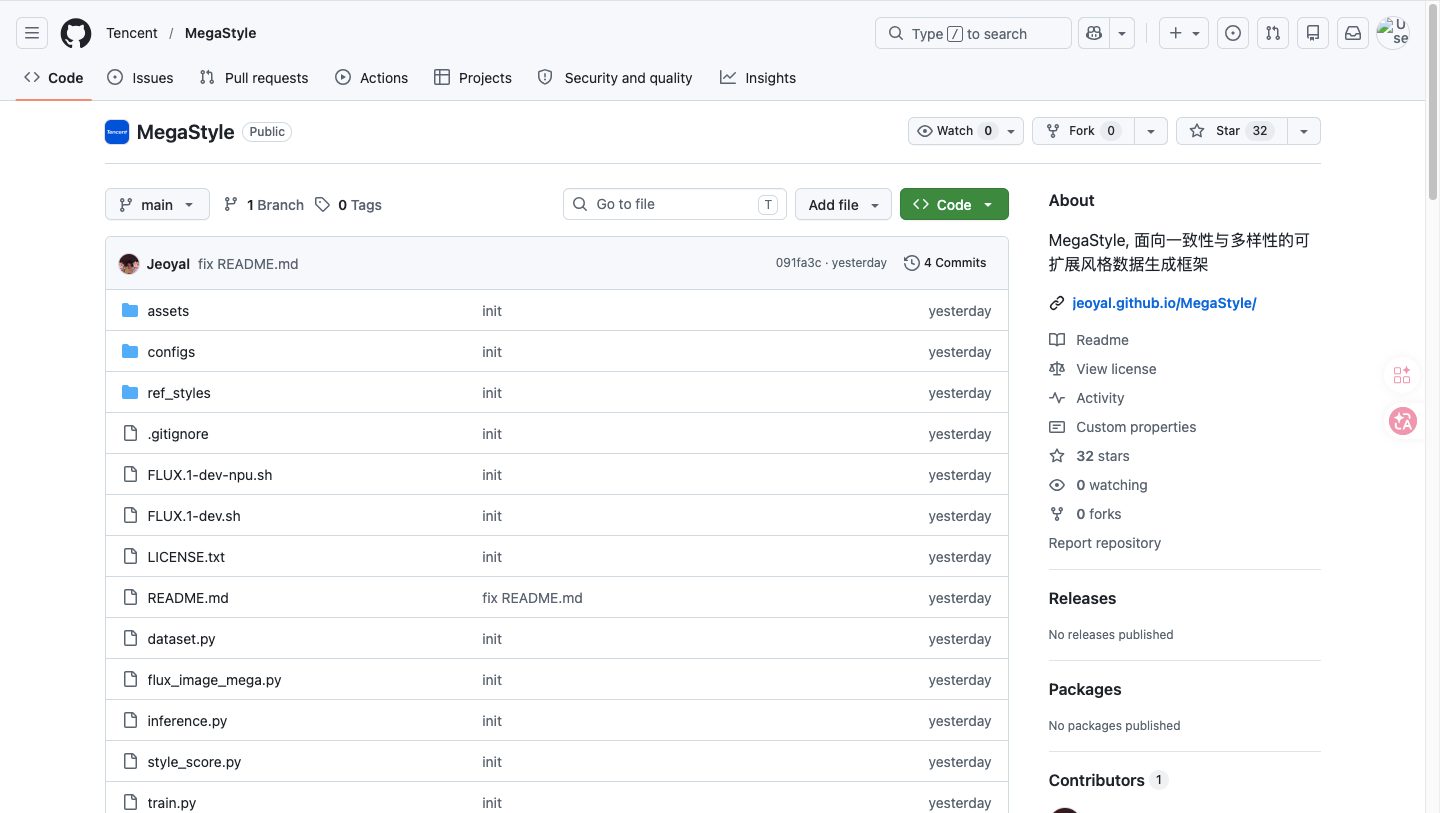
4 月 21 日消息,腾讯与同济大学联合团队今日在 GitHub 放出 MegaStyle 项目的完整训练/推理代码、1.4M 规模的风格图像数据集 MegaStyle-1.4M、以及训练完成的两个下游模型——基于 FLUX.1-dev 的风格迁移模型 MegaStyle-FLUX 和用于风格相似度测量的 MegaStyle-Encoder。论文 2604.08364 同步挂出,项目定位是"面向一致性与多样性的可扩展风格数据生成框架"。作者团队在社交媒体上把这次发布定性为"风格迁移的 ImageNet 时刻"——核心诉求在数据层而非模型层。
核心:170K 风格 × 400K 内容 = 1.4M 配对图像
MegaStyle 最关键的交付物是数据集本身。团队通过精心设计的 prompt 画廊收集了 170K 条风格 prompt 和 400K 条内容 prompt,两者做组合后用大模型生成 1.4M 张图像。这个数据集的两个关键属性是"intra-style consistency"(同一风格内的一致性——每一行展示的是同一种风格下不同内容的图像)和"inter-style diversity"(不同风格之间的多样性——覆盖颜色、光影、纹理、笔触等维度的大量细粒度风格)。
训练代码基于 DiffSynth-Studio 构建,FLUX.1-dev 作为基础模型,训练脚本同时提供标准 GPU 版本和华为 NPU 版本(FLUX.1-dev.sh 和 FLUX.1-dev-npu.sh)。推理只需下载 models/megastyle_flux.safetensors 检查点、执行 inference.py,项目附带 50 张来自 StyleBench 的参考风格图用于开箱测试。风格评分工具 style_score.py 使用 MegaStyle-Encoder 计算两张图像的风格相似度。
环境要求相对轻量:Python 3.10 + diffsynth==1.1.8,外加 SigLIP(google/siglip-so400m-patch14-384)和 FLUX.1-dev 两个预训练模型。
技术路径:用"文图一致性风格映射"替代人工采集
数据策划链路是这个项目的差异化部分。团队先从开源数据集收集风格图像和内容图像,然后用 Qwen3-VL 按照精心设计的 instruction 生成风格 prompt 和内容 prompt,并做 balance sampling 处理长尾分布,最后用 Qwen-Image 基于 content-style prompt 组合合成 1.4M 张风格图像。整条流水线的理论基础是当前大生成模型具备"一致性文图风格映射"能力——给定同一段风格描述,模型可以在不同内容 prompt 下生成风格保持一致的图像。
在 1.4M 数据之上,MegaStyle-Encoder 用 style-supervised contrastive learning 做微调,学习提取"具有表达力的风格专属表征";MegaStyle-FLUX 则是配对监督的风格迁移模型,吃一张参考风格图加文本内容 prompt,输出对应内容的风格化图像。论文展示的定性对比涵盖色彩、光影、纹理和笔触四个维度的细节保真度。
为什么是"ImageNet 时刻":风格迁移长期缺大规模配对数据
"风格迁移的 ImageNet 时刻"这个定位值得拆开看。2012 年 AlexNet 在 ImageNet 上的突破本质上是一次"大规模标注数据 + 深度模型"的组合胜利——ImageNet 提供了 120 万张人工标注图像,为视觉识别模型训练提供了基础。风格迁移领域的处境不同:自 2015 年 Gatys 发表 neural style transfer 以来,这个方向的技术演进主要靠模型架构创新(从 VGG 特征匹配到扩散模型、从 IP-Adapter 到 cross-attention injection),而不是数据规模。过去主流方法多依赖 training-free 的推理技巧,或者用小规模配对数据做轻量微调。
MegaStyle 试图改变这一格局的方式,是把"海量高质量风格配对数据"作为可扩展的公开资产释出。170K 个风格 prompt 对应的配对样本规模,在公开风格迁移数据集里属于量级跃升;更关键的是配对数据的结构——同风格跨内容的 pair 可以直接用于监督训练,不再依赖 training-free 的 attention 操纵。团队把这一方法论定位为"在风格迁移领域复现 ImageNet 路径"的尝试:不赌模型架构,而赌"数据规模 + 配对监督"能不能让下游模型整体往上抬一个台阶。
竞品对比:从 training-free 推理到数据驱动训练
对比基线在论文里列得很清楚:DEADiff、StyleShot、Attention-Distillation(Attn-Distill)、CSGO、StyleCrafter、InstantStyle、StyleAligned,这些是过去两年风格迁移领域的 SOTA。它们的共同特点是,要么完全 training-free(比如 InstantStyle 和 StyleAligned 依赖 attention 层的特定操纵),要么用较小规模配对数据做轻量化的 adapter 训练。
MegaStyle-FLUX 的路径是另一条——用 1.4M 配对监督数据直接训练 FLUX 主干,走"堆数据+完整训练"的重资产路线。论文声称在这条路径下拿到了相较 SOTA 的优势,但真正的行业共识还得等 community 复现和第三方 benchmark 验证。
从发布形态看,MegaStyle 完整开源训练代码、数据集和模型权重,在 Apache-like license 下放出。对比此前一些"只开源推理代码但数据和训练过程不公开"的项目(比如部分基于 IP-Adapter 的风格迁移工作),这次的开放度明显更高,方便研究者在其基础上继续扩展。
局限:数据多样性、计算成本、评测基准仍是开放问题
项目也留下几个需要继续验证的问题。
一是数据集本身的多样性和偏差。1.4M 数据由 Qwen-Image 生成而非人工采集,风格多样性取决于 170K 风格 prompt 的覆盖范围以及 Qwen-Image 本身的风格先验。如果底模对某些艺术流派(非西方传统艺术、地域性风格、小众摄影语言)覆盖不足,下游模型会继承这些盲区。团队在 TODO List 里明确写了"A more diverse and larger-scale style dataset",说明这个方向还在迭代。
二是训练和推理的计算成本。基于 FLUX.1-dev 的风格迁移模型本身参数量不小,1.4M 数据全量训练对 GPU 资源要求高。提供 NPU 脚本虽然拓宽了硬件选择,但对个人研究者或小团队复现的门槛依然存在。
三是风格迁移领域缺乏统一 benchmark。论文用 StyleBench 的 50 张参考图做定性对比,但整个赛道的定量评测仍以 CLIP score、DINO similarity 等代理指标为主,不同工作之间的可比性有限。MegaStyle-Encoder 能否成为新的风格相似度测量标准,是个开放问题——如果社区接受它作为 reference metric,风格迁移的评测基础设施会受益;如果没有,它就会只是一个内部评估工具。
四是"数据驱动 vs training-free"的范式之争尚未落定。过去两年 training-free 方法之所以受欢迎,很大程度是因为它们不用重训、不用数据、部署成本低。MegaStyle 证明数据驱动路径可行,但并未证明它在所有应用场景下都优于 training-free——后者在"快速接入新基模"这种灵活性场景下仍有价值。
 AI 速览