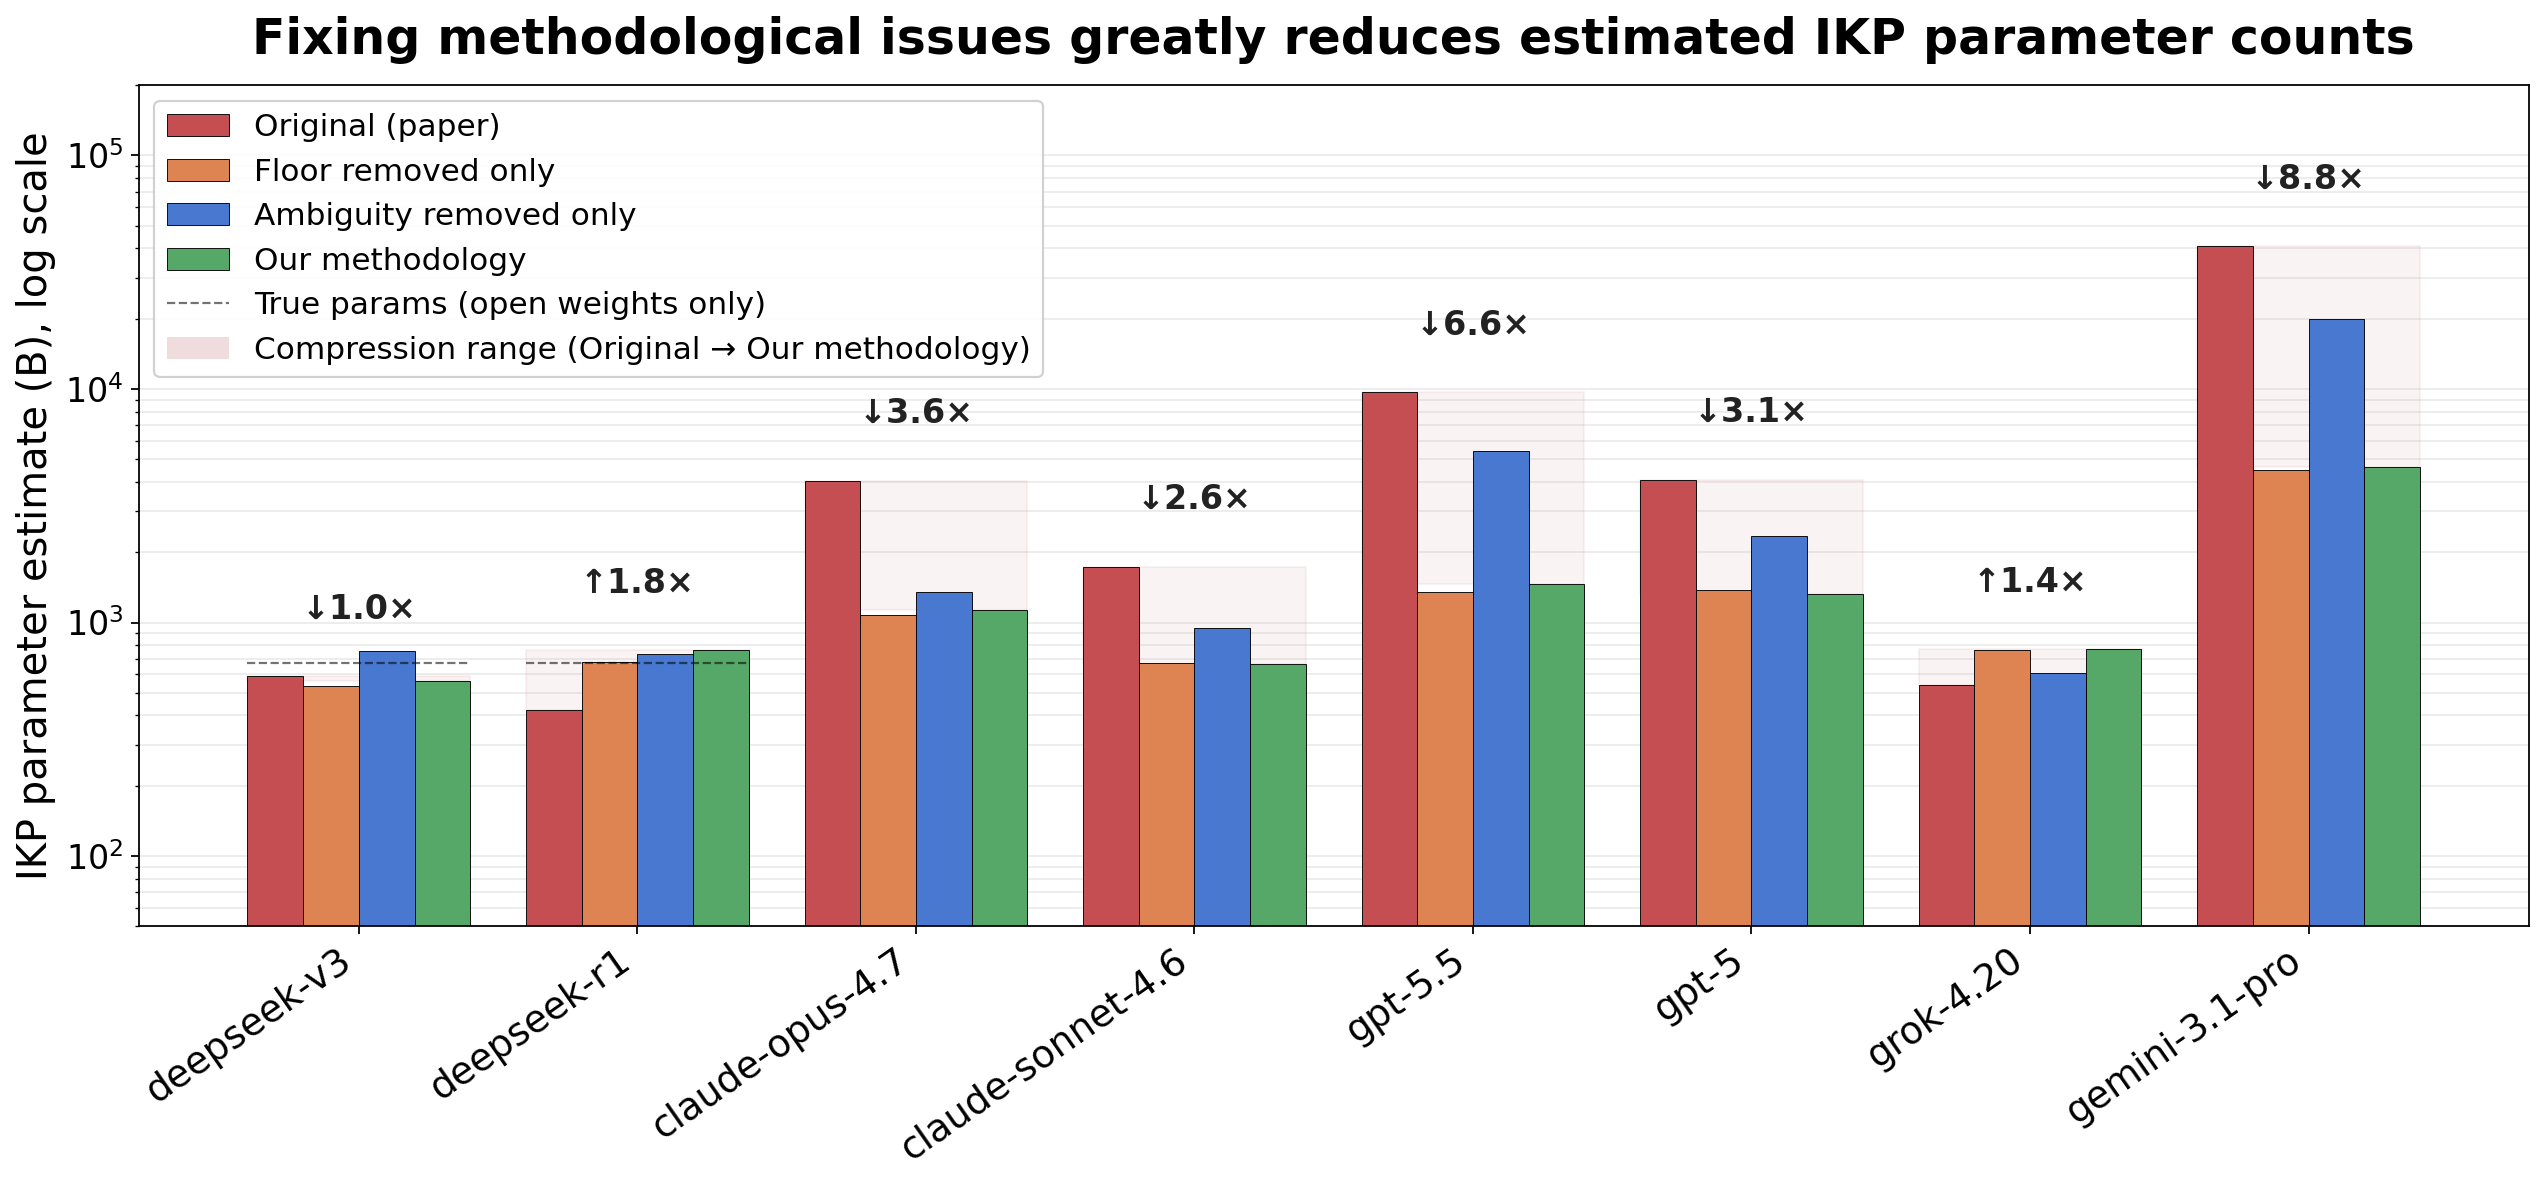
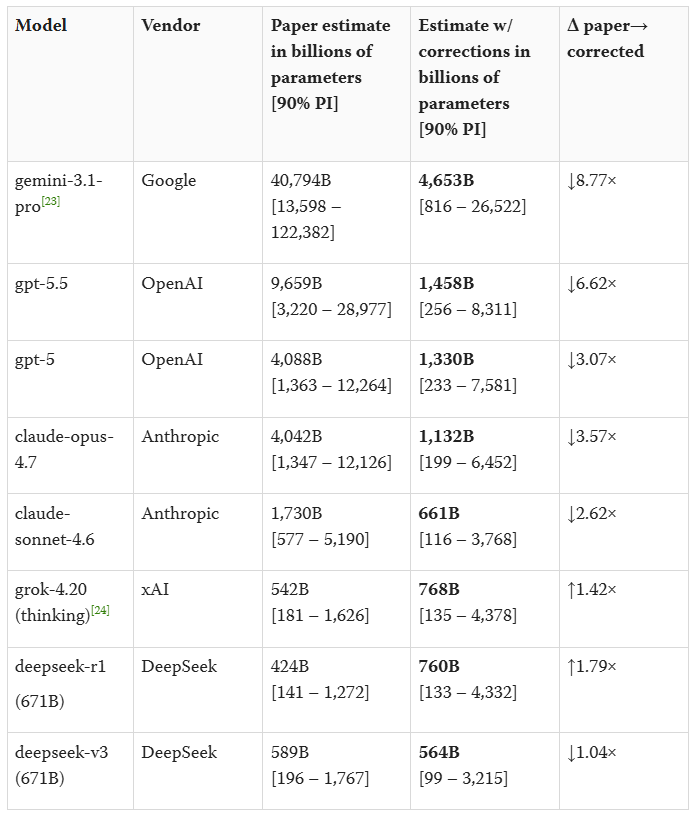
5月3日日消息,LessWrong发布署名 Sturb(Benjamin)与 LawrenceC 的复现报告 Sanity-checking "Incompressible Knowledge Probes",对 Pine AI 首席科学家 Bojie Li 此前在 arXiv 发布的单作者论文 Incompressible Knowledge Probes: Estimating Black-Box LLM Parameter Counts via Factual Capacity 进行了方法学审查与代码级重跑。 原论文宣称通过事实知识探测器(IKP)反推出闭源前沿模型的参数量,给出 GPT-5.5 约 9.7T、Claude Opus 4.6 约 5.3T、Gemini 3.1 Pro 约 40.8T 的爆款数字,曾在推特广泛传播;复现作者修正两个被他们识别出的方法论问题之后,给出的对应数字是 GPT-5.5 约 1.5T、Claude Opus 4.7 约 1.1T、Gemini 3.1 Pro 约 4.7T——三组数字相比原论文分别下调 6.62 倍、3.57 倍、8.77 倍。 复现报告的判断很谨慎:"我们对 GPT-5.5 给出的 1.5T 不应被读作'真实参数量'的可信估计,更应被读作'这种方法论本身对参数估计极不稳定'的证据"。换句话说,这次复现不是宣告"GPT-5.5 真有多少参数",而是把 IKP 这套方法的稳定性问题摊开来看——而原论文那组吸引眼球的多万亿参数估计,恰恰建立在这套不稳定方法之上。
IKP 论文做了什么:1400 道题、7 个难度档、与开源模型参数对数线性回归
Li 的 IKP 方法核心思路在论文圈内被认为是合理的。他构造了 1400 道事实问题数据集,分成 7 个难度档(每档 200 题),来源四类:GPT-5 生成(401 题)、Wikidata SPARQL 抓取(557 题)、DBLP/OpenAlex 研究者档案问答(345 题)、人工补充(97 题)。难度分档由 6 个"地标模型"经验校准——Qwen 2.5 0.5B 到 1B 对应 T1,Kimi K2.5 1T 对应 T5,Gemini 3.1 Pro 对应 T6,T7 是所有地标都答不对的题。 打分采用 4 档:CORRECT +1.0、WEAK +0.5、REFUSAL 0、WRONG -1.0("幻觉惩罚"),由 Gemini 3 Flash Preview 当裁判,所有目标模型在 temperature 0 下跑一次。在 89 个已知参数量的开源模型上,Li 跑出 IKP 准确率与 log 参数量的 OLS 回归 R²=0.917、留一中位 fold error 1.59x,再用回归反向外推出闭源模型参数。论文还做了三件副产品:用 IKP 数据"证伪"了之前的 densing law(声称模型每 3.3 个月参数效率翻一倍)、显示 MoE 总参数比有效参数预测事实知识更准(R² 0.79 vs 0.51)、用幻觉相似度做模型血缘聚类。复现作者指出,这套核心思路本身——用记忆容量反推参数量——是有价值的,他们专门在结论里写明欢迎更严谨的后续工作。
两个核心缺陷:代码层 flooring 与数据集 9.4% 题目存在模糊或错误
复现作者识别出两处对结果有显著影响的方法论问题。
第一处是代码与论文文本不一致的 per-tier flooring。论文 4.3 节明确写"per-tier 分数不在零处取截断,以保留校准信号",但代码里实际做了零截断。这一差异在小模型上影响巨大——小模型大量幻觉本应得到很负的分数,flooring 把这些负分截到 0,等于人为拉高了小模型的表现。具体效应:1B 以下模型的准确率从未截断的 -0.39 被抬到约 0.05;500B 以上模型仅从 0.51 抬到 0.57。结果是 log 参数对准确率的斜率从未截断的 3.56 拉高到 6.79,几乎翻倍。复现作者直言:"这意味着原论文里前沿模型的多万亿参数估计,很大程度上是 flooring 这一未文档化的'代码层优化'的产物"——拿掉 flooring,R² 也从 0.917 跌到 0.815,90% 预测区间从 3.0 倍宽扩到 5.7 倍。
第二处是数据集本身的歧义与错误。复现作者对 1400 道题做了系统性审计:
- 研究者问题 345 题中,86 题(24.9%)的研究者姓名与至少 2 个引用数 ≥50 的不同 OpenAlex 档案相撞,T3-T7 各档比例都在 22-31% 之间;另有研究者所属子领域随时间漂移导致 gold answer 失真,如 Dan Suciu 被标为"programming languages",但其最高被引和最近工作其实在数据库方向。
- Wikidata 问题 557 题中,45 题(8.08%)的实体名指向 ≥3 个不同 wikidata 实体(如"Cape Simpson"在格陵兰、阿拉斯加、南极各有一个);另有多作者作品仅取一位作者作为 gold answer 等语义模糊。
- 人工补充题 97 题中至少 2 题 gold answer 错误(孟加拉国最高峰、蒙古人民革命党成立年份)。
合计 131 题(9.4%)有问题,且模糊题集中在难档——T5-T7 的所有 600 题全部来自前两类高歧义来源。Li 在论文附录 H 提到了类似担忧,但没有量化影响。
修正后的数字:8 个前沿模型估计普遍下降,3 个 Li 的发现保留下来
复现作者同时修正这两个问题——拿掉 flooring 并剔除 131 道有问题的题,重新跑 OLS。结果是闭源前沿模型参数估计普遍下降,下降幅度与 Li 原始数字本身的"夸张程度"成正比:
但报告同时指出,Li 的三组发现在所有压力测试下都站住了:第一,IKP 准确率与 log 参数量呈对数线性关系,斜率约 0.15 在 ≥0.5B、≥10B、≤30B、≤100B、纯 dense、纯 MoE 各种子集上都稳定;第二,"densing law"在 IKP 数据上不成立——加上日期协变量的 OLS 给出 γ=-0.0010/月、95%CI [-0.0031, +0.0008],与零无显著差异,原 densing law 预测的 +0.0117/月被以"实际接近确定性"的强度拒绝;第三,MoE 模型用总参预测事实知识确实优于有效参(不过 R² 36 个点的差距部分是 x 范围伪影,更诚实的 LOO 中位 fold error 差距只有 13%)。
复现报告对此的总结性表述是:在 IKP 数据上、控制参数量后,开源模型的事实回忆能力从 2023 年到 2026 年 4 月没有提升——这与 MMLU、HumanEval 这类程序性能力随时间显著进步的趋势相反,而非否定 densing law 在更广泛能力维度上的适用性。
局限段:复现自身的不确定性、Li 反驳空间、AI 辅助审查的双面性
这次复现本身也存在几层需要标注的局限。
第一,复现作者自己承认 1.5T 不是"真实值"的断言。他们对 GPT-5.5 真实参数量保持高度不确定,给出的 1.5T 仅是"在我们能修复的方法论问题修复之后,这套方法给出的数字"。Wikidata 问题中"无法用程序自动剔除的语义模糊"未被全部清理,这意味着即便修正版数据集本身仍带噪。
第二,Li 的反驳空间存在但有限。在解读上,Li 可能主张 flooring 是"刻意保留的设计选择"(虽然论文文本明确否认)、可能质疑复现作者剔除题目的判定标准、也可能在歧义题的"模型答错是模型问题还是数据集问题"上展开方法论辩论。但代码与论文文本明确不一致这一事实,以及 24.9% 研究者题模糊率这种偏差量级,留给 Li 的腾挪空间相对有限。截至本文发稿,Li 与 Pine AI 尚未公开回应。
第三,复现工具链同样基于 LLM 辅助,存在镜像风险。两位作者明确披露使用 Claude Code 与 Codex 完成大量代码生成,每人花费 8-10 小时(相比上一代编辑器的 15-20 小时),合计烧掉超过 250 万 Opus 4.7 token。他们用四类预防措施降低 LLM 错误风险——交叉验证、人工 spot-check、自建 LLM wiki 保持判断一致性、用 verifier agent 双重检查代码——但这套链路本身仍然依赖 AI 辅助,意味着复现工作与原工作共享同一类底层风险源,只不过有更多的人工把关与冗余验证。 第四,方法论本身的可外推性存疑。LessWrong 评论区已有研究者(Stanislav Fort)追问:对于"用更大教师蒸馏出来的小模型",这套基于记忆容量的方法是否会系统性高估其参数?LawrenceC 回应表示理论上"过度训练的小模型 ≈ 蒸馏小模型",因为小模型已经没有更多容量记忆,但这个边界条件需要专门设计的开源蒸馏对照实验来验证。换句话说,IKP 这套方法的适用边界还远未被勘清。
整体看,这次 LessWrong 复现做了三件事:把"GPT-5.5 有 9.7T 参数"这个流量数字按住,让它至少不再被当成可引用的"事实";同时保留 IKP 核心思路的有效性,给后续更严谨的复刻研究留了入口;以及,把"AI 辅助生成的单作者实证论文"作为一种已知失败模式公开命名——单作者、无内外部审查、代码与论文不一致、营销文案领先方法学验证——并指出 Claude Code 这类工具同时降低了产出与审查两端的成本,使得这次复现得以在 8-10 小时内完成。LessWrong 报告的收束句把这层产业含义讲得最清楚:"随着产出新结果与审查新结果的成本同步下降,我们对每一个结果应该施加的审查强度也应该同步上升。"
 AI 速览