过去48小时,国内大模型圈发生了两件挺有意思的事——MiniMax和小米几乎在同一时间窗口,各自抛出了一套截然不同的Agent叙事。这不是普通的参数升级,也不是又一轮跑分竞争,而是两家公司对"Agent时代国产模型应该怎么打"这个问题,给出了完全不同的答案。
MiniMax M2.7:让模型参与"造下一代模型"
MiniMax在3月18日发布M2.7,核心叙事不是"更强的聊天模型",而是"第一个深度参与自身迭代的模型"。官方给这次发布起了个名字叫"Early Echoes of Self-Evolution"——这个命名很聪明,没有直接说"我们实现了完全自治的自我进化",而是说"听到了自进化的回声"。一方面把想象空间拉得很高,另一方面也给自己留了退路:当前阶段仍然是研究员设定目标,模型负责大段执行。
从官方页面披露的信息来看,M2.7的卖点有几个方向:
它不是单纯的代码模型,而更像一个"组织级Agent"候选。官方说它被用于构建内部研究Agent harness,RL团队研究员和Agent讨论实验想法,然后由Agent跟踪实验规范、拉数据、启动实验、监控日志、修代码、跑smoke test。官方声称在这类工作流里,M2.7可以承担30%到50%的流程。
Benchmark方向也很明显地朝"真实工程任务"倾斜:SWE-Pro 56.22%、Terminal Bench 2 57.0%、Multi SWE Bench 52.7……这组数字背后的共同点是,尽量绕开纯问答榜单,转向"要不要真的操作环境、要不要真的完成交付"。
还有一点很多人容易忽略:M2.7把"办公室生产力"提到了和coding同等重要的位置。官方给了一个金融分析的例子,基于台积电年报、电话会纪要和研究报告,自动搭建收入模型,再输出Excel、PPT和Word报告。这说明MiniMax押的是更宽的路线——Agent的价值高地不只是写代码,而是进入高价值脑力工作的交付环节。
真正最让人在意的,是它声称让M2.7在内部scaffold上自主完成"分析失败轨迹→规划修改→改脚手架代码→跑评测→比较结果→决定保留还是回滚"的循环,连续跑了100多轮,把内部编程评测集上的性能提升了30%。
这个方向信号非常值得重视。2024、2025年大家还在讨论"模型能否自己写代码",到了2026年,MiniMax直接把问题升级成"模型能否自己改提高模型表现的脚手架"。这不是一个量级的事情。
不过必须说清楚:M2.7的"自进化"是这次发布最亮眼的部分,也是目前需要更多公开材料补充的部分。它目前主要还是官方叙述,外部暂无完整技术报告,关键评测集、脚手架设置、性能统计方法也没有全部开放。更适合把它看成一个非常重要的方向信号,而不是"已经被行业充分验证的新范式"。
小米MiMo-V2-Pro:先跑起来再说
如果说M2.7代表"研究组织进化"的叙事,那MiMo-V2-Pro代表的就是"生产基础设施落地"的叙事。
规格上:总参数超过1T,激活参数42B,支持1M token上下文,Hybrid Attention混合比例从5:1升级到7:1,带轻量级MTP层。API价格≤256K时输入3/M,256K-1M时输入6/M。 这些数字几乎每一个都在服务同一件事:这是一个能接进现有Agent框架、马上开始跑真实任务的旗舰底座。
这次发布里最值得玩味的,是小米对"Hunter Alpha"的认领。
一周前,一个匿名模型Hunter Alpha在OpenRouter上线,调用量持续增长,多日登顶日榜,总使用量超过1T tokens。小米现在告诉你,那个神秘模型就是MiMo-V2-Pro的测试版本。 这一步解决了大模型发布里一个长期存在的问题:如何让外界看到不只有官方结论,也有真实市场环境中的反馈。传统发布基本上是发博客、发榜单、发demo,开发者自然会追问"这东西在真实框架里到底跑得怎么样"。小米这次先让模型以匿名身份接受市场压力测试,热度和调用量跑出来之后再"揭榜"。先验证真实需求,再完成品牌认领,借匿名阶段积累"不是靠品牌带量"的证明——这套GTM设计相当完整。
而且这个匿名测试明确瞄准Agent/coding框架生态,官方直接说MiMo-V2-Pro正在和OpenClaw、OpenCode、KiloCode、Blackbox、Cline等五大Agent开发框架合作,为开发者提供一周免费API访问。 这说明小米并不是想先成为"一个很强的大模型名字",而是想先成为"被开发者工作流默认接入的那一个模型"。一旦进入默认选项,开发者社区会自然帮助模型完成更多分发、测试与长尾场景适配。
不同场景下你该怎么选
把两者放在一起比,会发现它们根本不是同一种"强"。
它们都在抢Agent入口,但抢的不是同一个入口。M2.7的关键词是self-evolution、research harness、office deliverables、emotional intelligence——MiniMax的想象对象是"在公司内部承担多类知识工作、还能反过来参与模型迭代的agent员工"。MiMo-V2-Pro的关键词是1T参数、1M context、OpenClaw、Hunter Alpha、API pricing——指向同一件事:把它接进框架,就能跑。
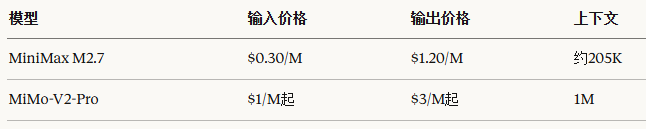
具体场景下,价格差异也挺明显:
如果你是OpenClaw/Cline/OpenCode这类Agent框架的重度用户,优先关注MiMo-V2-Pro。1M context对复杂Agent workflow是实打实的,它已经在OpenRouter匿名阶段承受过真实调用压力,答案更像"行,先跑起来再说"。
如果你在做企业内部知识工作自动化,尤其是文档、表格、PPT、研究流程,认真看M2.7。它在office deliverables和复杂skill adherence这条线上投入了更多表述,关注"AI能不能像一个初级分析师那样把第一稿做出来",M2.7的叙事会更吸引你。
如果纯看成本效率,任务不真的需要超长上下文、主要是标准coding/agent loop,M2.7的价格更有吸引力。但如果场景天然吃长上下文——大仓库级别多文件推理、超长文档会话记忆、持续多步Claw流程——MiMo-V2-Pro这个价格并不离谱,因为它卖的是更大的action space。
一句话总结:MiMo-V2-Pro是更像"已经准备好进入开发者生产流"的Agent基座,MiniMax M2.7是更像"已经看见下一阶段形态"的Agent-native研究型模型。
如果你今天就要把模型接进真实框架跑任务,优先关注MiMo-V2-Pro。但如果你问哪场发布更让人觉得"未来几年模型公司可能因此发生结构变化",那票得投给M2.7——因为它已经开始把模型放进"帮助模型变强"的闭环里了。这两件事,哪一件都不小。国产大模型,这次是真的在主动定义打法,而不只是跟着跑。
 AI 速览