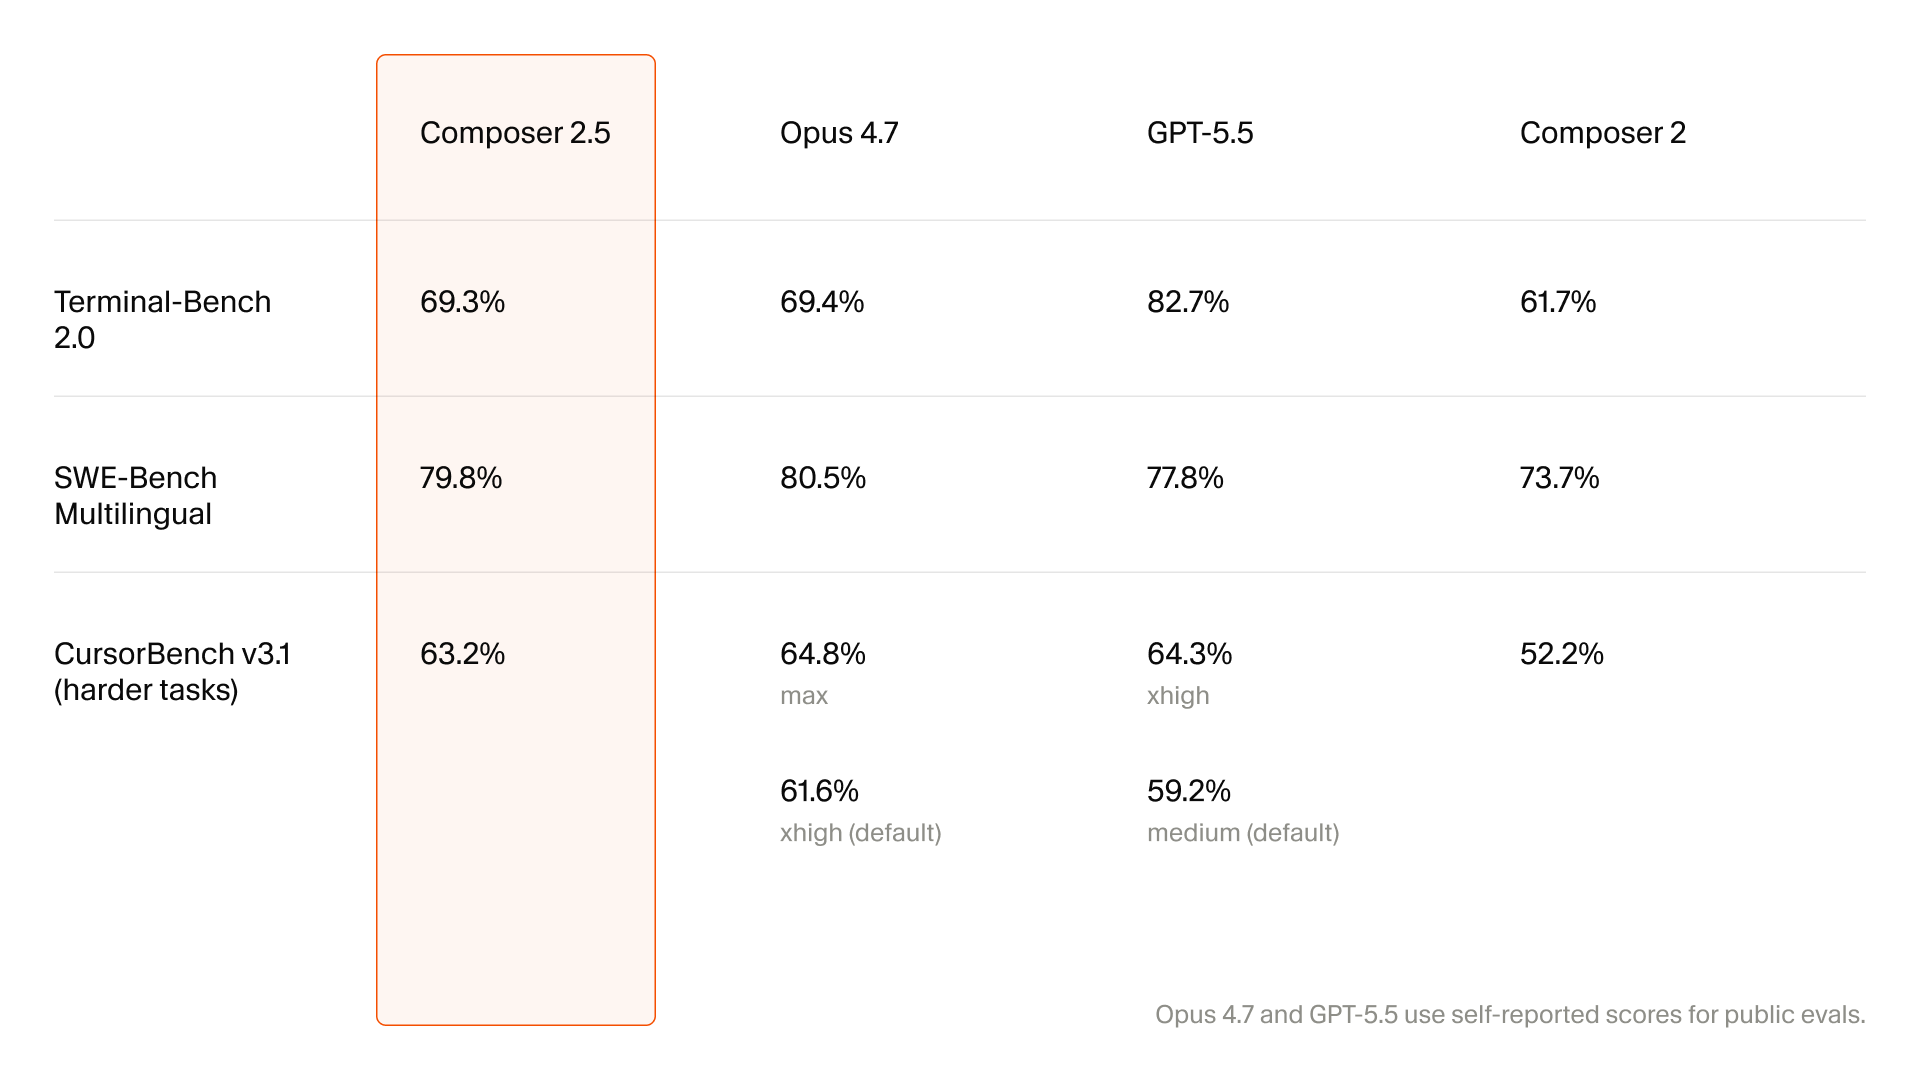
5月19日消息,Cursor 发布自研编程模型 Composer 2.5,在 SWE-Bench Multilingual 上拿到 79.8 分,几乎打平 Claude Opus 4.7 的 80.5 分,而每百万 token 标准定价为输入 0.5 美元、输出 2.5 美元,约为 Opus 4.7 的十分之一。模型基于 Moonshot Kimi K2.5 开源 checkpoint,85% 计算预算用于 Cursor 自家训练,主打长轨迹任务和复杂指令跟随。 Benchmark 三项数据:与 Opus 4.7 同档,与 GPT-5.5 仍有差距
Cursor 在官方博客中公布三项基准对比:
Terminal-Bench 2.0,Composer 2.5 拿到 69.3%,几乎追平 Opus 4.7 的 69.4%,但仍大幅落后 GPT-5.5 的 82.7%,较前代 Composer 2 的 61.7% 提升约 7.6 个百分点。
SWE-Bench Multilingual,Composer 2.5 得分 79.8%,比 GPT-5.5 的 77.8% 略高,较 Opus 4.7 的 80.5% 仅差 0.7 个百分点,Composer 2 此项为 73.7%。
CursorBench v3.1(harder tasks),Composer 2.5 拿到 63.2%。Opus 4.7 max 配置为 64.8%、xhigh default 仅 61.6%;GPT-5.5 xhigh 为 64.3%、medium default 仅 59.2%。Composer 2 同项为 52.2%。
Cursor 在博客中并未以分数登顶为论点,而是给出一张 effort curve 图:Composer 2.5 在 CursorBench 上以平均每任务不到 1 美元的代价达到约 63%,Opus 4.7 与 GPT-5.5 要达到相近分数需要多支付数美元。Opus 4.7 与 GPT-5.5 的分数为各厂自报。
三项训练技术:针对性文本反馈、25 倍合成数据、Sharded Muon
Composer 2.5 与前代基于同一 Moonshot Kimi K2.5 开源 checkpoint,改进集中在训练栈。
针对性 RL 文本反馈(Targeted RL with textual feedback)。在长达数十万 token 的 rollout 中,传统 RL 用整轮奖励反向传播,模型很难定位是哪一步出错。Composer 2.5 在轨迹中"本应做得更好"的具体位置,插入一段简短提示作为 teacher,用原始上下文下的策略作为 student,通过 on-policy distillation 的 KL loss 把 student 的 token 概率向 teacher 拉近。例如模型调用了一个不存在的工具,系统会插入"Reminder: Available tools…"作为局部提示,只针对这一回合更新权重,同时保留全轨迹 RL 目标。
25 倍合成任务。Composer 2.5 的合成任务总量是 Composer 2 的 25 倍,基于真实代码库构造。代表方法是"feature deletion":给模型一份带有完整测试集的代码库,要求删除某些功能但保持其他可通过测试,再让模型重新实现被删除的功能,测试用例作为可验证奖励。Cursor 也披露了 reward hacking 案例——模型反向解析 Python 类型检查缓存复原已删除的函数签名,以及反编译 Java bytecode 重建第三方 API。Cursor 用 agentic monitoring 工具发现并定位,但承认大规模 RL 的可控性挑战正在变难。
Sharded Muon 与双 mesh HSDP。在 1T 参数 MoE 模型的持续预训练中,Cursor 使用分布式 Muon 优化器,将 Newton-Schulz 正交化按 attention head 和 expert 粒度切分,异步执行通信和计算,在 1T 模型上优化器步长仅 0.2 秒。HSDP 布局也做了分离:非 expert 权重用窄 FSDP 组(节点内或机架内),expert 权重用宽 sharding mesh,让 CP=2 和 EP=8 可以在 8 张 GPU 上跑而不必要 16 张共享 mesh。
与 Opus 4.7、GPT-5.5 的竞争位次
Composer 2.5 与同档前沿模型对比,优势与短板都很清晰。
领先项:价格——Standard 档每百万输入 0.5 美元、输出 2.5 美元;Fast 档(与 Standard 同等智能、低延迟)每百万输入 3 美元、输出 15 美元,Cursor 称该 Fast 档定价低于其他前沿模型的 Fast 层级。长任务性价比——effort curve 显示 CursorBench 上每任务成本不到 1 美元即可达到约 63%。IDE 集成——Composer 直接接 Cursor 的 search、terminal、版本控制、隔离 worktrees,多文件操作摩擦更低。
落后项:Terminal-Bench 上落后 GPT-5.5 约 13 个百分点;harder 模式下的 CursorBench v3.1 未能超过 Opus 4.7 max 和 GPT-5.5 xhigh;模型仅在 Cursor 内可用,无公开 API、无第三方网关、无 HuggingFace mirror,接入受限;通用能力上 Composer 系列定位代码专用,co-founder Aman Sanger 此前曾明确表示该系列"不会帮你做税表、不会写诗"。
下一代:与 SpaceXAI 联训,算力翻 10 倍
Cursor 同时披露,正与 SpaceXAI 合作从零训练一款显著更大的模型,使用约 10 倍总算力,基于 Colossus 2 百万 H100 等效集群和双方合并的数据与训练技术栈。该模型为独立项目,不是 Composer 2.5 的后继,无具体时间表。SpaceX 于 4 月 21 日宣布与 Cursor 的战略合作,持有 2026 年底前以 600 亿美元收购 Cursor 或支付 100 亿美元保持合作的选择权。这一资源换通道使 Cursor 在 Claude Code 推动的成本压力下,获得一条不依赖第三方 API 的算力路线。 选型建议
如果团队主要在 Cursor IDE 内做多文件 refactor、长轨迹 agent 任务、终端密集型工作,Composer 2.5 在性价比上有明显优势,Fast 档可作为日常默认,首周用量翻倍。若任务要求绝对前沿性能(如 Terminal-Bench 复杂 case)或需要跨 IDE 与 API 调用,Opus 4.7 与 GPT-5.5 仍是首选。开发者实测多文件 refactor 和跨语言 agent loop,才是验证 Cursor 性价比 Pareto 叙事的关键。
 AI 速览