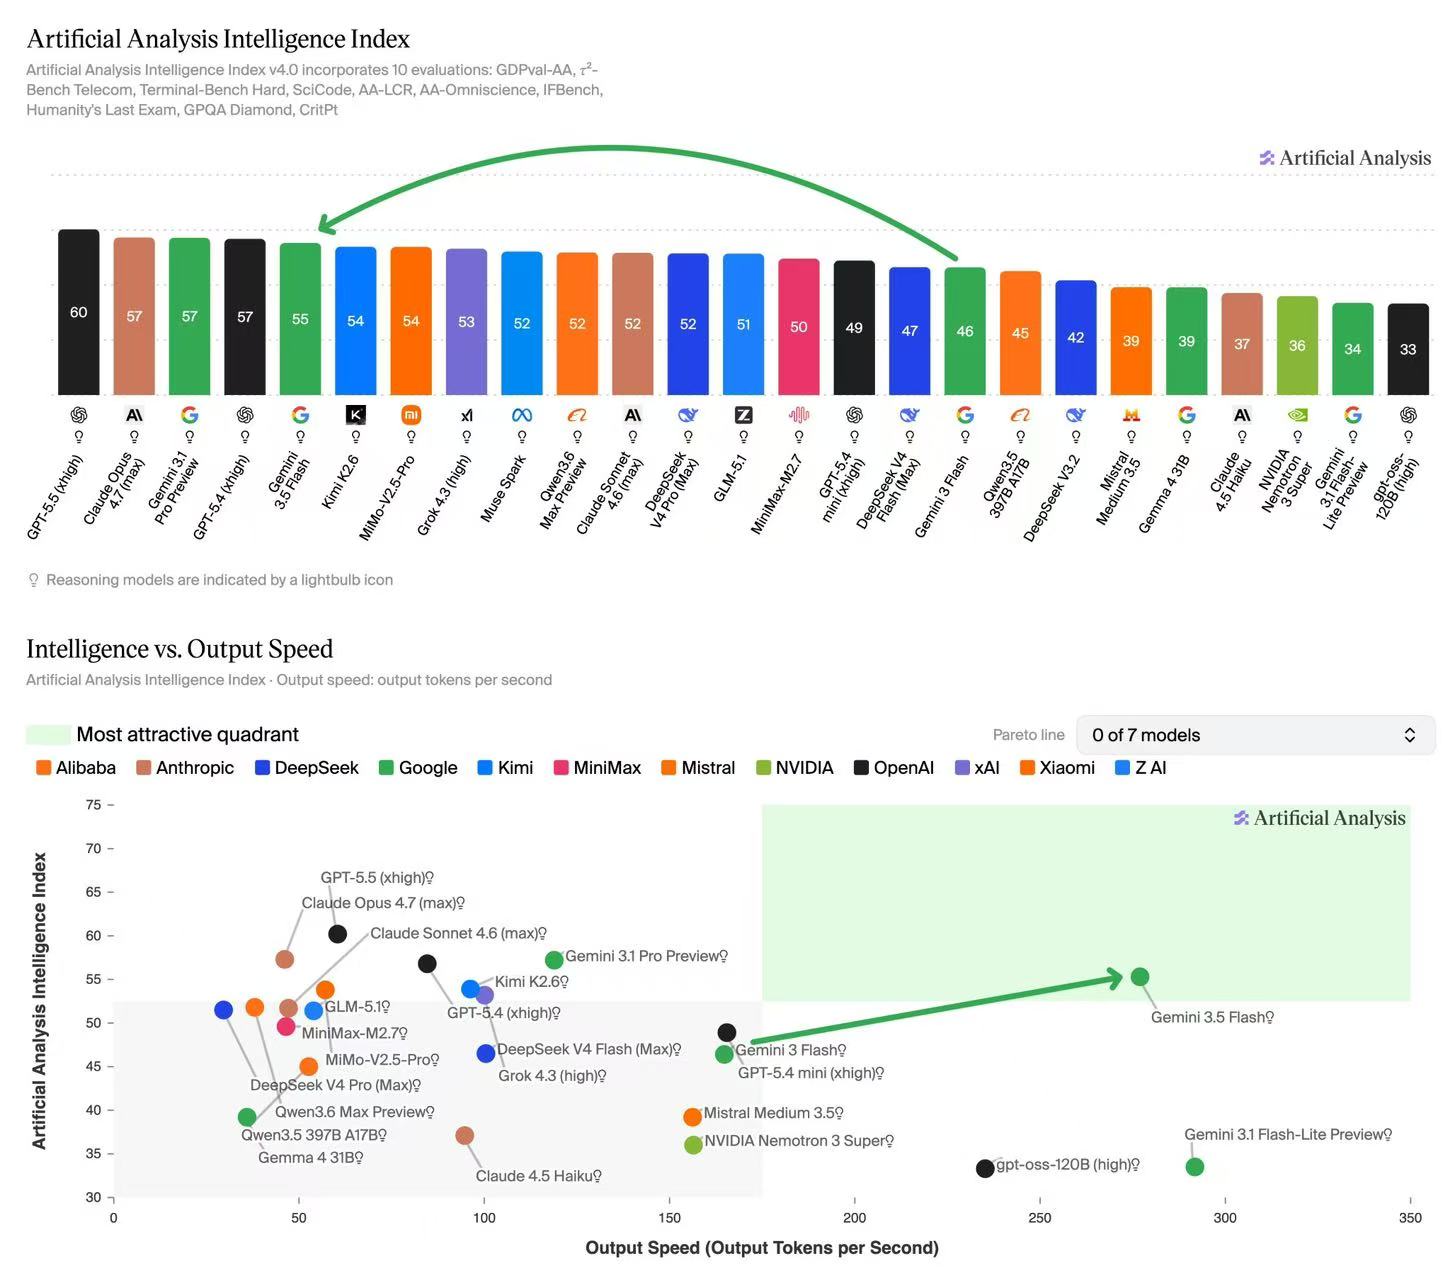
5月20日消息,Google在I/O期间发布 Gemini 3.5 Flash,并将其定位为面向代理工作流和编程任务的高速模型。 根据Google DeepMind官方模型卡,Gemini 3.5 Flash是Gemini 3系列的新一代多模态推理模型,支持文本、图像、音频、视频输入,最高1M token上下文和64K token文本输出;Google同时将其分发到Gemini App、Gemini Enterprise、Google AI Studio、Gemini API、Search AI Mode和Google Antigravity等渠道。 从“轻量模型”转向Agent主力
Gemini 3.5 Flash延续了Flash系列的速度定位,但这次Google强调的不只是低延迟,而是代理任务和编程能力。Google DeepMind在模型卡中列出的评测显示,Gemini 3.5 Flash在多项编码、工具调用和代理任务上超过Gemini 3.1 Pro:Terminal-bench 2.1 为76.2%,高于Gemini 3.1 Pro的70.3%;MCP Atlas为83.6%,高于Gemini 3.1 Pro的78.2%;OSWorld-Verified为78.4%,也略高于Gemini 3.1 Pro的76.2%。
这意味着Flash不再只是“更快、更便宜的替代品”,而是在Google最看重的Agent和代码场景中承担前沿能力入口。Google官方模型卡也明确写到,Gemini 3.5 Flash适合agentic workflows、coding tasks和multi-week enterprise processes。
即日可用,覆盖Gemini App、Search和开发者平台
可用性方面,Gemini 3.5 Flash已经进入多个Google核心入口。Google DeepMind模型卡列出的分发渠道包括Gemini App、Gemini Enterprise App、Gemini Enterprise Agent Platform、Google AI Studio、Gemini API、Search AI Mode和Google Antigravity。媒体现场报道还提到,它已在Gemini App和Google Search AI Mode中向全球用户推出,并可通过Google AI Studio、Android Studio、Antigravity和企业平台供开发者与企业使用。
这次发布的关键不只是模型本身,而是Google把同一个模型放进消费端、搜索端、开发者工具和企业Agent平台。对开发者来说,Gemini 3.5 Flash会成为Antigravity和Gemini API中的重要执行模型;对普通用户来说,它会出现在Gemini App和Search AI Mode里,承担更快的多步推理与任务执行。
性能信号:更快,但“成本更低”要看比较对象
Google和多家现场媒体都强调,Gemini 3.5 Flash在同类前沿模型中速度优势明显,部分说法提到输出速度可达到可比前沿模型的4倍,并且成本通常低于同类前沿模型的一半。不过这句话需要准确理解:它主要是相对“可比前沿模型”而言,不等于一定比Google上一代Flash更便宜。
从官方模型卡看,Gemini 3.5 Flash的重点是质量、成本和延迟之间的平衡。它基于Gemini 3 Flash,并通过thinking levels控制质量、成本和延迟的组合。换句话说,Google正在把Flash做成可规模化运行的Agent模型,而不是只服务于简单问答的快速模型。
关键信号
Gemini 3.5 Flash在Terminal-bench、MCP Atlas、OSWorld-Verified等编程和代理基准上超过Gemini 3.1 Pro,但并非所有能力都全面领先3.1 Pro。它的优势集中在代码、工具调用、代理工作流和速度。
Google正在把Flash系列从“低成本快模型”升级为“可承担复杂Agent任务的默认执行模型”。这与Antigravity、Search AI Mode、Gemini Enterprise Agent Platform等产品入口同步出现,说明Google想让同一模型覆盖用户、开发者和企业工作流。
Gemini 3.5 Flash的发布,标志着Google在Agent时代的模型策略发生变化:前沿能力不再只放在Pro模型里,而是被下沉到速度更快、部署范围更广的Flash模型中。对行业来说,这会加速一个趋势:Agent产品真正能不能规模化,不只看最高智商模型,而看“足够强、足够快、足够便宜”的执行模型。
 AI 速览