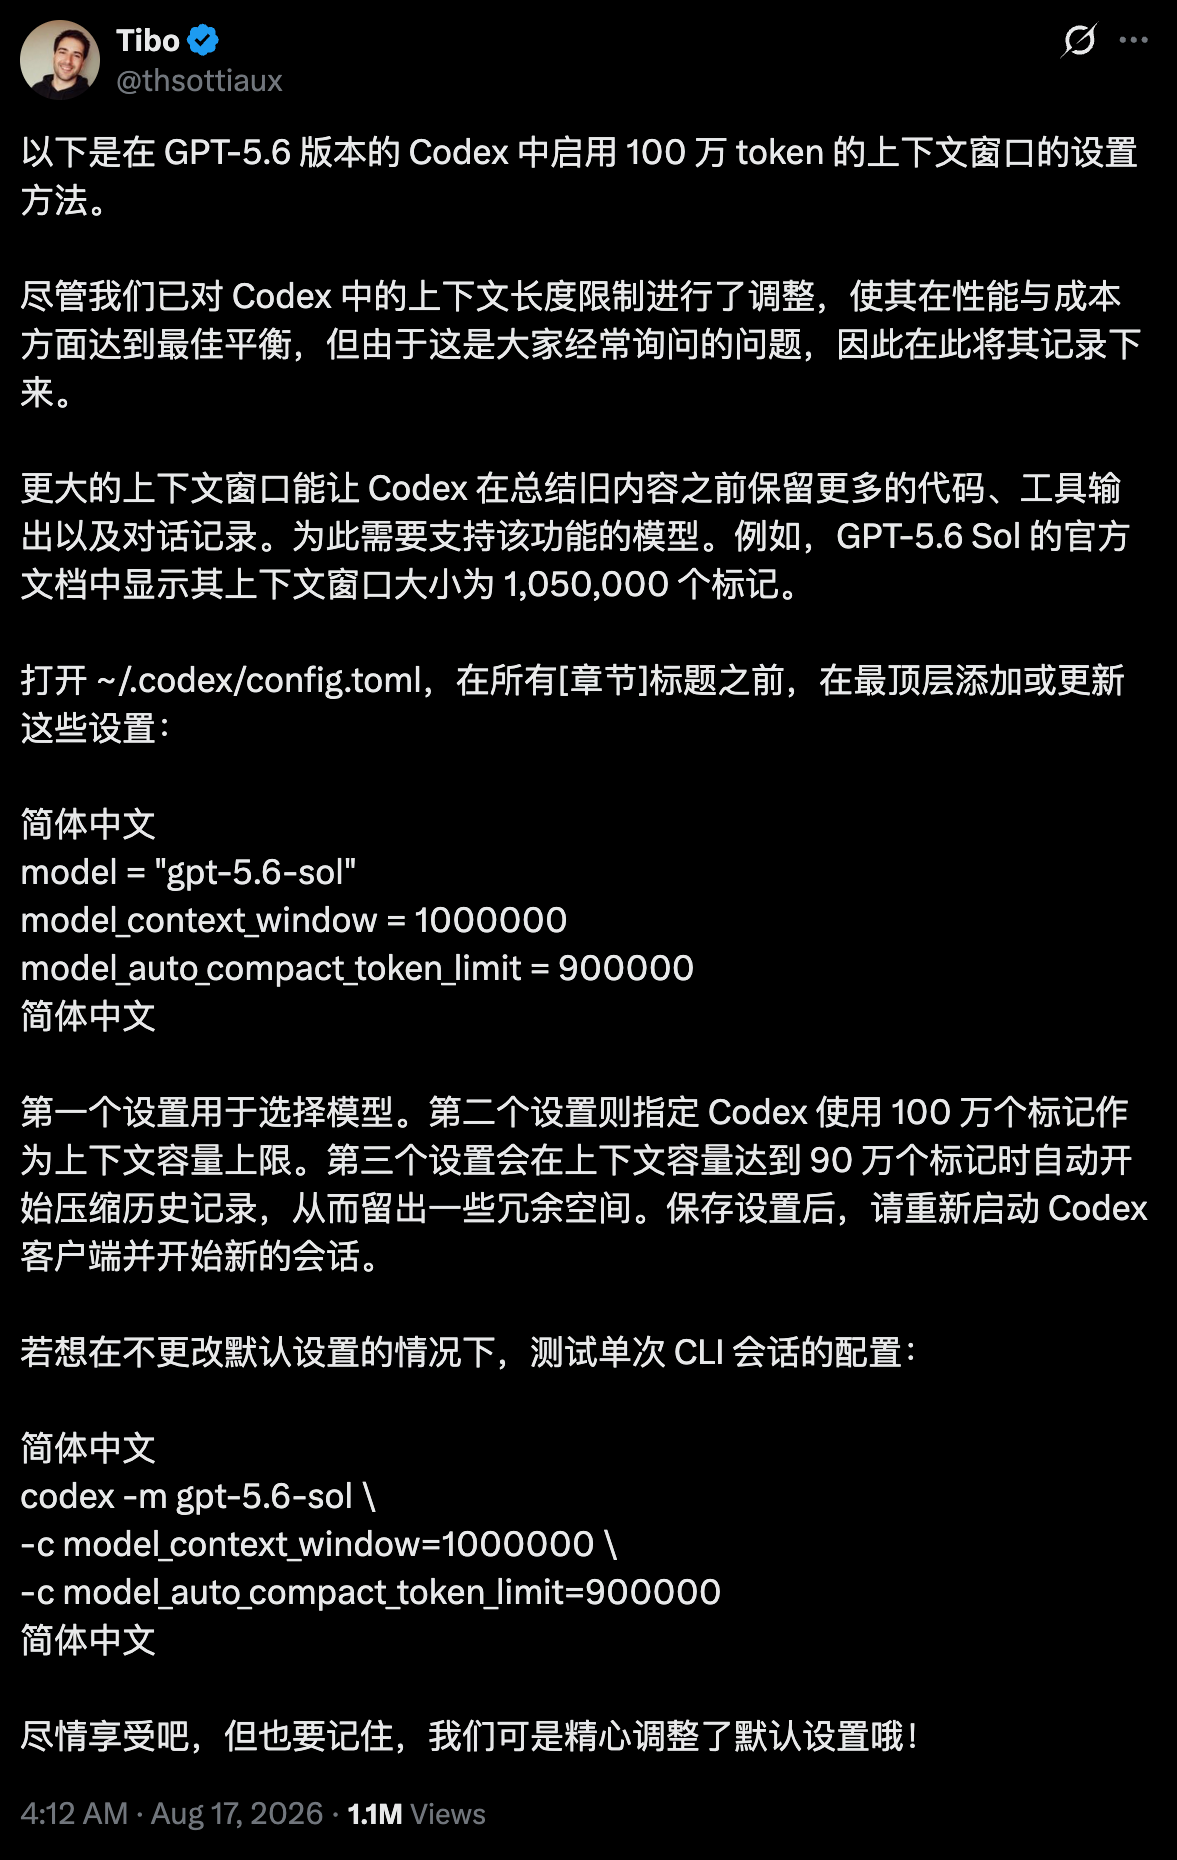
8月17日消息,OpenAI Codex 负责人 Tibo Sottiaux 公布了为 GPT-5.6 Sol 启用约 100 万 token 上下文窗口的配置方法,ChatGPT 账户登录的 Codex 用户同样适用。同期,Codex 的 Multi-Agent v2 被确认可以将任务委派给任意受支持模型,包括定价最低的 GPT-5.6 Luna。两项更新都不是新模型发布,而是把此前由官方默认值控制的资源调配权——用多少上下文、用哪档模型——交到了用户手里。
百万上下文:三行配置自助开启,官方提醒默认已调优
Tibo Sottiaux 给出的方法是在 ~/.codex/config.toml 顶层加入三行设置:将模型指定为 gpt-5.6-sol ,把 model_context_window 设为 1000000,并把 model_auto_compact_token_limit 设为 900000,即在约 90 万 token 处触发历史自动压缩、留出余量。保存后重启 Codex 并新建会话生效;只想单次试用的话,也可以用 codex -m gpt-5.6-sol -c 参数临时指定,不改默认配置。
GPT-5.6 Sol 的模型规格本身就支持这个量级。OpenAI 的模型文档标注其上下文窗口为 105 万 token、最大输出 12.8 万 token,API 定价为输入每百万 token 5 美元、输出 30 美元。但模型规格和 Codex 产品层的可用预算一直是两回事。7 月,多名用户在 OpenAI 官方 GitHub 仓库报告,ChatGPT 登录的 Codex 会话上下文预算接连下调,有效值从约 35 万 token 一度降到约 25.8 万,远低于对外标注的模型规格,有报告直接以"严重回归"为题。当时产品层下发的上限会覆盖本地配置,这正是"百万上下文此前主要停留在 API 层"这一说法的来源。
Tibo Sottiaux 此次发帖的口径值得注意。他没有宣布更改默认值,而是说 Codex 的默认上下文限制已经"在性能和成本上调优到最优",开放配置方法是因为"这是一个常见诉求,所以把它文档化"。这一口径的含义是,官方认可用户自行开大到 100 万 token,但明确提醒这会偏离调优过的默认状态,成本上升和等待时间变长的代价由用户自己权衡。
Multi-Agent v2:主代理可以把任务派给 Luna 了
第二项变化发生在多代理编排上。OpenAI 开发者社区的讨论确认,Codex 的 Multi-Agent v2 现在可以把子任务委派给任意受支持模型,不再局限于主代理自身的模型。此前在 7 月下旬,v2 会话的 spawn_agent 还只接受 gpt-5.6-sol 和 gpt-5.6-terra,选择更轻量的 Luna 会直接报错。这项能力的落地版本是 8月7日发布的 Codex CLI 0.147.0,官方更新日志中有一条"在 multi-agent v2 中支持叶模型(leaf models)"。
由此形成的架构是:Sol 或 Terra 充当编排器,把可并行、边界清晰的子任务派给协作代理或叶代理,Luna 只能作为纯子代理执行,不能再向下委派。社区实践建议为子代理 fork 独立会话,否则会继承编排器的推理过程。这一分工的经济账很直观:7月30日降价后,GPT-5.6 三档的 API 定价分别为 Luna 输入每百万 token 0.2 美元、Terra 2 美元、Sol 5 美元,最高档与最低档相差 25 倍。把简单任务从 Sol 换到 Luna,是用户侧最直接的省钱手段。需要说明的是,"复杂规划用 Sol/Terra、清晰并行任务用 Luna"这类用法建议目前来自开发者社区的总结,OpenAI 官方文档化的是委派能力本身。
两项开放指向同一个方向
7 月,OpenAI 还在收紧 ChatGPT 用户的实际上下文预算,并多次为超额用户重置额度,当时的姿态是由官方统一控制成本。8 月中旬,同一团队的做法变成:默认值继续保持保守,但把向上突破的通道正式文档化,同时在任务粒度上放开模型选择。控成本的方式从"官方替你定"变成了"官方定默认,其余你自己调"。
这条转向有明确的商业条件支撑。GPT-5.6 三档之间 25 倍的价差,只有配上任务级的编排机制才有意义——如果所有子任务都只能跑在旗舰模型上,分层定价对用户就只是账单而不是工具。OpenAI 还在推动用户进入这套分层:官方已确认 GPT-5.4 和 GPT-5.4 mini 将于 8月31日从 ChatGPT 登录的 Codex 中退役,指定替换者正是 Terra 和 Luna。对照竞品,Claude Code 早已支持按子代理配置模型,Gemini CLI 则一直把 100 万 token 上下文作为卖点,Codex 这两项开放也是在补齐被对手先占住的能力位。 对重度 Codex 用户来说,这是好消息:百万上下文有了官方认可的自助通道,多代理有了明确的省钱旋钮。对指望"默认配置就是最强配置"的用户,官方已经把话说得很明白——默认值会继续按性能和成本保守调优,想要更强的能力需要自己动手,也自己承担代价。至于 100 万 token 上下文在 Codex 实际会话中的表现,目前尚无第三方实测数据,这一点只能留待使用者自己验证。
 AI 速览