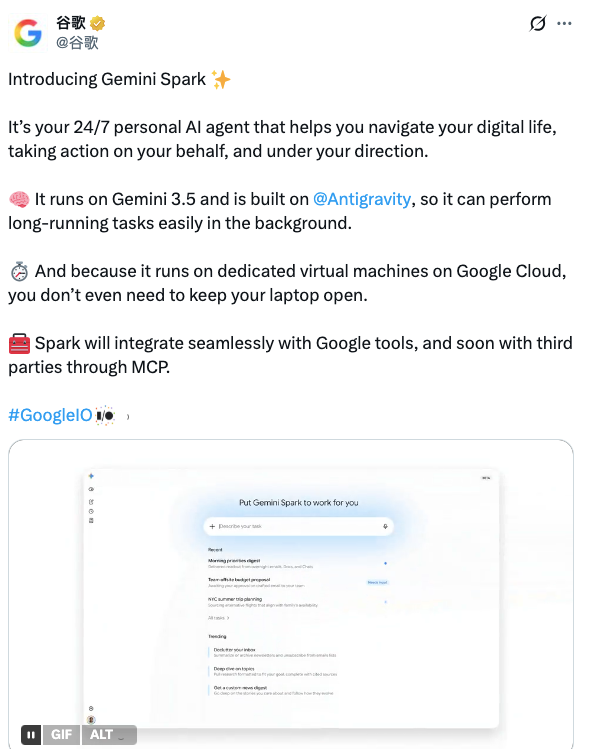
5月20日消息,Google 在 I/O 2026 推出个人智能体 Gemini Spark,基于 Gemini 3.5 模型与 Google Antigravity 的 agentic harness 构建,运行在 Google Cloud 专用虚拟机上,在用户关机或合上笔记本期间也能持续执行长链路任务。Spark 本周向受信任测试者开放,下周面向美国 Google AI Ultra 订阅者(100 美元/月)开启 Beta,夏末登陆 Gemini App macOS 版,届时支持整理本地文件、把 PDF 内容抽取进 Sheets 等本地操作。 跑在云端 VM 上:与本地 Agent 路线分野
Sundar Pichai 在 pre-briefing 中把 Spark 定义为「下一代数字智能助手」,核心机制是后台持久运行——「它跑在 Google Cloud 上专用的虚拟机里,你不需要让笔记本保持开机来确保它在工作」。这与 Anthropic Claude Cowork 的桌面端代理路线、以及 OpenAI ChatGPT Agent 的浏览器内执行路径形成明确分野:Spark 在用户离线时不依赖本地客户端持续操作,任务状态在云端保留。 Spark 的基座是 Gemini 3.5 模型家族,而 Google 同期推出的 Gemini 3.5 Flash 在 GPQA Diamond 上得分 90.4%、MMMU-Pro 81.2%、SWE-bench Verified 78%,为长链路推理提供底层。agentic 框架则来自 Google Antigravity——后者最早作为 IDE 内的代理工具亮相,这次被抽出来作为 Spark 的执行骨架。
邮件即上下文:Workspace 数据成入口护城河
Google Labs 的 Josh Woodward(Gemini App 与 AI Studio 副总裁)给的示范是写一封状态更新邮件:「Spark 可以从你的邮件、文档、表格和幻灯片里把事实拉出来,直接帮你起草」。其他官方示例还包括自动解析每月信用卡账单找出隐藏费用或新增订阅、监控收件箱里来自孩子学校的更新并抓取截止日期推给用户和伴侣、小企业用来盯收件箱不漏客户问题。
数据访问通过 opt-in 菜单管理,可连接 Gmail、Google Photos、Search、YouTube 历史、Drive、Docs 等服务。Google 同期披露 Gemini App 月活已达 9 亿,意味着 Spark 的潜在数据上下文规模远超纯 AI 创业公司——这是 Pichai 团队反复强调的分发优势的具体落点:别人需要让用户重新授权所有数据源,Spark 默认就已经在用户的邮箱里。
MCP 接入第三方:首批 Canva、OpenTable、Instacart
Spark 起步即支持 Workspace 内的 Gmail、Docs、Slides、Sheets,同时通过 MCP 协议连接外部应用,首批合作扩展到 Canva、OpenTable 和 Instacart。Google 表示未来几个月会继续扩充连接器列表,这条路径与 Anthropic 主推的 MCP 生态形成事实上的合流——Google 没有再造一套协议,而是直接接入开放标准。
Google 给出的 Spark roadmap 包括:与用户通过短信和邮件交互、创建自定义子智能体(sub-agents)、操作用户本地浏览器。其中本地浏览器操作能力对应的是 Claude in Chrome 与 ChatGPT Agent 都在推进的方向,而子智能体能力如果落地,意味着 Spark 不只是单一长流程执行器,而是 Agent 编排框架。
竞品格局:Cowork、ChatGPT Agent 已先发
通用个人 AI 代理这条赛道目前已有 Anthropic Claude Cowork 和 OpenAI ChatGPT Agent 在跑,前者主打桌面端的文件与任务自动化,后者侧重浏览器内执行。Spark 的差异点不在功能列表本身,而在两个结构性条件:一是已经握有用户全部 Gmail、Drive 与 Workspace 数据,启动即有上下文;二是云端常驻 VM 的执行模型,绕开了桌面代理「用户必须开着电脑」的硬约束。
Google AI Ultra 这个 100 美元/月的高阶套餐被一并打包推出,Spark、视频生成模型 Gemini Omni Flash、Deep Research 等高耗算力能力都集中在该层。这个定价与 OpenAI ChatGPT Pro 的 200 美元/月、Anthropic Claude Max 的 100-200 美元/月梯度对齐,Google 通过把 Spark 锁在 Ultra 层,试图把 AI 代理变成订阅升级的明确驱动力。
局限与未开放部分
Beta 阶段仅限美国 AI Ultra 订阅者,其他地区与低层订阅用户没有时间表。Google 没有公布 Spark 的任务成功率、可执行任务长度上限、或并发任务数等关键指标,本地浏览器操作、自定义子智能体、短信邮件交互均处于「即将推出」状态,实际能力边界要等 Beta 跑起来才能验证。
隐私侧,Spark 的 opt-in 菜单意味着用户对每个数据源都需要单独授权,但跨服务数据聚合在一个常驻 VM 里执行,本身就引入新的权限管理与审计需求——Google 没有详细说明任务回溯、操作日志、误操作回滚等机制如何实现。MCP 连接虽然开放,但企业场景下第三方工具的权限边界、敏感操作的人工复核流程也尚未明确。
下一个观察窗口是下周 Ultra 用户 Beta 开放后的真实任务表现,以及夏末 macOS 版上线时,Spark 在本地文件操作上是否会与 Cowork 形成正面对位。
 AI 速览