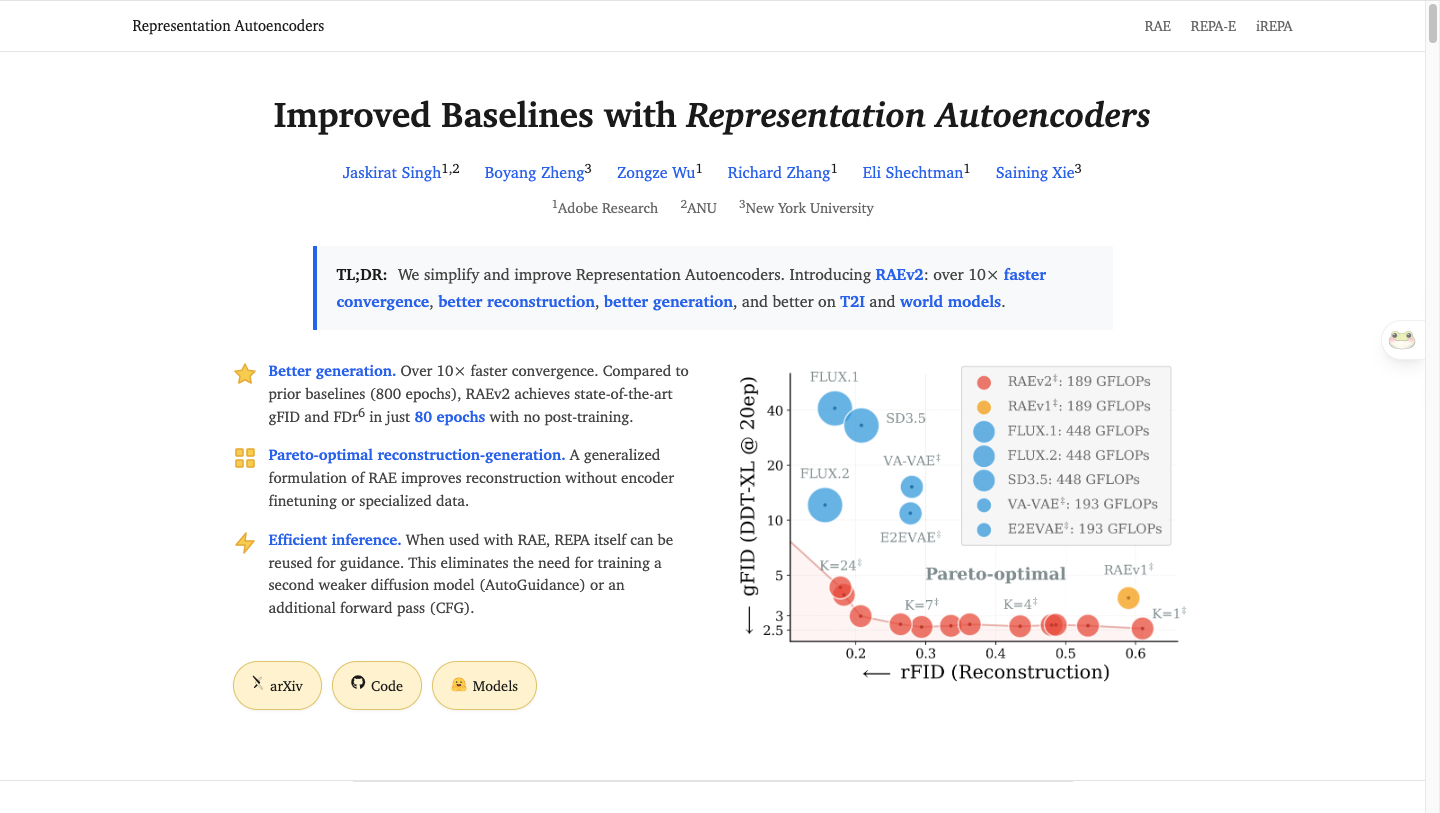
5月18日,纽约大学谢赛宁(Saining Xie)课题组联合 Adobe Research、澳大利亚国立大学(ANU)在 arXiv 提交新论文 Improved Baselines with Representation Autoencoders(编号 2605.18324),正式发布表征自编码器第二代方案 RAEv2。在 ImageNet-256 上,新方案仅用 80 epochs 就将 gFID 推到 1.06,比原版 RAE 提速超过 10 倍;在 FDr^k 指标上,80 epochs 达到 2.17,而此前最优记录是 3.26、需要 800 epochs。对于绝大多数从事潜在扩散模型(Latent Diffusion)、统一多模态、视觉重建工作的团队而言,这是过去半年里最值得复现的一篇基线工作。 RAE 的来路:用 DINOv2、SigLIP 替换 VAE
要理解 RAEv2 的价值,先要看 RAE 解决了什么问题。扩散模型主流路径是 Latent Diffusion,由一个预训练 autoencoder 把像素映射到潜空间,再在潜空间上做扩散;但这个 autoencoder 几乎没有迭代过——大多数 DiT 仍在用 SD-VAE,存在骨干网络老旧、潜空间维度过低(如 32×32×4)、纯重建训练带来表征薄弱等问题。
2025 年 10 月,谢赛宁团队(Boyang Zheng、Nanye Ma、Shengbang Tong、Saining Xie)提出 RAE(arXiv 2510.11690),将冻结的预训练表征编码器——DINOv2、SigLIP2、MAE——直接作为编码器,配一个训练好的 ViT decoder,构成"表征自编码器"。在 ImageNet-1K 上,MAE-B 版本 RAE 的重建 FID(rFID)压到 0.16,相比 SD-VAE 的 0.62;线性探测精度 84.5%,对比 SD-VAE 的 8%——这意味着 RAE 不仅重建更准,潜空间还自带强表征能力。
但原版 RAE 留下了三个明显短板:只用编码器的最后一层、训练慢(需要数百 epochs)、CFG 引导需要训练一个第二弱模型(AutoGuidance)。RAEv2 就是来填这三个坑。
三大改进点逐条拆解
1. 广义表征编码器:把最后 K 层求和当输入
原 RAE 只取预训练 vision encoder 的最后一层输出作为 RAE 表征。RAEv2 提出一个无需训练的通用形式:把最后 k 层特征直接相加作为编码器输出。这个改动不增参数、不调编码器、不需要文本或人脸等专用数据集,重建质量却显著上升;K=1 退化成原版 RAE。实验在 27 个不同编码器(DINOv2、DINOv3、SigLIP 系列)上验证,K=7 附近达到 Pareto 最优,编码器 FLOPs 还降了约一半。
2. RAE 和 REPA 不是替代,而是互补
学界此前普遍认为,既然 RAE 已经用预训练表征当编码器,那么把同一表征蒸馏到 DiT 中间层的 REPA(Representation Alignment)就没必要了。RAEv2 通过大规模实验推翻了这个假设:RAE 与 REPA 工作机制互补,同一组预训练表征既可以当 RAE 编码器,又能作为扩散模型中间层的对齐目标,两者叠加效果优于单独使用。
直观理解:RAE 负责把全局语义注入潜空间,REPA 负责让 DiT 中间层不丢失空间结构。两边都用 DINOv2 当锚点,是个非常优雅的统一。
3. REPA 自带"免费引导",CFG 推理成本砍半
原 RAE 在 classifier-free guidance(CFG)上表现不佳,需要额外训练一个较弱扩散模型来做 AutoGuidance。RAEv2 的洞察是:REPA 头本质上就是 RAE 潜空间里的一个 x-预测器,只要把 DiT 的输出头重参数化,REPA 头自身就能提供引导信号。
这个改动意味着推理时不需要再跑一遍弱模型来做 CFG,NFEs(神经网络前向次数)直接减半,部署成本大幅下降。
Benchmark 数据:哪些指标领先
ImageNet-256 上的核心成绩(领先项):
- gFID:1.06 @ 80 epochs——SOTA,原 RAE 需要 800+ epochs 才能逼近
- FDr^k:2.17 @ 80 epochs——SOTA,旧最佳 3.26(800 epochs)
- EP_FID@2:35 epochs——达到无引导 gFID ≤ 2 所需训练轮数,原 RAE 是 177 epochs
论文还提出了一个新指标 EP_FID@k(达到无引导 gFID ≤ k 所需的 epochs 数)作为训练效率的衡量基准。这个指标对工程团队尤其友好——之前比 FID 数字大家都在卷长 epochs,EP_FID 把"训练成本"这一维度显式化。
落后或未公开的部分
需要诚实指出的几点:
- 论文重点验证 ImageNet-256 和文本到图像生成,ImageNet-512 高分辨率上的对比数据论文摘要中未直接给出,需要看正文表格
- 在文本到图像生成和导航世界模型(Navigation World Models)两个非分类场景下,论文称"持续改进",但具体 gFID 数字摘要未列出
- 编码器层数求和虽然不增参数,但 K=7 附近的最优值在不同骨干上是否稳定,需要看完整消融表
- 与同期工作 FlatDINO(arXiv 2602.04873,用 32 个连续 token 压缩 DINOv2 patch grid,DiT-XL 在 ImageNet 256×256 上 gFID 1.85,FLOPs 减少 8 倍)的直接对比未在 RAEv2 摘要中出现——两条路线("加层求和"vs"压缩到 32 token")的选型尚待社区横评
与同期路线的横向对比
| | | |
|---|
| | | |
| DINOv2/SigLIP2 最后一层 + ViT decoder | | |
| 最后 K 层求和 + RAE/REPA 互补 + 重参数化引导 | | |
| 把 DINOv2 patch 压到 32 token | | |
| RAE 路线扩展到 T2I(SigLIP-2 + 1.5B DiT) | | |
谁应该跟进 RAEv2
强烈建议立刻复现:从事 DiT 训练、潜在扩散基础设施、原生多模态(理解+生成统一)、视觉 tokenizer 设计的团队。10 倍训练加速直接砍掉算力账单。
值得阅读不必抢跑:做 T2I 应用层、做 prompt 优化、做后训练对齐的团队。底层基线变更对你影响有限,但理解"为什么 K 层求和有效""为什么 REPA 和 RAE 互补"对未来选型有帮助。
可以观望:训练数据资源有限的小团队。RAE 路线对预训练编码器(DINOv2、SigLIP2、DINOv3)依赖较强,自有数据微调收益不及顶部厂商。
实操建议:代码已在项目主页 raev2.github.io 公布,可以先在 DINOv2-B 上跑 K=7 的设置,复现 80 epochs gFID 1.06 这条曲线;再叠加 REPA 中间层对齐,看 EP_FID@2 能不能在自己的数据集上压到 35 epochs 附近。如果业务在 T2I 场景,可以同时关注 Scale-RAE(arXiv 2601.16208),它把 RAE 路线扩展到了 1.5B SigLIP-2 + 2.4B DiT 的工业级规模。
从 2025 年 10 月原 RAE 提出,到 2026 年 1 月 Scale-RAE 走通 T2I,再到 5 月 RAEv2 把训练效率推到新基线,半年时间,"用强预训练表征统一理解与生成"这条路线已经从论文级 demo 走到了工程可用阶段。下一个值得观察的问题,是它能否取代 SD-VAE 成为下一代 DiT 的默认 tokenizer。
谢赛宁简介
谢赛宁(Saining Xie),华人计算机科学家,当前的双重身份是 AMI Labs 联合创始人兼首席科学官(CSO) 和 纽约大学(NYU)柯朗研究所计算机科学助理教授(休假中)。AMI Labs 是他 2026 年与 Yann LeCun 共同创办的世界模型公司,今年 3 月完成 10.3 亿美元种子轮融资,目标是做"超越大语言模型"的世界模型。
履历
- 2018 年:UC San Diego 计算机科学博士,导师屠卓文。读博期间在 NEC Labs、Adobe、Facebook、谷歌、DeepMind 实习
- 2018–2022 年:Facebook AI Research(FAIR)研究科学家,4 年
- 2022 年:从 Meta AI 离职加入 NYU 任 CS 助理教授
- 后续:曾在 Google DeepMind GenAI / nanobanana 团队任研究科学家
- 2026 年:与 Yann LeCun 联合创办 AMI Labs,NYU 暂时休假
代表性工作
技术线索很清晰——从骨干网络到表征学习,再到生成模型,最后落到世界模型:
| | |
|---|
| | |
| MAE(Masked Autoencoders,与何恺明) | |
| | |
| DiT(Diffusion Transformers,与 Bill Peebles) | |
| | |
| | |
| RAE(Representation Autoencoders) | |
| | |
| | |
需要澄清的是,2024 年 Sora 发布后,曾有传闻把谢赛宁说成"Sora 发明者之一",他本人朋友圈辟谣:Sora 是 Bill Peebles 领导的 OpenAI 团队的工作,他没有参与开发。但 Sora 用的 DiT 架构确实是他和 Bill Peebles 合作提出的,Bill 当时还是他在伯克利时的合作博士生。
学界影响
Google Scholar 引用量 10.5 万+。培养和合作过的学生/实习生现在分布在 AI 各个一线团队:
- Bill Peebles:OpenAI Sora 负责人
- Sanghyun Woo:Google DeepMind(nano banana)
- Boyang Zheng、Nanye Ma、Shengbang Tong:RAE 系列共同作者,NYU 在读
- Xichen Pan、Ellis Brown:Meta AI / NYU
荣誉
- 2023 年 MIT《麻省理工科技评论》"35 岁以下科技创新 35 人"中国入选者
- 2025 年 CVPR 青年学者奖(Young Researcher Award)
当前研究主张
他公开的研究主张是:"人和动物的知识来自感官经验与环境交互。要达到人类水平的智能,需要超越纯语言系统,转向直接从连续真实世界感知输入学习的世界模型——能够理解、创造、推理、规划,并对物理世界形成常识。"
这条路线在产品上落地为 AMI Labs 的世界模型方向,在学术上则体现为两条主线:视觉表征统一(RAE 系列)和空间智能/世界模型(Cambrian-S、Solaris)。RAEv2 本质上是为这条路线服务的基础设施——把扩散模型潜空间的 tokenizer 换成预训练表征编码器,让"理解"和"生成"用同一套语义。
 AI 速览