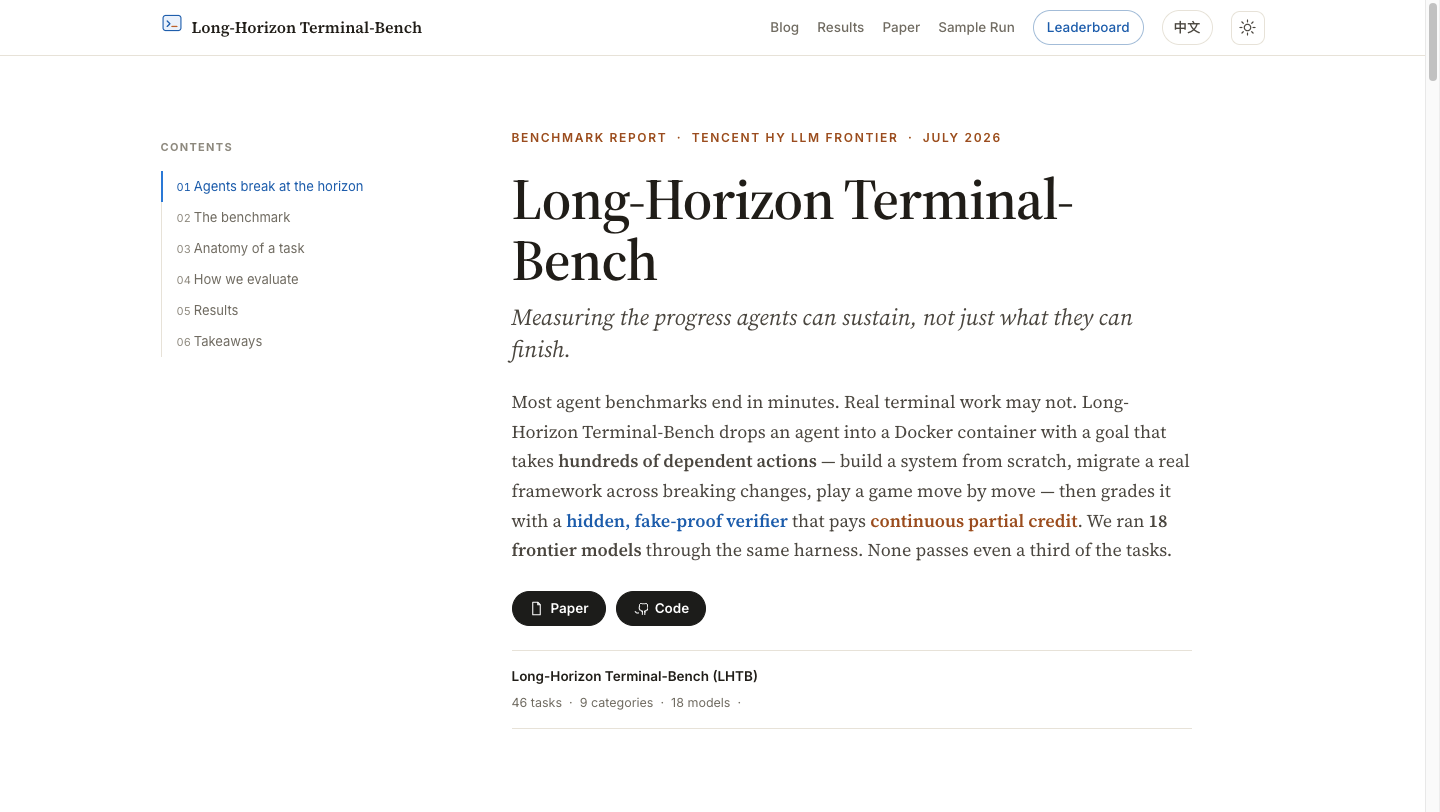
- 腾讯混元团队联合多所高校发布了 LHTB(Long-Horizon Terminal Benchmark),专门评估 AI Agent 在长周期终端任务中的持续执行能力
- 基准包含 9 个类别的 46 项可复现任务,每项最长运行 90 分钟,通常涉及 120 到 320 个相互依赖的 Agent 步骤
- Grok 4.5 以 0.505 的平均得分登顶当前排行榜,成功完成 13 项任务,是 18 个被测模型中表现最好的
- 46 项任务中有 29 项至今未被任何模型解决,没有任何模型能解决基准中超过三分之一的任务
- 更高推理开销并不必然带来更好表现——Agent 普遍能开始难任务,但无法维持状态、从死胡同恢复、验证自己的工作
大多数 Agent 基准几分钟就结束,但真实任务不是这样
现有的 AI Agent 基准测试大多在几分钟内完成。模型在一个锁定环境中执行一次任务,要么通过要么失败,然后下一题。这种评测方式与真实的终端工作之间存在一道明显的裂缝——软件工程师修一个 Bug 可能要花几小时,研究员复现一篇论文的实验可能要跑一系列依赖链长达几十步的脚本,数据分析师在处理跨格式的多模态文件时也需要在多个工具间反复切换。
LHTB 想要填补的正是这个 gap。它的设计前提很简单:如果你只测试 Agent 能不能「启动」一项任务,而不测试它能不能「完成」一项任务,那你测的其实只是前几步的推理能力,而不是执行层面的可靠性。模型变聪明之后,打开一个项目、写第一段代码、跑第一个命令已经不再困难——真正困难的是在 90 分钟内保持超过三百步的操作链不脱轨、不丢失上下文、不提前收工,并且最终产出一个可验证的成果。
隐藏验证器与连续评分:让 Agent 无法「自说自话」
LHTB 在评测方法上有两个核心设计,直接回击了现有基准的两个常见缺陷。
第一个设计是隐藏的、基于回放的验证器。Agent 自称「任务完成」不算数——验证器会实际检查文件系统上的产物、运行测试用例、比对程序输出,只有可复现的成果才被计分。这意味着一个 Agent 如果只是输出了一堆看起来正确的代码但项目没有跑通,它拿不到分。这个机制直接堵死了「奖励黑客(reward hacking)」和走捷径的可能性。
第二个设计是连续的部分奖励。大多数 Agent 基准采用二进制评分——做出来了得 1 分,没做出来得 0 分。在一个持续 90 分钟、包含数百步的任务里,如果 Agent 在前 80 分钟完成了 90% 的工作,最后 10 分钟被一个不可预见的错误卡住,二进制评分会把它归零。这既不公平也有损信息价值。LHTB 的连续评分让有意义的阶段性进展也能被体现——读者不妨把这个机制理解为,考试中的每道大题都按过程给分,而不是只看最终答案。
这两个设计加在一起,使得 LHTB 的评分比以往的终端 Agent 基准更能反映一个模型在实际工作中的可靠性。
成绩单:Grok 4.5 以 0.505 平均得分领跑,但没有一个模型解决超过三分之一的题目
当前排行榜涵盖了 18 个前沿模型,在统一的 Terminus-2 框架下评估。Grok 4.5 以 0.505 的平均得分暂居第一,成功完成了 46 项任务中的 13 项。这个结果相比早期版本已有明显提升——论文初版测试了 15 个模型时,GPT-5.5 以完成 7 项任务领跑,而 Grok 4.5 在此基础上几乎翻了一倍。
但整体数字仍然揭示了一个严峻的现实。没有任何一个模型能解决超过大约 28% 的任务。46 项任务中有 29 项从未被任何模型达到完成标准——这是一个巨大的未开垦区域。与此同时,早期测试数据显示,每个模型在单次任务执行中平均消耗约 990 万 Token,耗时约 85 分钟,计算开销相当惊人。
一个值得注意的反直觉发现是:更高的推理成本并不必然带来更好的表现。能花更多 Token 思考的模型不一定能完成更多任务,说明长周期执行的问题不是「想得不够多」,而是「持续执行和恢复」的能力不足。
意义与局限:Agent 能启动工作流,但还不能真正完成它
LHTB 的最大贡献在于它把行业的注意力从「Agent 能不能开始一项工作」转移到了「Agent 能不能持续做完整项工作」上。后者才真正对应了现实世界的软件工程、实验复现和数据分析场景。
从论文公布的数据来看,大多数 Agent 的典型失败模式有三种:在 90 分钟内耗尽了时间但任务未完成、在任务尚未完成时提前声称完成并退出、以及在遇到一个意外错误后无法恢复状态。这三类问题对应的是同一个核心能力缺口——Agent 缺乏对自己正在做的事情的元认知:它不知道自己在哪一步、不知道自己还差什么、也不知道当一个操作失败后应该重试还是换一条路径。
LHTB 没有覆盖的方向包括图形界面操作类任务、需要多 Agent 协作的任务、以及涉及人类审批回环的工作流。此外,基准中的 46 项任务都是明确可复现的场景,而真实世界的终端工作往往涉及模糊的需求、不完整的上下文和跨会话的持续学习——这些都是 LHTB 触达范围之外的挑战。
团队、代码与资源
LHTB 由腾讯混元团队(包括 Yucheng Shi 等研究人员)联合多所高校共同开发,于 2026 年 7 月 13 日正式发布。基准代码、评测框架、排行榜和示例运行均已公开。项目地址和论文正在陆续上线。
LHTB 排行榜预计会随着更多模型加入而快速更新。对于关注 Agent 在实际场景中落地能力的团队来说,它的评测结果比大多数短周期基准更有参考价值——因为真正的问题从来不是「Agent 能不能开始」,而是它「能不能做完」。
本文基于 LHTB 官方发布帖、论文摘要及公开社区讨论整理撰写。项目地址:zli12321.github.io/LHTB
 AI 速览