GPT-5.5 在 2026 年 4 月底正式推出,如果你只是在等一个"更会聊天"的模型,那可能要失望了。但如果你在用 Codex 做真实开发,这次更新值得好好看一下——它的变化集中在一件事上:更能把一个复杂任务从头推进到尾,而不是帮你写几段代码就算完。
Terminal-Bench 2.0:最值得 Codex 用户关注的一项
很多人习惯拿写代码片段的质量来评价 AI 模型,但这其实不太准确。真实开发通常是这样的:打开项目,理解结构,找相关文件,安装依赖,跑测试,看到报错,定位原因,改代码,再跑测试,再处理边缘问题。
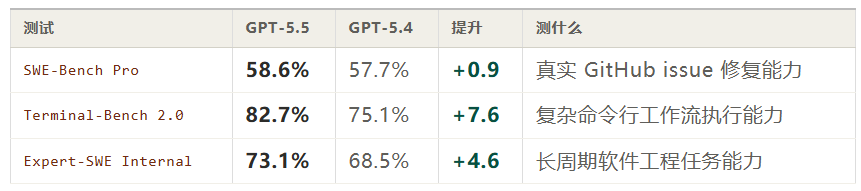
Terminal-Bench 2.0 测的正是这种复杂命令行工作流,GPT-5.5 从 GPT-5.4 的 75.1% 提升到了 82.7%。SWE-Bench Pro(真实 GitHub issue 修复)从 57.7% 升到 58.6%,Expert-SWE 内部测试从 68.5% 升到 73.1%——后者的任务中位完成时间大约是 20 小时,这不是随便一个 demo 能覆盖的难度。
对你来说,这意味着如果只是让 Codex 写个 util 函数,差距不会特别明显。但如果是修 bug、重构、补测试、排查 CI、理解大型代码库,GPT-5.5 才更容易体现价值。
长上下文:不是"塞更多文件",而是"还能不能追踪关系"
很多人理解长上下文,只停留在"可以放进去更多内容"。但真正重要的是放进去之后,模型能不能维持结构感。
Graphwalks 测试模拟的是大型代码库里的真实问题——在复杂关系网络里找路径、追踪依赖、定位来源。GPT-5.5 在 1M token 级别的 Graphwalks BFS 测试上,从 9.4% 直接拉到 45.4%,提升幅度相当明显。
MRCR v2 的数据也有意思。GPT-5.5 在 16K–128K 区间反而略低于 GPT-5.4,但 128K 之后开始反超,到 512K–1M 这个区间,从 36.6% 提升到 74.0%。也就是说,如果你的任务是处理 monorepo、多模块系统、历史包袱重的大型项目,这个差距才会真正显现出来。
工具调用:这才是 agent 能不能用的关键
Codex 不只是个聊天框,它要读文件、调命令、跑测试、检查结果、用外部工具——任何一步不稳,整个任务都会失败。
MCP Atlas 测试(测模型使用 MCP 工具生态完成任务)从 70.6% 升到 75.3%,Tau2-bench Telecom(多轮业务流程处理)从 92.8% 升到 98.0%,BrowseComp 也小幅提升。
MCP 这个方向尤其值得关注。未来 Codex 不只是看仓库,而是可能连接数据库、日志系统、GitHub issue、CI/CD、文档库、监控系统。GPT-5.5 的工具调用提升,实际上是在强化一个方向:模型不只是知道答案,而是知道该用哪个工具,把任务继续往前推。
不只是程序员的工具
独立开发者或技术产品人,日常其实不只是写代码,还要处理需求文档、数据报表、竞品分析、发布说明、财务表格。GPT-5.5 在 GDPval(44 类职业知识工作)上升到 84.9%,FinanceAgent v1.1 升到 60.0%,这些测试的提升说明它在"代码之外、产品必须完成"的工作上也更能派上用场。
ARC-AGI-2 从 73.3% 到 85.0% 也值得注意——这个测试评估的是模型面对陌生规则、陌生模式时能不能从少量样例里推出规律。
对你的意义是:碰到陌生业务逻辑、奇怪的报错模式、没见过的框架结构,GPT-5.5 更可能自己推出来"这里在按什么规则运行"。
价格和怎么用
GPT-5.5 的 API 定价是 30/1M 输出 token,GPT-5.5 Pro 是 180。确实比 GPT-5.4 贵,但要不要用不能只看单价,要看一次任务的真实成本:是否少重试,是否少返工,是否少人工接管,是否一次跑通测试。 如果你想测它到底值不值,别用"帮我写个登录页面"这种 prompt。给它一个真实的失败测试,让它定位原因、修改实现、重新验证;或者让它做跨文件重构,要求保持现有行为不变、更新相关类型和测试;再或者描述一个用户反馈的真实 bug,让它从页面、API、状态管理、后端日志入手一路找下去。这类任务才能看出 GPT-5.5 是不是真的对你的工作有用。
对于已经在用 Codex 做真实项目、经常修 bug 跑测试做重构的人,GPT-5.5 这次升级的方向是对的。它不是更聪明了,是更能干完一件事了。
 AI 速览