7月20日消息,AI 记忆基础设施公司记忆张量(MemTensor)完成亿元 Pre-A 轮融资,由华为哈勃、荣耀战投、商汤国香资本、深创投、和玉资本共同投资。此前,公司于 2025 年完成近亿元天使轮,投资方为孚腾资本、算丰信息、中金资本,云岫资本担任独家财务顾问。两轮融资合计规模接近两亿元。这家成立于 2024 年 11 月的上海公司,切入的是大模型从"单次对话工具"走向"长期运行 Agent"过程中的一个结构性缺口:如何让 AI 系统拥有可管理、可更新、可审计的长期记忆。投资方阵容中同时出现终端硬件方(华为哈勃、荣耀)和 AI 平台方(商汤),指向端侧记忆和云端记忆的双线需求。
两轮融资间的变化:从天使阶段的数千万签约到产业资本入局
记忆张量天使轮于 2025 年中完成,彼时公司已实现数千万元商业化签约,覆盖金融、工业、通信等领域,并与阿里云、华为云建立了合作关系。据科技日报 2025 年 6 月报道,天使轮完成时公司仅成立约半年。
本轮 Pre-A 的投资方构成与天使轮有明显区别。天使轮以财务投资人为主,Pre-A 则引入了明确的产业资本。华为哈勃是华为旗下专注于半导体和 AI 基础设施的投资平台,荣耀战投代表终端设备厂商对端侧 AI 记忆能力的需求。商汤国香资本背靠商汤科技的 AI 平台生态。深创投作为国资背景的头部创投机构出现在投资方名单中,通常被视为项目进入政策认可视野的信号。
技术定位:不是 RAG,是面向大模型的记忆操作系统
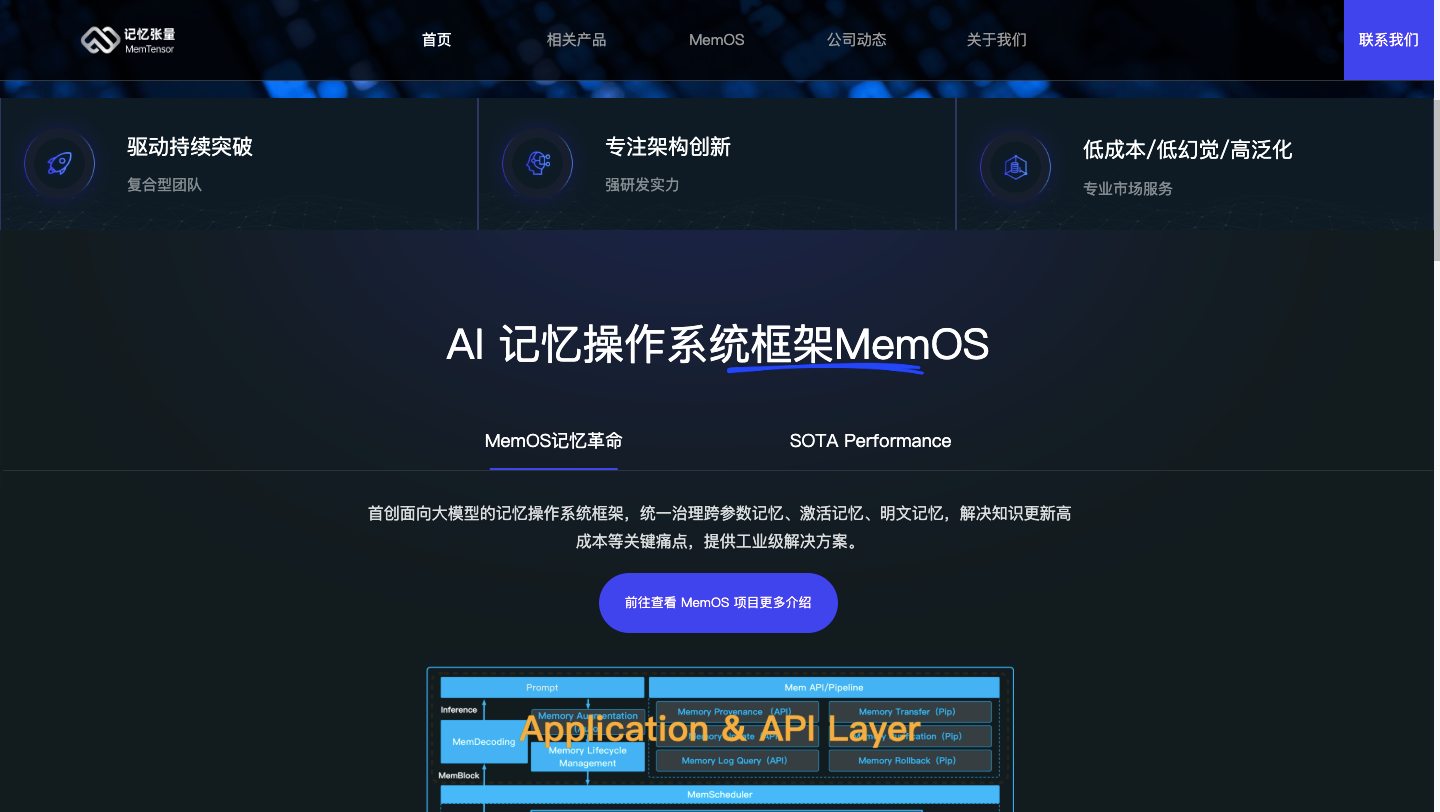
记忆张量的核心产品 MemOS 定位为面向大模型的记忆操作系统。与当前普遍使用的 RAG(检索增强生成)方案不同,MemOS 的设计出发点是将记忆作为系统级资源进行统一管理,而非作为模型推理前的信息检索步骤。
其技术框架建立在团队 2024 年提出的 Memory³ 分层记忆理论之上。该理论将 AI 记忆分为三类:参数记忆(模型权重中内化的长期知识)、激活记忆(上下文和推理过程中的动态状态)、明文记忆(可显式读写和更新的外部事实与经验)。MemOS 通过统一运行时对三类记忆进行调度,使长期状态能够跨任务、跨会话被隔离、复用和维护。
MemOS 已在 GitHub 开源,据 InfoQ 2026 年报道引用的数据,截至 2026 年 6 月项目获得约 9700 个 star,其 OpenMem 开发者社区聚集了超过 1.7 万名开发者。记忆张量创始人熊飞宇在投资界采访中称,MemOS 在涵盖 14 款主流记忆框架的对比测试中综合性能排名第一,在长程复杂 Agent 任务上 Token 消耗量降低近 70%。这些数据来自公司自报,尚无独立第三方复现验证的公开结果。
创始团队:阿里系数据背景加普林斯顿学术资源
创始人兼 CEO 熊飞宇拥有 Drexel University 博士学位,曾任阿里巴巴集团业务中台数据智能负责人及淘宝天猫数据平台负责人,主导构建了千亿级数字商业知识图谱。2023 年 7 月,他在上海算法创新研究院牵头组建大模型中心,Memory³ 分层记忆理论即产出于研究院时期。2024 年 11 月带领团队独立创业。
首席科学家杨泓康毕业于普林斯顿大学,师从鄂维南院士。鄂维南院士同时担任记忆张量首席科学顾问。CTO 李志宇为中国人民大学博士,曾在阿里巴巴和小红书负责算法研发与商业化落地,已入选 36 氪"36Under36"科创者榜单。团队平均年龄不到 30 岁,成员来自普林斯顿、北大、上海交大等高校及大厂。
产业逻辑:Agent 从单次调用走向长期运行,记忆变成硬需求
这笔融资之所以值得关注,不完全是因为金额本身,而是因为它发生的时间点。2026 年上半年,Agent 从概念验证进入产品化部署阶段。当 Agent 执行的任务从"回答一个问题"变成"跨越数天完成多步骤工作流",长期状态管理从一项附加功能变成系统前提。Agent 必须知道任务推进到哪一步、哪些事实已更新、哪些决策已被验证,且错误发生时需要能定位和回滚。这些需求无法靠加大上下文窗口或叠加 RAG 调用来满足。
华为哈勃和荣耀战投的同时出现指向另一条需求线:端侧 AI 记忆。手机、PC、车机等终端设备承载着最连续的用户行为数据。相比每次将原始数据上传云端,端侧记忆可以在本地维护用户习惯和任务上下文,降低延迟和隐私风险。记忆张量称其"记忆原生小模型"已进入端侧硬件场景。
记忆赛道的信号意义和尚未验证的假设
这笔融资的信号意义在于:产业资本开始把"AI 记忆"视为独立的基础设施层级来投资,而不是将其归入某一家大模型公司的附属功能。这与 2024 年的 RAG 热潮不同——RAG 更多被当作大模型应用层的工程优化,而记忆张量试图把记忆定义为与推理引擎平行的系统层。
但这条路径有几个尚未验证的关键假设。第一,独立的记忆基础设施是否能在大模型厂商自身的记忆能力提升面前保持差异化——当 Claude、GPT 等模型的原生记忆功能持续增强,外挂式记忆系统的价值空间可能被压缩。第二,"Token 消耗降低 70%"的效果在不同模型和任务类型上的泛化程度,目前只有公司自报数据。第三,端侧部署的实际效果——在手机等算力受限设备上运行记忆系统的性能表现和用户体验,需要产品级验证。 后续看商业化规模和大模型厂商的自研动向
接下来最值得观察的变量有两个。一是记忆张量的商业化数据能否从天使阶段的"数千万签约"进入亿级 ARR 量级,这决定了记忆基础设施作为独立产品的市场容量是否成立。二是主流大模型厂商在记忆能力上的自研进度——如果 OpenAI、Anthropic 或国内头部模型公司将长期记忆作为模型原生能力大幅强化,独立记忆中间件的定位可能需要重新校准。华为哈勃和荣耀战投的介入意味着端侧落地会是近期最先验证的场景,值得关注搭载 MemOS 的硬件产品何时面世。
 AI 速览