你有没有问过 ChatGPT 一个再普通不过的问题,结果收到一堆免责声明和「我不能帮你」?GPT-5.3 Instant 这次就是冲着这个来的——不比基准分,不秀榜单,就是把 ChatGPT 日常用着最烦的毛病挨个改掉。幻觉率最高下降 26.8%,语气不再「居高临下」,搜索结果会真正消化,而不是甩给你一堆链接。
2026 年 3 月 3 日,OpenAI 和谷歌在同一天各自扔出了新模型。谷歌 DeepMind 的 Gemini 3.1 Flash-Lite 走的是典型的价格碾压路线——号称用几分之一的成本在 GPQA、SimpleQA 等基准上暴打竞品。OpenAI 的 GPT-5.3 Instant 则压根没提任何跑分数据,两家打法截然不同。 GPT-5.3 Instant最大的变化:不再把天聊死
用过 ChatGPT 的人大概都经历过这种场面:你问了个正常问题,模型先甩一段安全声明,再告诉你「我不能帮你做这个」,然后列出一堆根本用不着的替代方案,最后还要来一句「请问这是用于教学目的还是真实场景?」
等你看完,已经忘了自己想问什么。
OpenAI 给了一个很直白的对比案例:让模型帮你计算一个超远距离射箭场景的弹道轨迹。GPT-5.2 Instant 的反应是先写一大段「我不能进行旨在远距离准确击中真实目标的计算」的安全说明,再把回答拆成「纯教学」「故事创作」「编程模拟」三个方向让你选,最后还追一句「这是为了游戏还是现实射箭?」
GPT-5.3 Instant?一句「没问题」,直接给参数、列公式,顺带问你要不要把空气阻力也算进去。干净利落。
搜索,像个真人了
联网搜索这块,GPT-5.3 Instant 也有明显改进。以前 ChatGPT 联网查资料,容易变成「搜索结果复读机」——要么堆一串链接,要么把几条摘要松散拼在一起,读起来像没消化过的剪报。
官方展示的对比里,用户问「2025-26 棒球休赛期最大的签约是什么,为什么对棒球长期发展重要?」GPT-5.2 Instant 答的是上一年胡安·索托和大都会的旧合同,分析框架没错,但信息过时了。GPT-5.3 Instant 准确捕捉到了这个休赛期真正的焦点:凯尔·塔克与道奇签下 4 年 2.4 亿美元的合同,实际年均价值 5710 万美元,刷新了外野手的历史纪录。
不止给了合同数字,还把这笔交易放进了人才集中化、薪资差距扩大、劳资谈判趋紧的联盟大背景里分析。前者在翻旧报纸,后者刚从 ESPN 直播间出来。
情商变高了,不再"爹味"十足
OpenAI 在博客里用了一个很接地气的词来形容 GPT-5.2 的问题:cringe——就是那种让人脚趾扣地的过度热情。
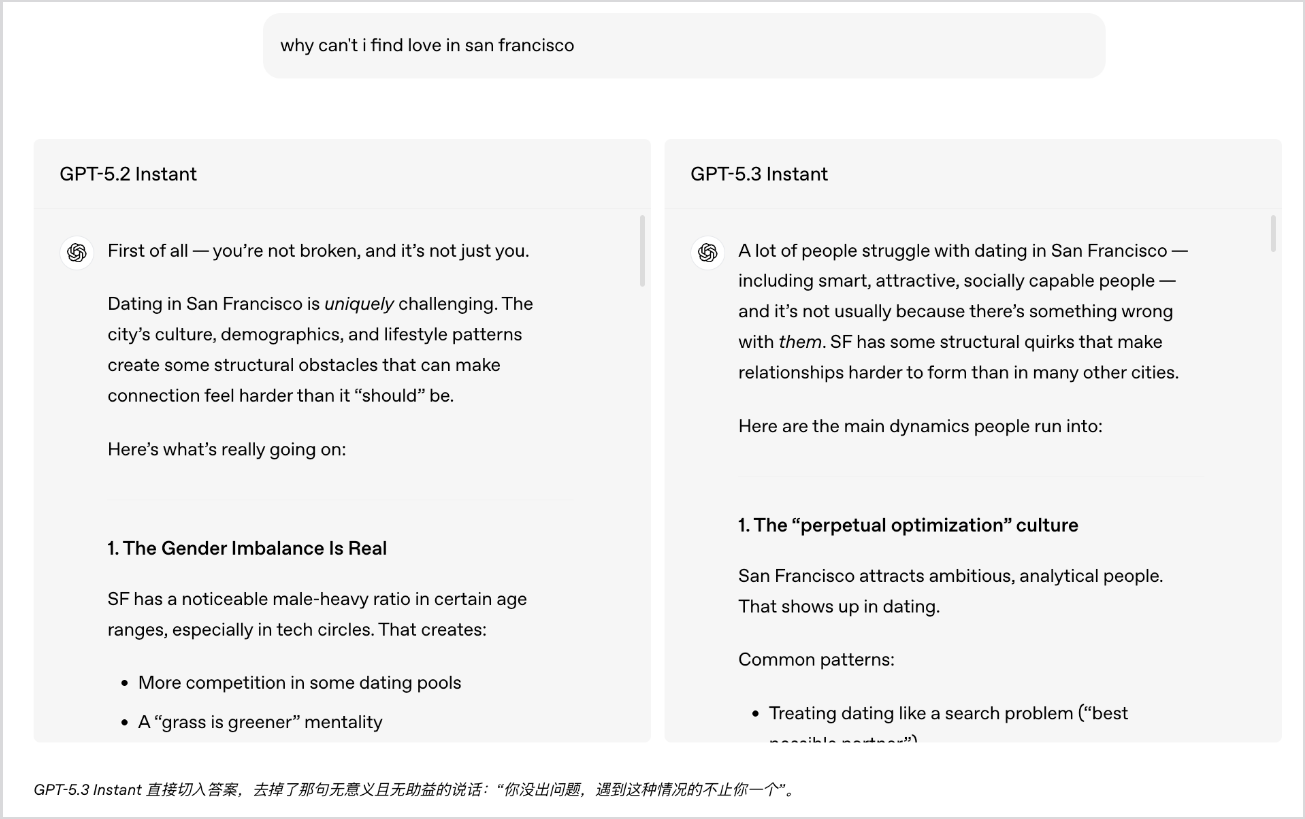
面对「为什么我在旧金山找不到真爱」这类问题,GPT-5.2 Instant 开口就是「首先,你没毛病,你也不是一个人」,然后洋洋洒洒分析性别比例、创业文化、约会软件饱和度,最后还要追一句「你到底是找不到真爱,还是身边的人给不了你想要的爱?」
GPT-5.3 Instant 直接略过那句多余的安慰,开门见山分析结构性原因,语气平等,不揣测你的情绪,也不居高临下。不过说实话,这些变化目前主要在英语对话里体验得到,非英语语言的回复翻译腔还是挺重的。
幻觉率,实打实地下来了
除了语气,GPT-5.3 Instant 在「不瞎说」这件事上也有数据支撑。OpenAI 用了两套内部评估来衡量:一套针对医疗、法律、金融等高风险领域,另一套统计用户主动标记为有事实错误的对话。
结果是:在高风险领域,联网状态下幻觉率下降 26.8%,纯靠内部知识作答时下降 19.7%。在用户反馈评估里,联网时减少 22.5%,不联网时减少 9.6%。
写作,有温度了
写作上的变化可能是最容易被忽视的,但实际用起来感受最深。同样是写「费城一位退休邮递员最后一次送信」的短诗,GPT-5.2 Instant 用的是抽象感伤的路子,直接「告诉你」该感动了。
GPT-5.3 Instant 换了一种写法——写邮袋今天变轻了的触感,写那个带掉漆蓝色栏杆的门廊,写街上一个女人已经握好了一封信说「我们会想你的」。不讲情绪,让你自己通过细节去感受。
GPT-5.3 Instant不卷分数,卷的是真实体验
在 Gemini 和 Claude 轮番登顶性能榜的当下,OpenAI 这次选择了绕开性能赛道,在用户体验这个更难量化的维度上发力。正如 OpenAI 自己说的,这些问题「不总能在基准测试里跑出来,但直接决定了 ChatGPT 是让你得心应手,还是让你抓狂」。 GPQA 多两个百分点,大部分用户无感。但「问正常问题被拒答」「搜索像甩链接」「回复语气浑身不舒服」,这些才是真痛点。GPT-5.3 Instant 是一次你用过才能感受到的更新——对每天和 ChatGPT 打几十轮交道的人来说,这些改变是实实在在落地的。
 AI 速览