5月29日消息,腾讯混元发布面向 OpenClaw 的记忆插件 Hy-Memory,定位为长期协作型 Agent 的"第二大脑"。它要解决的不是单轮问答的记忆,而是 Agent 在跨天、跨 Session、长达数周的任务中普遍出现的记忆漂移——判断记不住、被否过的方案又被重新推荐、深层偏好随用随忘。这类问题此前主要由 mem0、Graphiti、Zep 等开源记忆框架在处理,腾讯混元此次入局,意味着国产大厂开始切入这条原本由开源项目主导的赛道。 三层架构:分层记忆 + 双系统 + 演化链
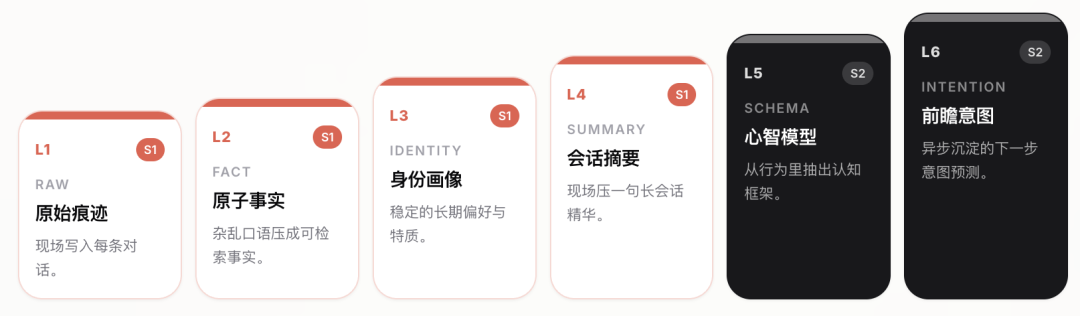
Hy-Memory 的设计由三部分组成。第一层是六层记忆框架,把事实、用户画像、心智模型、前瞻意图等不同形态的信息分层存储,而非像传统方案那样揉成一堆向量统一检索。按官方说法,用户问"我做大决策有什么习惯",系统优先调取心智模型层,而不是把上百轮对话原文一并塞进 prompt,由此降低无关信息对模型注意力的稀释。
第二层借用认知科学的 System1/System2 双系统:System1 在用户发送消息的瞬间实时写入原始痕迹、抽取事实、更新画像;System2 则在后台以秒到分钟级运行,负责构建知识网络、提炼心智模型、预测意图。拆分的原因是深度认知耗时较长——官方称完整跑一遍可能需要 5 到 20 秒,若放在主链路会拖慢响应,因此用后台异步处理把"快"和"越用越懂"两条诉求分开。
演化链:被否决的判断不丢失因果
第三层"演化链"是 Hy-Memory 与现有方案差异最明显的部分。官方用一个健身计划的例子说明:用户半年内经历跑步、HIIT、纯力量、混合训练四次调整,每次都有明确的取舍原因。
只记最新的"覆盖派"方案会丢掉中间的踩坑路径,可能直接推荐用户已经放弃的选项;全部保留、按向量相似度召回的"堆积派"方案,则可能因为受伤记录在语义空间里距离较远而召不回,重新推荐已经致伤的训练方式。Hy-Memory 的做法是用 supersedes 指针把新旧记忆串成一条链,搜索命中链上任意节点时自动展开整条链,最新判断在链头,被替代的旧版本退到链身但不丢弃。这样 Agent 拿到的是完整的态度演变轨迹,而非孤立结论。官方强调,这种回答质量的提升来自记忆结构本身,而非模型能力。
评测与性能:与 mem0、Graphiti 的直接对比
Hy-Memory 在两个长期记忆评测上公布了成绩。LongMemEval 上得分 85.2,官方称在 500 道题覆盖的六个能力维度中有四个取得最高分,其中偏好(+21.11pp)、时序推理(+9.63pp)、知识更新(+21.37pp)三项领先同类;PersonaMem 评测(6000 多条消息、589 道题)官方称打赢所有同类产品。需要说明的是,这些均为官方自行公布的数据,尚未见第三方独立复现。
性能方面,官方给出的对比直接点名 mem0 与 Graphiti:写入速度与 mem0 同档、为 Graphiti 的约 8 倍;记忆条数仅为 mem0 的三分之一、Graphiti 的四到五分之一;单条记忆信息密度为 mem0 的 3 到 4 倍。官方的解释是,在同样的 token 预算下,高密度意味着每次召回的有效信息更多,长 Session 下 prompt 不易被噪声塞满。存储上采用 Chroma 本地嵌入式向量库,数据持久化到本地目录,无需额外部署 Qdrant、Docker 或外部服务。
入局一条开源主导的赛道
Hy-Memory 提供 Lite/Pro/Ultra 三档,共用同一份 SDK,升级仅改一个开关,官方建议初次使用直接选 Pro、高频使用再开启 System2 后台沉淀,一行命令即可安装。
放到整个 Agent 记忆框架格局里看,这一发布的意义大于单个产品本身。长期记忆此前是 mem0、Graphiti、Zep、Letta 等开源项目的主战场,各家在知识图谱、向量召回、记忆压缩等路线上分头探索。腾讯混元以大厂身份带着一套自有架构和一组对标 mem0、Graphiti 的数据入场,既是对这些开源框架的正面竞争,也把"记忆作为 Agent 基础设施"这一判断进一步坐实。当前需要观察的是两点:一是官方 benchmark 能否经受第三方验证,二是这套深度绑定 OpenClaw 的插件在其他 Agent 框架上的可迁移性——后者将决定它是一个生态内组件,还是能成为跨框架的通用记忆层。
 AI 速览