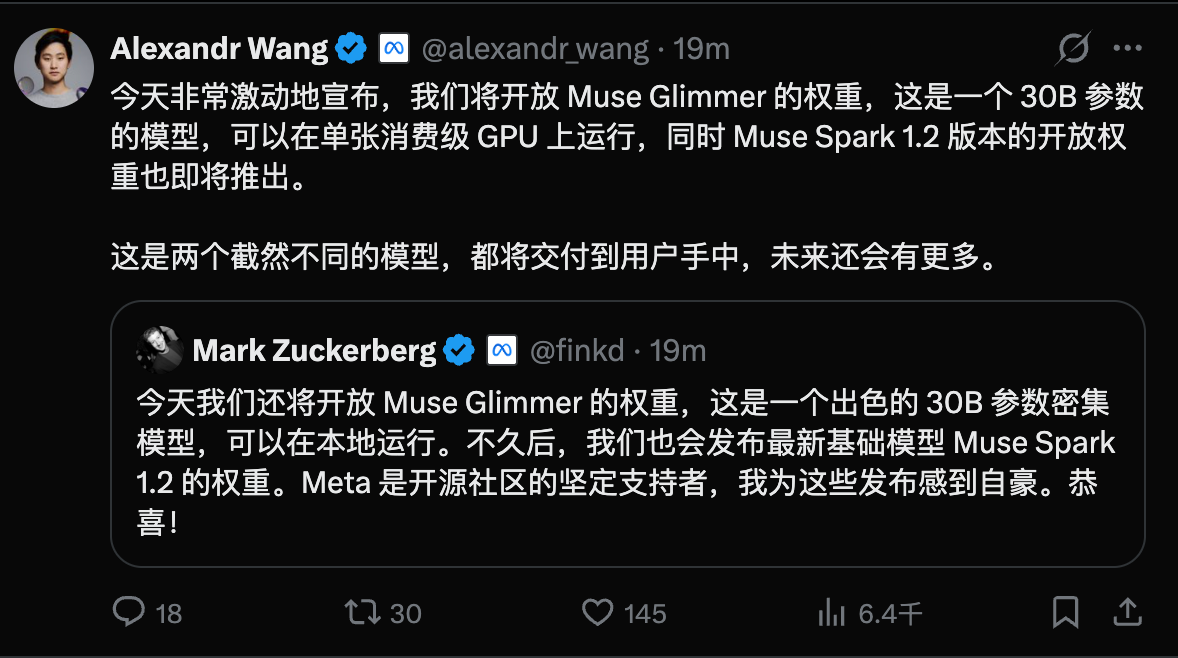
8月10日消息,Meta 今日开源 Muse Glimmer,一个 30B 参数的 agentic 模型,采用 Apache 2.0 许可,权重已上线 Hugging Face。模型面向本地 agent 工作流,约 4-bit 量化后语言模型本体小于 20GB,可在约 24GB 显存的单张消费级 GPU 上运行。这是 Muse 系列首次开源。Meta 首席 AI 官 Alexandr Wang 在 X 上的帖子中同时预告,将发布 Muse Spark 1.2 的开源权重版本。
30B 参数量化进 20GB,24GB 显存跑完整 agent 工作流
Muse Glimmer 由 Meta Superintelligence Labs 训练,官方定位是「始终在线的本地 agent 工作流」。30B 参数在全精度下需要超过 55GB 内存,远超消费级显卡容量。官方用约 4-bit 量化把语言模型压缩到 20GB 以内,余量留给 KV cache、图像感知编码器和推测解码 drafter,整体落在 24GB 或 32GB 显存包络内,并验证了压缩对 agentic 任务的性能几乎无损。
速度方面,Muse Glimmer 内置一个基于 DFlash 的轻量 drafter:小网络整块提议 token,主模型并行验证,接受正确 token、纠正错误 token,比逐 token 生成明显更快,输出质量不变。官方提供了量化版 drafter,并在 MacBook M4-Max、M5-Max 和 RTX-5090 上实测了 17GB 量化模型的速度,结论是可流畅对话与实时 agent 交互。
权重已在 Hugging Face 开放下载,官方同步提供 GGUF 与 Unsloth 变体。Ollama、LM Studio、llama.cpp、MLX、ExecuTorch、vLLM、SGLang、Together AI、Fireworks AI、OpenRouter 等集成将在未来几天陆续落地,AMD、Arm、Dell、Intel、NVIDIA 参与设备端性能优化;开发者还可通过 PyTorch TorchTitan 对模型做定制微调。 蒸馏自 Muse Spark,训练围绕 agent 能力展开
Muse Glimmer 的训练分三个阶段:预训练阶段用 Muse Spark 的输出做 logit 蒸馏,中训阶段加入更长上下文与更密集的 agent 数据,后训阶段结合监督微调、on-policy 蒸馏与强化学习。把旗舰模型的能力蒸馏进小体量,是它能在本地硬件上保持 agentic 性能的关键。
官方公布的能力覆盖端到端 agent 任务,包括 DeepSearch QA、MCP-Atlas、τ-Bench、SWE-Bench 等全流程基准,以及可靠工具调用、多步推理、失败恢复(工具调用失败后诊断并重试)、多模态输入与推理(专用感知编码器,可读截图、图表、文档)、100 多种语言与可调推理强度,并兼容 OpenClaw 等 agent 编排框架。官方对比 Gemma4-31B 与 Qwen3.6-27B 两个同尺寸模型,称 Glimmer 表现领先,具体分数与评测细节见随附技术报告。
Muse 闭源线首次开源:云端旗舰蒸馏,本地模型放权
Muse Glimmer 出自 Meta Superintelligence Labs,该实验室由 Meta 首席 AI 官、Scale AI 创始人 Alexandr Wang 领导。Muse 系列此前一直闭源、只通过 Meta Model API 提供:8 月 5 日发布的 Muse Code 与其底层模型 Muse Spark 1.2 拥有 100 万 token 上下文,同样不提供权重下载。今日 Wang 在 X 上宣布开源 Glimmer,并预告将发布 Muse Spark 1.2 的开源权重版本,目前该版本尚未上线。
开源动作与 Meta 高层的政策表态同一天出现。CEO 扎克伯格同日呼吁美国放宽对开源 AI 的限制,称 Meta 将「很快恢复发布部分开源模型」,并主张蒸馏训练;他点名 DeepSeek、Qwen、Kimi 为开源模型领域的领先者。 把 Glimmer 放进这条路径里看,Meta 开源的是旗舰模型的蒸馏产物,而不是旗舰本身:30B 体量承接 Muse Spark 的 agentic 能力,再以 Apache 2.0 放给个人设备。Muse 线由此从纯 API 服务拆成云端大模型与本地小模型两层。开发者从今天起就能在 Hugging Face 下载一个可在自己显卡上运行、能完成规划与工具调用的开源 agentic 模型;Spark 1.2 开源与各推理引擎的上线时间,仍以官方后续发布为准,目前能确认的是 Glimmer 本体。
 AI 速览