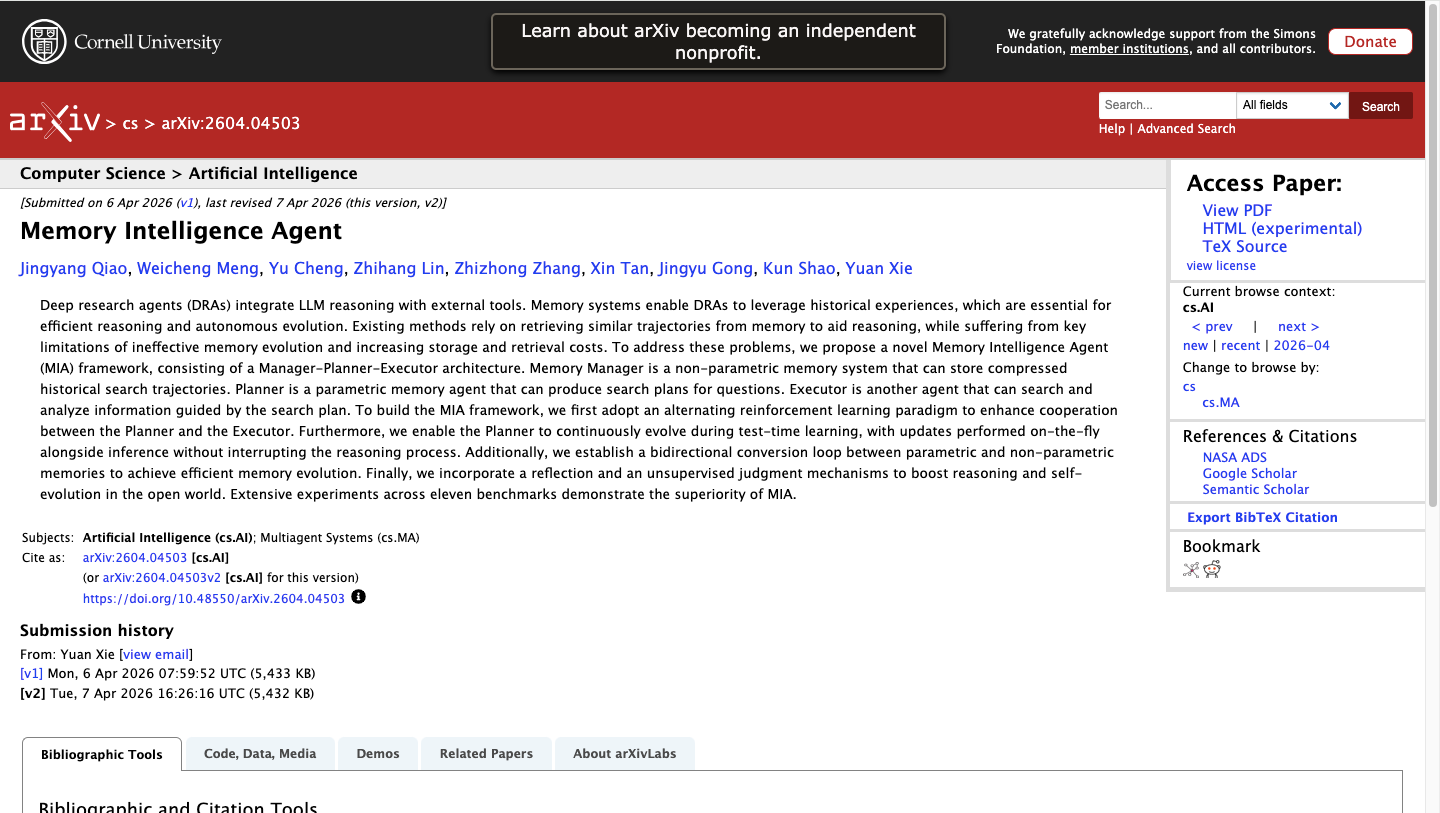
华东师范大学联合上海智能研究院于2026年4月发布Memory Intelligence Agent(MIA),这是一个面向深度研究型Agent的记忆框架,采用Manager-Planner-Executor三层架构,通过交替强化学习联合训练记忆管理、策略规划和任务执行三个模块。在7个多模态和文本问答基准测试中,MIA驱动的Qwen-2.5-VL-7B在非工具调用场景下超过GPT-5.4、GPT-4o和Gemini-2.5-Pro,接近Gemini-3-Flash水平。论文arXiv编号2604.04503,代码和模型已在GitHub开源(MIT协议)。 MIA的核心架构:三层协作替代"记忆堆砌"
当前主流Agent记忆方案的共同问题是:记住了"结果是什么",但不记"怎么得到的"。MIA的设计逻辑是把记忆从被动存储升级为主动策略规划,具体分为三个角色:
**Manager(记忆管理器)**负责记忆的压缩、去重和生命周期管理,解决长期运行中记忆无限膨胀导致注意力稀释的问题。该角色基于Qwen3-32B实现,在训练和推理阶段均承担记忆筛选职责。
**Planner(策略规划器)**是MIA区别于现有方案的关键模块。它不是简单地把召回的记忆塞进prompt,而是根据历史记忆动态生成完整的研究计划——包括搜索策略、工具调用序列和推理路径。Planner支持Continual Test-Time Learning(TTRL),即在推理阶段仍可持续优化策略生成能力。
**Executor(执行器)**基于Qwen-2.5-VL-7B训练,按照Planner输出的研究蓝图调用文本搜索、图像搜索等工具完成具体任务。
三者通过交替强化学习(Alternative RL)分阶段训练:先训练Executor的工具使用和指令跟随能力,再训练Planner的策略生成能力,两阶段均使用GRPO算法,基于VeRL框架实现。
Benchmark表现:7B模型的"越级"成绩单
据论文实验数据,MIA在以下维度展现了显著优势:
跨模型增强效果:在LiveVQA(多模态)和HotpotQA(文本,沙盒Wiki搜索)两个基准上,MIA显著提升了GPT-5.4、Gemini-3-Flash、Claude Sonnet 4.6等SOTA大模型的表现,说明该框架对不同底座模型均有增益。 小模型越级表现:以Qwen-2.5-VL-7B作为Executor,MIA在7个数据集上的综合表现超过GPT-5.4、GPT-4o和Gemini-2.5-Pro(均为非工具调用设定),接近Gemini-3-Flash(非工具调用设定)。这意味着一个7B参数的开源模型在记忆框架加持下,可以逼近甚至超越数量级更大的闭源模型。
记忆框架横向对比:在统一使用Qwen-2.5-VL-7B Executor的条件下,MIA在全部7个数据集上均优于Mem0、A-Mem、Expel、ReasoningBank、Memento等当前主流Agent记忆方案。
需要注意的是,上述"超越"均限定在非工具调用场景,论文未报告闭源模型启用原生工具调用后的对比数据。
和Mem0、RAG、Claude记忆的本质区别
理解MIA的定位需要先厘清当前Agent记忆方案的层级:
**RAG(检索增强生成)**是最基础的方案,将历史信息存入向量数据库,查询时语义匹配召回相关片段注入context。问题在于召回质量依赖embedding和chunk策略,且对"如何使用召回内容"没有任何指导。
Mem0在RAG基础上增加了一层LLM抽取,将对话历史转化为结构化记忆条目(如用户偏好、事实摘要),存储和召回更精准。但其本质仍然是"存-取"模式——召回的记忆直接塞进prompt,由下游模型自行消化,没有策略层。
Claude和ChatGPT的内置记忆与Mem0类似,从对话中自动提取用户偏好和关键事实,下次对话时注入system prompt。这是产品级的用户体验优化,但不改变模型的推理行为——记忆是context的一部分,不参与决策规划。
MIA的差异在于引入了策略维度。它存储的不只是"信息",还包括"获取信息的方法"——哪些搜索策略有效、哪些工具调用序列产出了好结果、哪些推理路径走通了。Planner基于这些策略记忆生成执行计划,而不是把原始记忆丢给Executor自己理解。更关键的是,Planner通过TTRL在推理时仍可持续学习,这意味着Agent在使用过程中会越来越"聪明"。
技术实现细节:训练和部署架构
MIA的训练流程分为两个阶段:
阶段一:Executor训练。基于Qwen-2.5-VL-7B,使用GRPO算法在VeRL框架上训练。Planner和Judge角色由Qwen3-32B担任(未训练,作为环境的一部分)。训练数据包含多模态问答任务,工具集包括本地文本检索(基于wiki25)和图像搜索。
阶段二:Planner训练。固定已训练的Executor,训练Planner的策略生成能力。同样使用GRPO算法,奖励信号来自Executor执行计划后的任务完成质量。
**TTRL(Test-Time Reinforcement Learning)**是MIA的推理时学习机制,分为有监督和无监督两种模式:有监督模式在每个问题回答后获得Ground-Truth反馈,无监督模式则依赖模型自评估。TTRL使Planner在部署后仍可根据新任务的反馈持续优化。
部署方面,完整的MIA系统需要至少3个节点:Node 1部署Qwen3-32B(Manager和Judge),Node 2部署Executor服务和工具链,Node 3运行Planner训练或推理。这对算力要求较高,不适合轻量级场景。
局限性和适用边界
算力门槛高。完整部署需要Qwen3-32B(Manager)+ Qwen-2.5-VL-7B(Executor)+ 训练基础设施,至少需要多张A100/H100级别GPU。对于不需要深度研究能力的简单对话或问答场景,这套架构严重过重。
评测场景有限。当前实验集中在多模态问答和文本问答任务,对于代码生成、长文写作、多轮对话等场景的表现未知。论文中"超越GPT-5.4"的结论限定在非工具调用设定下,与闭源模型启用完整工具链后的差距尚不明确。
记忆冷启动问题。MIA的策略记忆需要积累,在首次使用或面对全新领域时,Planner缺乏历史策略可参考,效果可能退化到接近普通RAG水平。
开源但复现门槛不低。虽然代码、模型和数据集均已开源(MIT协议),但完整训练流程涉及多节点部署、多阶段RL训练、工具服务配置等,对工程能力要求较高。
谁应该关注MIA
MIA适合正在构建需要长期运行、多轮深度研究能力的Agent系统的团队。如果你的场景是:Agent需要反复搜索、对比、验证信息,且历史任务的经验对后续任务有指导价值——MIA的策略记忆机制会比Mem0或纯RAG方案更有优势。
对于只需要基础对话记忆的产品(记住用户名字、偏好),Claude和ChatGPT的内置记忆已经足够,没必要引入MIA的复杂度。对于中等复杂度的Agent,Mem0作为轻量中间件仍然是性价比更高的选择。MIA的价值在"深度研究"这个特定赛道上,这也是论文标题中"Intelligence"的含义——不只是记忆,而是基于记忆的智能规划。
 AI 速览