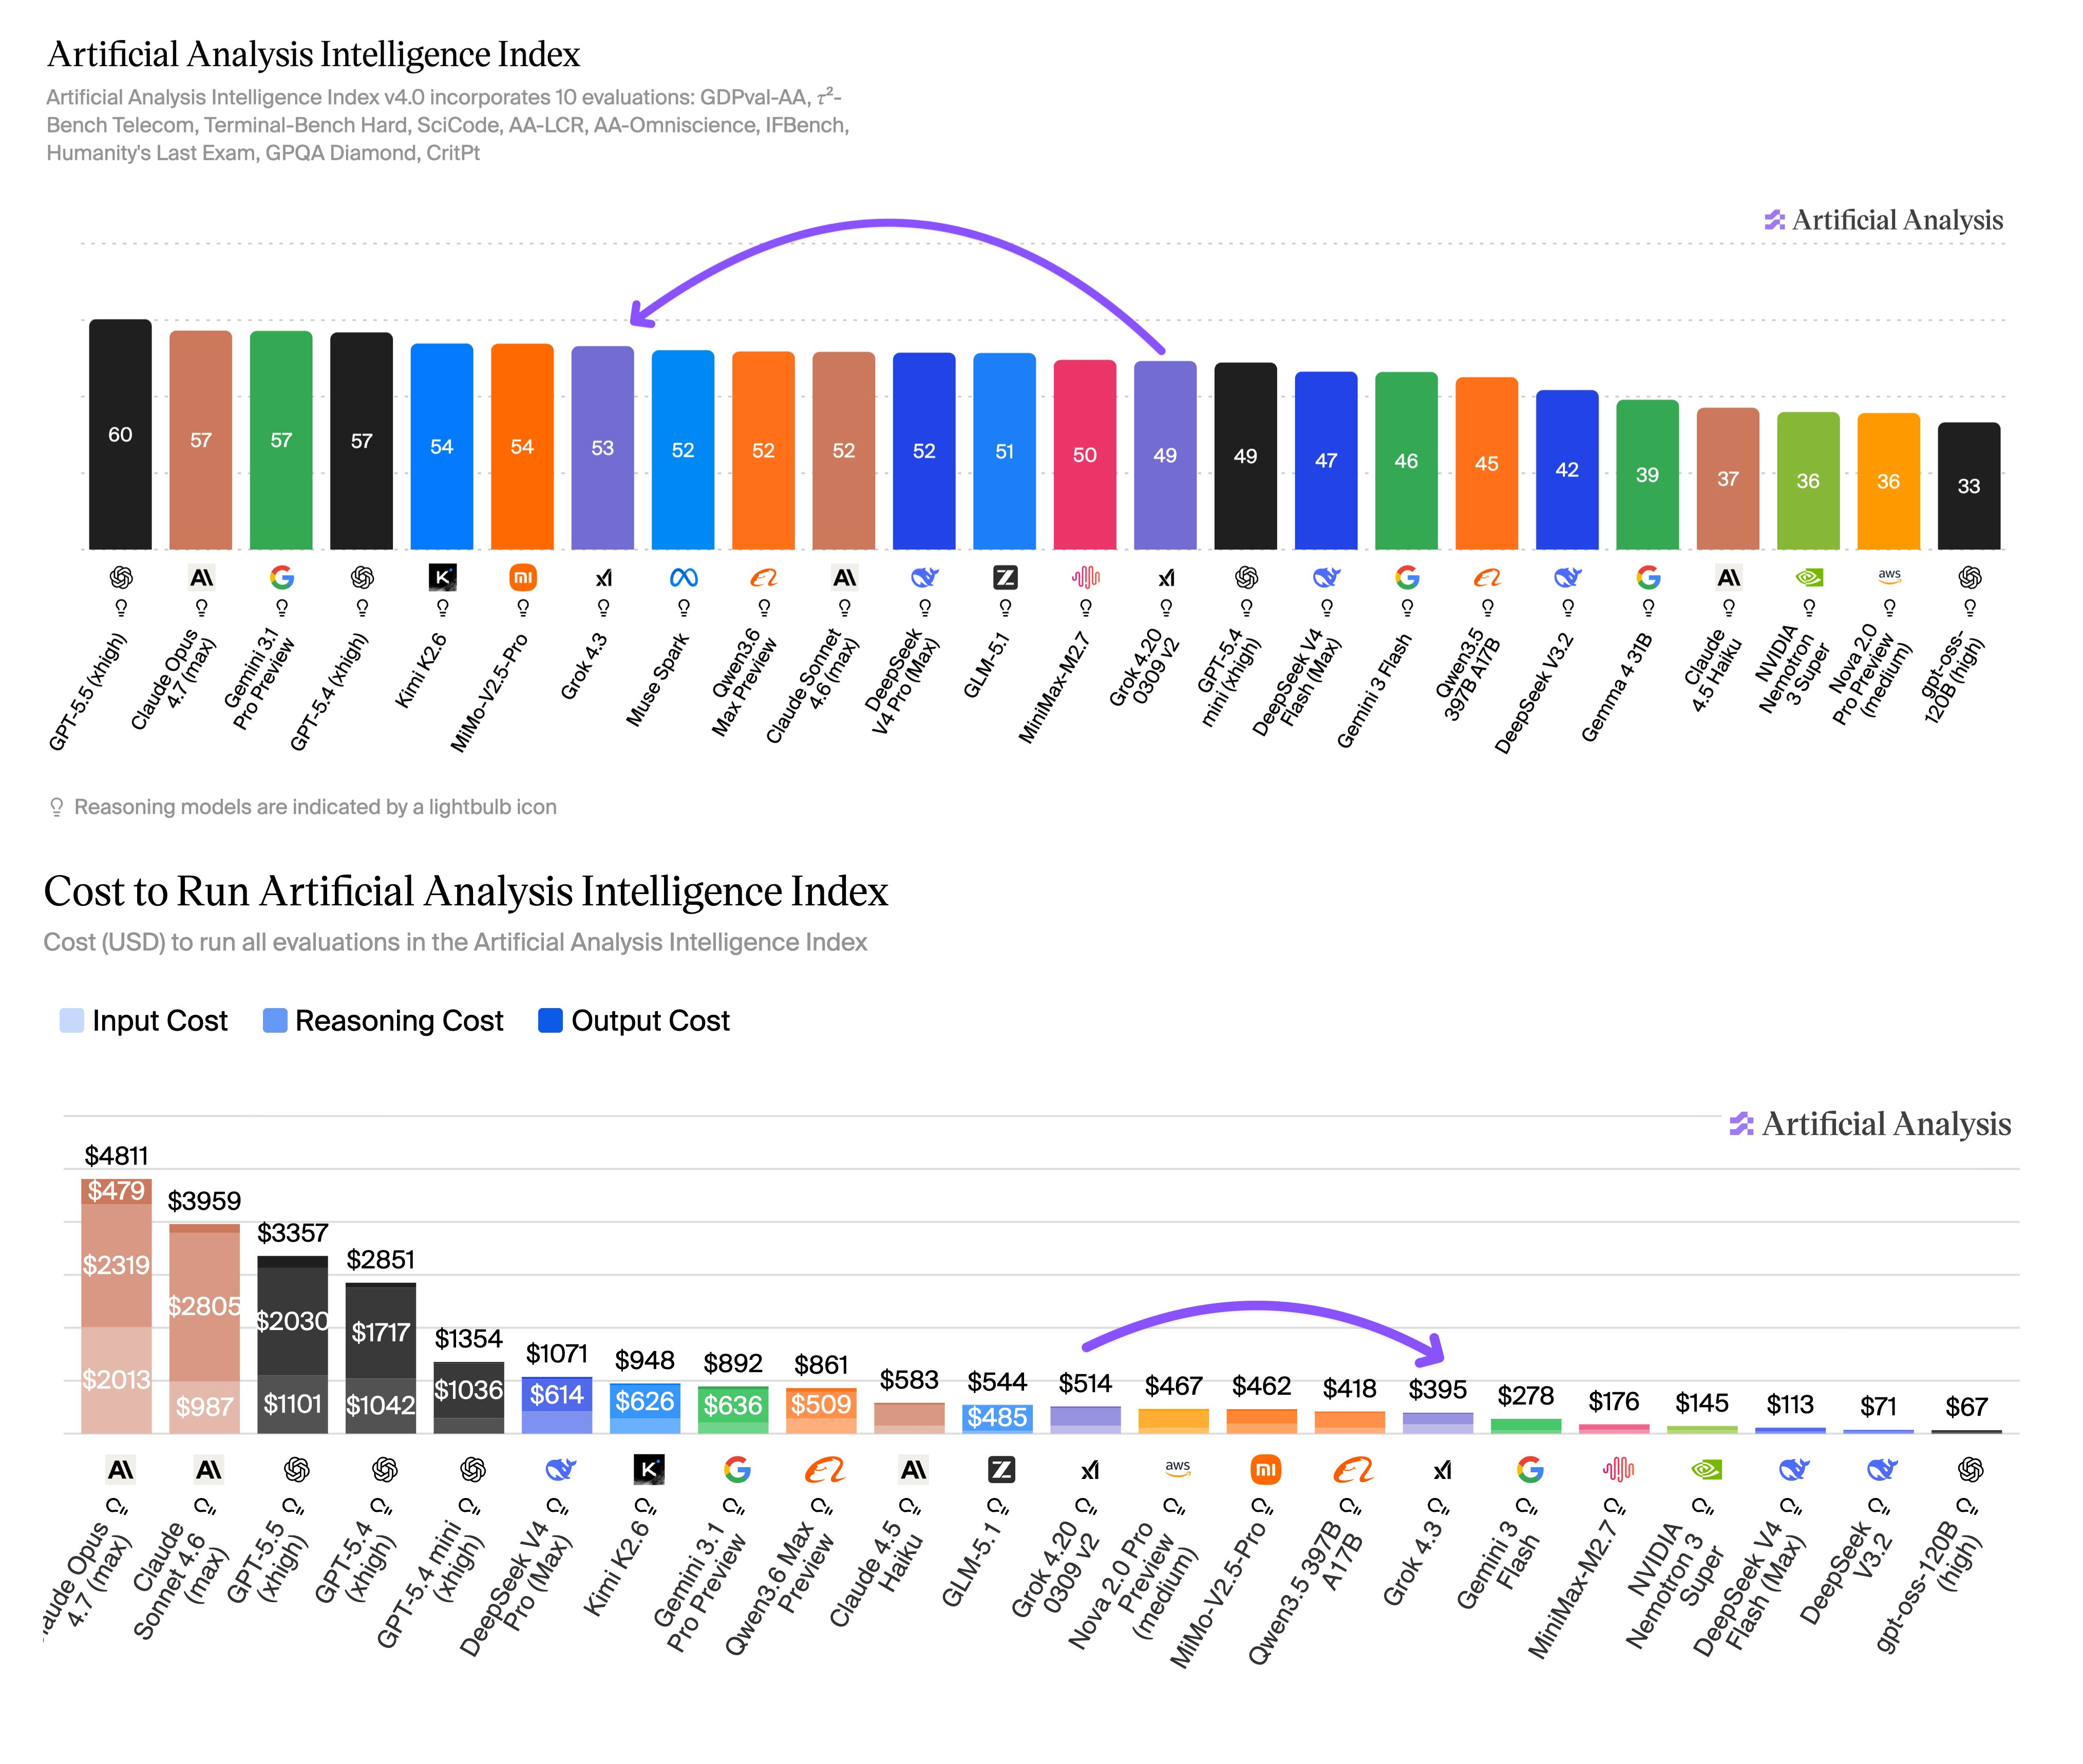
4月30日 Artificial Analysis 发布了完整 benchmark 与定价分析。这是迄今为止外界对 4.3 最完整的第三方评测,本文以此为基准,逐项拆解 4.3 相对 Grok 4.20 0309 v2 的变化,并给出在当前模型梯队中的定位判断。 Intelligence Index 53 分:超过 Muse Spark 和 Sonnet 4.6,与 GPT-5.5 仍有差距
Grok 4.3 在 Artificial Analysis Intelligence Index 上拿到 53 分,比 Grok 4.20 0309 v2 高 4 分,位置略高于 Muse Spark 和 Claude Sonnet 4.6,落在当前闭源模型的中上档。但与头部仍有距离——GPT-5.5(xhigh)在该指数上保持领先,Grok 4.3 在标准 Elo 公式下对其期望胜率约 17%。 更值得关注的是,这次提升是"加分同时降价"完成的,不是堆 token 换分数。
成本效率:跑完整套 Intelligence Index $395,比 4.20 便宜 20%
跑完整套 Artificial Analysis Intelligence Index 评估,Grok 4.3 总成本约 $395,比 Grok 4.20 0309 v2 低约 20%。这一降幅由两个因素驱动:
- 输入 token 价格降 37.5%:从 $2 降至 $1.25 / 百万 token;
- 输出 token 价格降 58.3%:从 $6 降至 $2.50 / 百万 token。
Grok 4.3 跑完整套评估比 4.20 多消耗约 44% 输出 token,但输出单价降幅更大,综合成本仍下降 20%。在评估覆盖的同档模型中,4.3 落在"智能-成本"Pareto 前沿——相同智能档位下没有更便宜的替代品,相同价位档没有更高分数的替代品。
输出长度方面,Grok 4.3 用 token 数量与 Minimax M2.7 接近,比当前多数领先模型更简洁,这意味着在生产环境中实际成本进一步压低。
GDPval-AA 跳涨 321 ELO:Grok 4.3 这次升级的最大单点
GDPval-AA 是这次 benchmark 报告里最显眼的数字。Grok 4.3 在该项 ELO 拿到 1500,比 Grok 4.20 0309 v2 的 1179 跳涨 321 点,这是单项里最大的提升幅度。
GDPval-AA 衡量的是真实 agentic 任务表现。Grok 4.3 在该项目上反超了 Gemini 3.1 Pro Preview、Muse Spark、GPT-5.4 mini(xhigh)和 Kimi K2.5,直接进入第二梯队。距离头部 GPT-5.5(xhigh)仍有 276 ELO 差距,Elo 公式下对其期望胜率约 17%——和 Intelligence Index 总分上的相对位置一致。 对 Agent 产品团队来说,这一项的提升幅度比 Intelligence Index 4 分的变化更具直接意义。
指令跟随与客服任务:τ²-Bench Telecom 98、IFBench 81
agentic 之外,Grok 4.3 在两个细分能力上的数据:
- τ²-Bench Telecom:98%,比 Grok 4.20 0309 v2 提升 5 分,与 GLM-5.1 并列。这一项考察客服类多步对话和工具调用,98% 已经接近天花板。
- IFBench:81%,与 4.20 0309 v2 持平。指令跟随能力没有退步,也没有显著进步。
两项叠加来看,Grok 4.3 在"听话 + 完成多步任务"这条线上仍是当前第一梯队,且没有为换 GDPval-AA 的提升牺牲指令跟随。
事实性的取舍:Accuracy 涨 8 分,Non-Hallucination 跌 8 分
报告里最值得警惕的一组数字出现在 AA-Omniscience 上:
- AA-Omniscience Accuracy:提升 8 分;
- AA-Omniscience Non-Hallucination Rate:下降 8 分。
Grok 4.3 答对了更多问题,但敢答的代价是更敢编。在 Non-Hallucination Rate 这一项上,Grok 4.20 0309 v2 仍排名第一,MiMo-V2.5-Pro 紧随其后,Grok 4.3 与 MiMo 同档。
这是一组对业务选型有直接影响的数据。如果场景对"宁可不答也不能答错"的容忍度要求很高——金融合规、医疗咨询、法律检索、政府服务——Grok 4.20 0309 v2 反而是更稳的选择。如果业务能容忍幻觉、看重完成度,Grok 4.3 在 Accuracy 上的 8 分提升更划算。
同档定位:Pareto 前沿上的位置
把 Intelligence Index 53 分以上的模型放在一起看,Grok 4.3 的位置:
- vs Claude Sonnet 4.6:智能分数略高,输出价格只有 Sonnet 的一小部分;
- vs Muse Spark:Intelligence Index 略高,GDPval-AA 已反超;
- vs Grok 4.20 0309 v2:全面提升,且更便宜——除了 Non-Hallucination Rate 这一项;
- vs GPT-5.5(xhigh):Intelligence Index 与 GDPval-AA 双线落后,差距 276 ELO 量级。
简单说,Grok 4.3 在它所在的智能档位上,"贵不过同档,弱不过同价"。报告里 xAI 落在 Pareto 前沿的图示也是这个意思。
风险与局限
依据 4 月 30 日的报告,有三个不能忽视的点:
- 幻觉率回升。Non-Hallucination Rate -8 分是这次升级里最明显的退步,需要在系统侧用 RAG、引用约束、多模型校验等方式补回去。
- 顶部差距没有缩小。Intelligence Index 与 GDPval-AA 上,Grok 4.3 与 GPT-5.5(xhigh)的差距仍在 276-320 ELO 量级,期望胜率约 17%,顶部位置短期不会被挑战。
- 输出 token 消耗增加 44%。虽然单价降得更多,综合成本仍下降,但实际生产环境里 token 消耗的不确定性会上升,长 prompt + 长 response 的高频调用需要重新做容量评估。
选型建议
按 4 月 30 日报告的数据,可以给出三类明确判断:
优先 Grok 4.3:agentic 工作流、客服自动化(τ²-Bench Telecom 98%);需要从 Grok 4.20 平滑迁移、立刻享受 40-60% 降价;预算敏感的多步推理任务。
避免 Grok 4.3:对幻觉容忍度极低的场景(金融、医疗、法律)——继续用 Grok 4.20 0309 v2 或 MiMo-V2.5-Pro;追求最高 Intelligence Index 的场景——选 GPT-5.5(xhigh)。
需要复测的场景:高吞吐、低延迟业务(输出 token +44% 的影响需要在生产负载下实测);超长输入业务(报告未单独评测 100 万 token 满载场景下的延迟与稳定性,需要业务侧自测)。
Grok 4.3 的这次 benchmark 体现的是一个明确的工程取舍:用更高的输出 token 消耗换更强的 agentic 表现,用更低的单价把综合成本压下来,代价是 Non-Hallucination Rate 退一档。对 Agent 团队这是一笔划算的交易,对事实严格的场景则需要更谨慎评估。
API 已上线 xAI 官方平台,定价 $1.25 / $2.50 per million,推荐替换原有 Grok 4.20 调用——前提是先在自己的业务数据上跑一轮 Non-Hallucination 回归测试。
 AI 速览