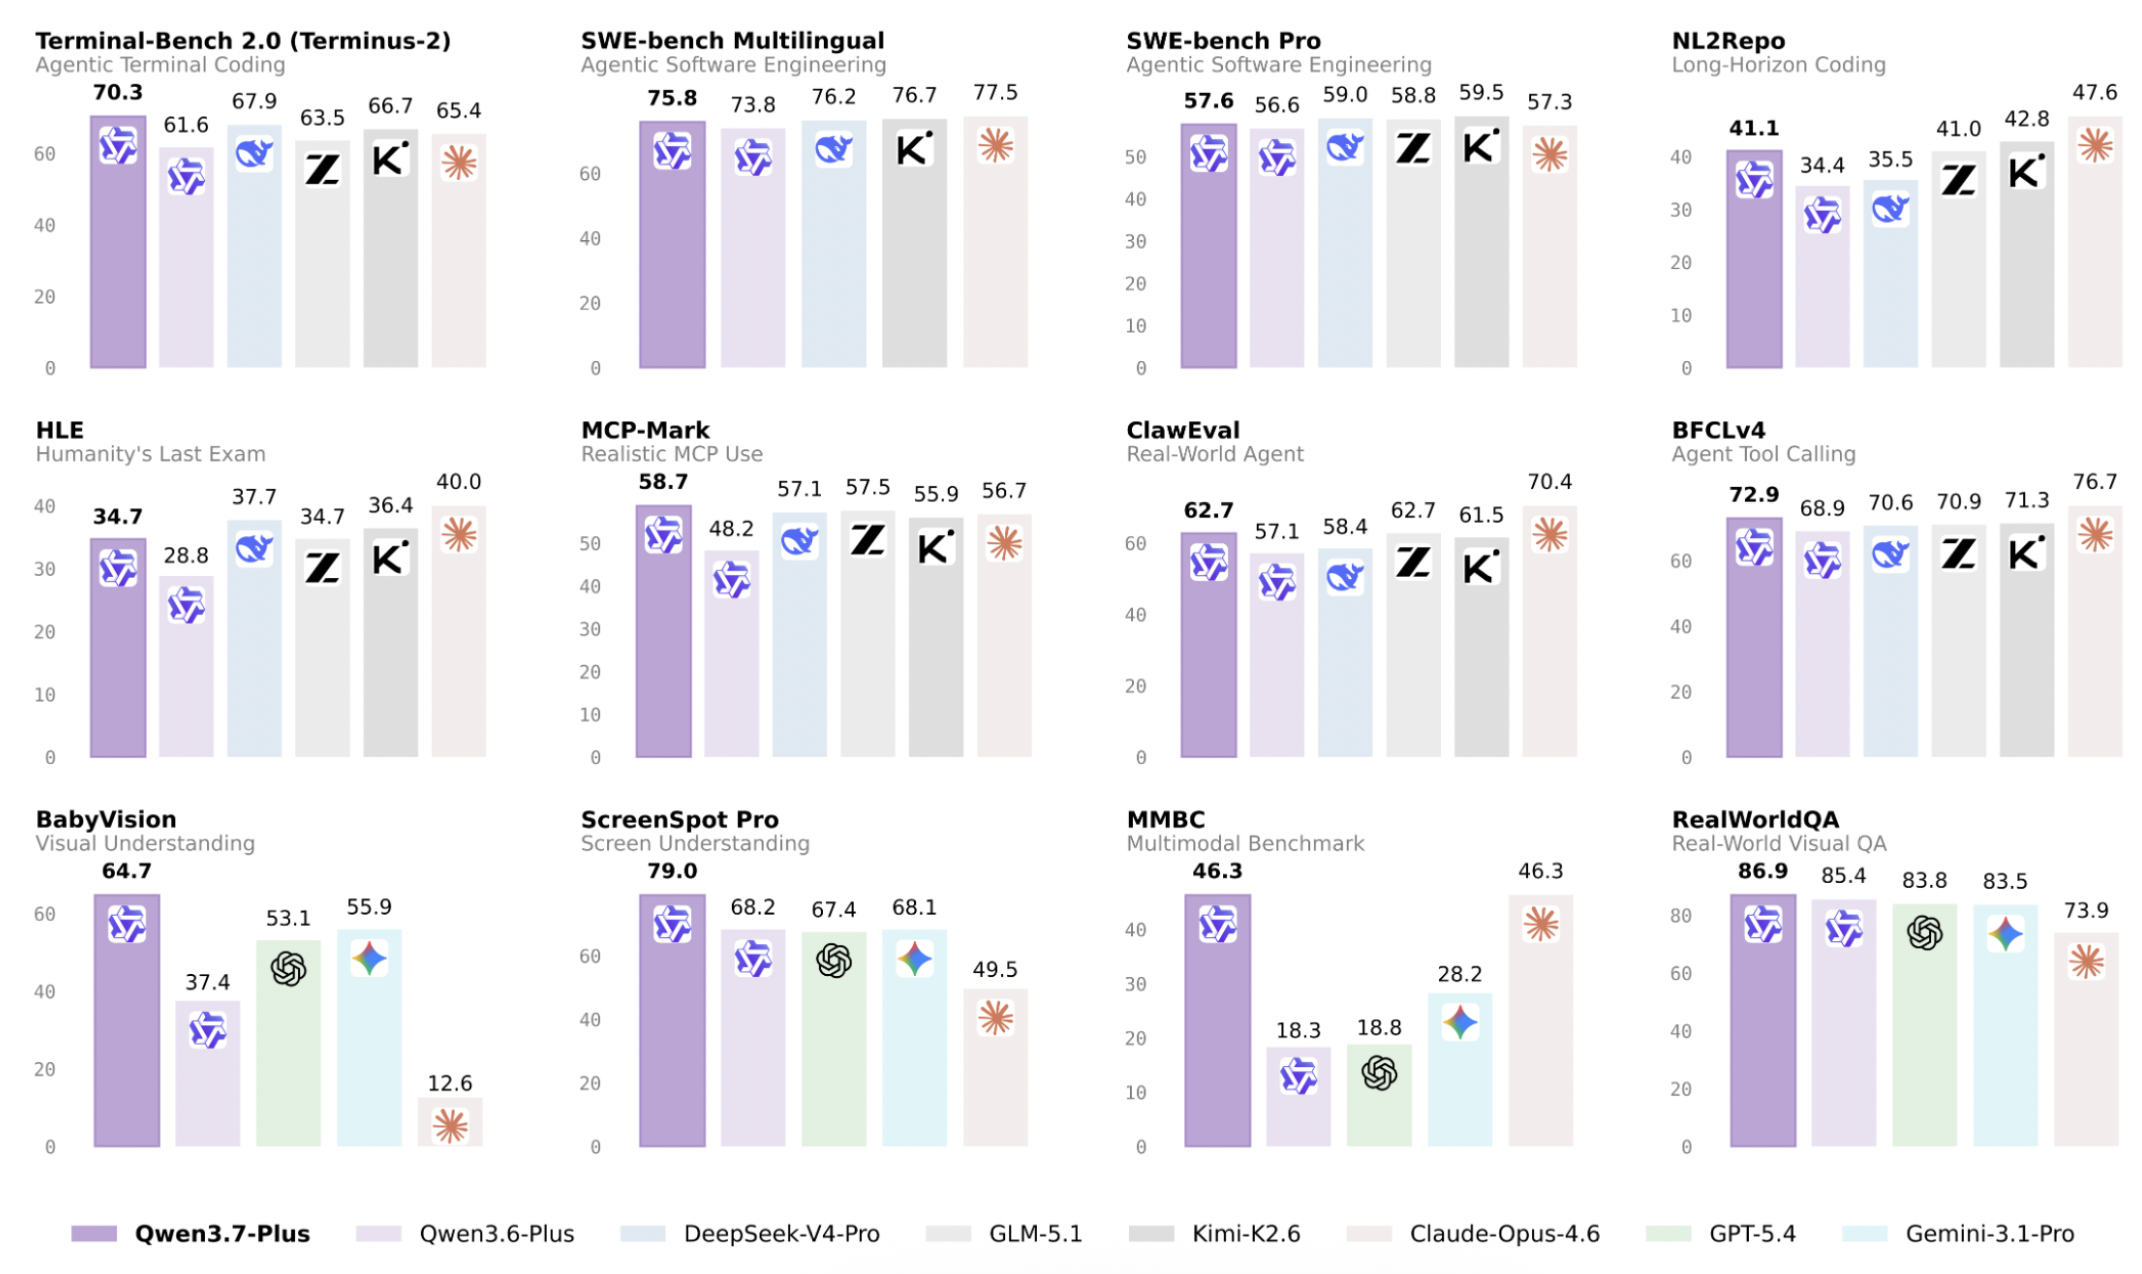
6月2日消息阿里 Qwen 团队发布 Qwen3.7-Plus,这是 Qwen3.7 系列中的多模态智能体模型。与同系列纯文本旗舰 Qwen3.7-Max 形成互补,Qwen3.7-Plus 主打视觉-语言统一理解,将 GUI 交互、屏幕阅读、代码生成和端到端移动 App 导航等 Agent 能力整合进一个模型。该模型已通过 Alibaba Cloud Model Studio 正式上线,定价具有竞争力。
Qwen3.7 系列的双子架构:Max 做推理,Plus 做多模态
Qwen3.7 系列延续了阿里此前"Max + Plus"的双旗舰策略。5 月 20 日阿里云峰会上,Qwen3.7-Max 以纯文本推理旗舰身份率先亮相,主打 100 万 token 上下文窗口、35 小时连续自主执行和超过 1000 次工具调用,在 Terminal-Bench 2.0 上拿到 69.7 分,SWE-Bench Pro 得分 60.6,Artificial Analysis 智能指数 56.6(全球第五、中国模型第一)。
Qwen3.7-Plus 则是多模态那一面。它在 LM Arena Vision 排行榜上排名全球第 16,使阿里在视觉能力上位列全球第 5 实验室。与 Max 的纯文本定位不同,Plus 支持图像输入,能理解截图、UI 界面、文档页面等视觉内容,并在此基础上执行推理和操作。
这种分工在实际使用中非常清晰:如果你做代码推理、数学证明、长文本分析,选 Max;如果你做 GUI 自动化、移动端操控、截图理解、视觉问答,选 Plus。
核心能力:从"看懂屏幕"到"替你操作手机"
Qwen3.7-Plus 的能力定位不是一般意义上的"多模态聊天",而是面向 Agent 场景的视觉-操作统一模型。官方强调了几个关键能力方向:
GUI 与 CLI 混合交互。 模型可以同时理解图形界面和命令行界面,在两种交互模式之间自由切换。这意味着它不仅能看懂一张 App 截图上的按钮和文字,还能生成相应的操作指令或代码来完成任务。
屏幕阅读与 UI 理解。 Qwen3.7-Plus 继承了 Qwen3.6-Plus 在文档理解(OmniDocBench 91.2)和 UI 理解方面的积累,并进一步强化了从屏幕截图中提取结构化信息的能力。
端到端移动 App 导航。 这是最受关注的能力之一。模型可以接收手机屏幕截图作为输入,理解当前界面状态,规划操作路径,并输出下一步应该点击哪里、滑动到哪里。阿里此前发布的 Mobile-Agent-v3 和 GUI-Owl 框架为这一能力提供了技术基础。
截图重建 App。 给模型一张 App 界面截图,它可以生成还原该界面的前端代码。这个能力在前端开发、产品原型制作和设计稿转代码等场景中有直接应用价值。
在 Terminal-Bench 2.0 上,Qwen3.7-Plus 拿到约 70.3 分。作为参考,同系列的 Qwen3.7-Max 得分 69.7,前代 Qwen3.6-Plus 得分 61.6。这一跃升说明 Plus 在保持多模态能力的同时,Agent 执行能力也在快速追赶甚至超越纯文本旗舰。
怎么用:API 接入与定价
Qwen3.7-Plus 已通过 Alibaba Cloud Model Studio 正式上线。接入方式与此前 Qwen 模型一致,支持 OpenAI 兼容 API 格式,也支持 Anthropic API 协议,这意味着开发者可以用现有的 OpenAI Python SDK 或 Claude Code 直接对接,只需更改 endpoint 和 API key。 定价方面,阿里尚未单独公布 Qwen3.7-Plus 的详细价格。参考同系列 Qwen3.7-Max 的定价(输入 $2.50/百万 token,输出 $7.50/百万 token,缓存输入仅 $0.25/百万 token),Plus 版本大概率会延续阿里一贯的性价比策略——在同等能力水平下,价格显著低于 Claude Opus 4.7(输入 $15/百万 token)和 GPT-5.5(输入 $10/百万 token)。 新用户在新加坡区域可获得每个模型 100 万 token 的免费额度,这不是总额而是每个模型各自独立。此外,chat.qwen.ai 提供有限的免费预览访问。
与竞品对比:多模态 Agent 赛道的卡位战
Qwen3.7-Plus 的竞争对手不是传统的聊天模型,而是同样瞄准 Agent 场景的多模态模型:
Claude Opus 4.7/4.8 是当前综合能力最强的选项,Intelligence Index 57.3+,编码和推理表现一流,但不以 GUI Agent 为核心卖点,且价格是 Qwen 的 6 倍以上。
GPT-5.5 在推理和多模态理解上位于顶尖水平(Intelligence Index 60.2),但同样没有将"替用户操作 GUI"作为主推方向,且定价偏高。
Gemini 3.5 Flash 原生支持多模态,推理速度快(输出 token 速度约为 Qwen 的 4 倍),Intelligence Index 55.3,但在 Agent 自主执行稳定性上不如 Qwen 系列。 Qwen3.6-Plus(前代) 在 Terminal-Bench 2.0 上得分 61.6,OmniDocBench 91.2,MMMU 86.0。Qwen3.7-Plus 在 Agent 执行能力上提升约 14%,视觉理解能力也有进一步增强。
Qwen3.7-Plus 的差异化在于:它可能是当前为数不多将"多模态感知 + GUI 操控 + 移动端导航"作为核心能力来优化的前沿模型。多数竞品把多模态当作"附加能力",Qwen3.7-Plus 把它当作"主业"。
仍需关注的局限
第一,基准分数出自厂商发布,独立验证尚不充分。 Terminal-Bench 2.0 约 70.3 分的数据来源于官方公布,截至目前第三方基准测试机构(如 Artificial Analysis)尚未发布 Qwen3.7-Plus 的独立评测结果。此前 Qwen3.7-Max 的部分对比基线使用的是 Claude Opus 4.6 而非最新的 4.7/4.8,直接对标时需注意版本差异。在选型决策中,建议等待独立评测或在自己的工作负载上实测。
第二,闭源 API-only,无法自部署。 与 Qwen3.7-Max 一样,Qwen3.7-Plus 是闭源模型,不提供权重下载,只能通过 Alibaba Cloud Model Studio API 访问。这意味着对数据主权有严格要求的企业(尤其是需要数据留在美国或欧洲辖区的场景)可能面临合规限制。参考 Qwen3.6 的节奏(旗舰 API 上线后 3-4 周推出开源中等规模版本),开源变体预计 6-7 月会跟进,但不确定是否包含完整的多模态 Agent 能力。
第三,GUI Agent 能力的实际稳定性尚待验证。 移动端 App 导航、截图重建等能力在 demo 场景下表现亮眼,但在真实业务环境中面临界面多样性、异常状态处理、跨 App 工作流串联等复杂情况。阿里此前的 Mobile-Agent-v3 框架在学术基准上表现突出,但从学术基准到生产可用之间仍有距离,实际部署效果需要开发者在具体场景中验证。
对普通用户和开发者意味着什么
对于普通 AI 工具用户,Qwen3.7-Plus 的发布信号是清晰的:2026 年 AI 模型的竞争焦点正在从"谁聊天更聪明"转向"谁能替我做更多事"。一个能看懂你的手机屏幕、理解你当前在做什么、并帮你规划下一步操作的 AI,比一个只能回答问题的 AI 有更大的想象空间。
对于开发者,Qwen3.7-Plus 提供了一个成本可控的多模态 Agent 基座。如果你在构建 RPA 自动化、移动端测试、GUI 辅助操作等应用,这个模型值得纳入评估列表。API 兼容 OpenAI 和 Anthropic 协议意味着接入成本很低,阿里的定价策略也让长时间运行的 Agent 工作流在经济上可行。
但需要保持清醒的是:Agent 能力仍处于快速迭代期,今天的领先者可能在下个月就被超越。选型时更重要的是架构的可替换性——确保你的系统能低成本切换底层模型。
 AI 速览