当一个智能体任务失败了,到底该怪模型太笨,还是框架没配好?
这个问题在 2026 年变得越来越尖锐。SWE-bench 上 Claude Opus 4.7 刷到 87.6%,AgentBench 覆盖了 8 个环境,但几乎所有主流评测都在做同一件事——给模型打分。框架(Harness)这个变量,要么被固定为单一实现,要么被默认为"不影响结果"。 PawBench 不这么看。它是 AgentScope 团队(agentscope-ai)在 2026 年 6 月开源的智能体评测基准,核心设计思路是把模型和 Harness 同时放进评测矩阵,用交叉对照的方式拆分出各自的贡献和短板。v1.0 的评测规模是 9 个模型 × 3 个 Harness × 150 道任务,共计 4,050 个测试单元。
结果里有一组数据足以让所有 Harness 开发者警觉:同一个 qwen3.6-35b-a3b 模型,只换 Harness,分数差距达到 11.5 分。这意味着 Harness 的工程质量对智能体最终表现的影响,可能比换一个更大的模型还要大。
PawBench 的评测设计:不只排名,更要拆因
大多数智能体评测遵循"任务集 → 模型跑分 → 排行榜"的线性流程。SWE-bench 测的是代码修复能力,AgentBench 覆盖 8 个环境但聚焦模型泛化性,GAIA 关注多步骤推理——它们都默认 Harness 是常量。
PawBench 的评测公式写得很明确:Agent Performance = f(LLM, Harness)。它把 Harness 从"实验背景"提升为"评测变量",引入了三个维度的交叉对照。
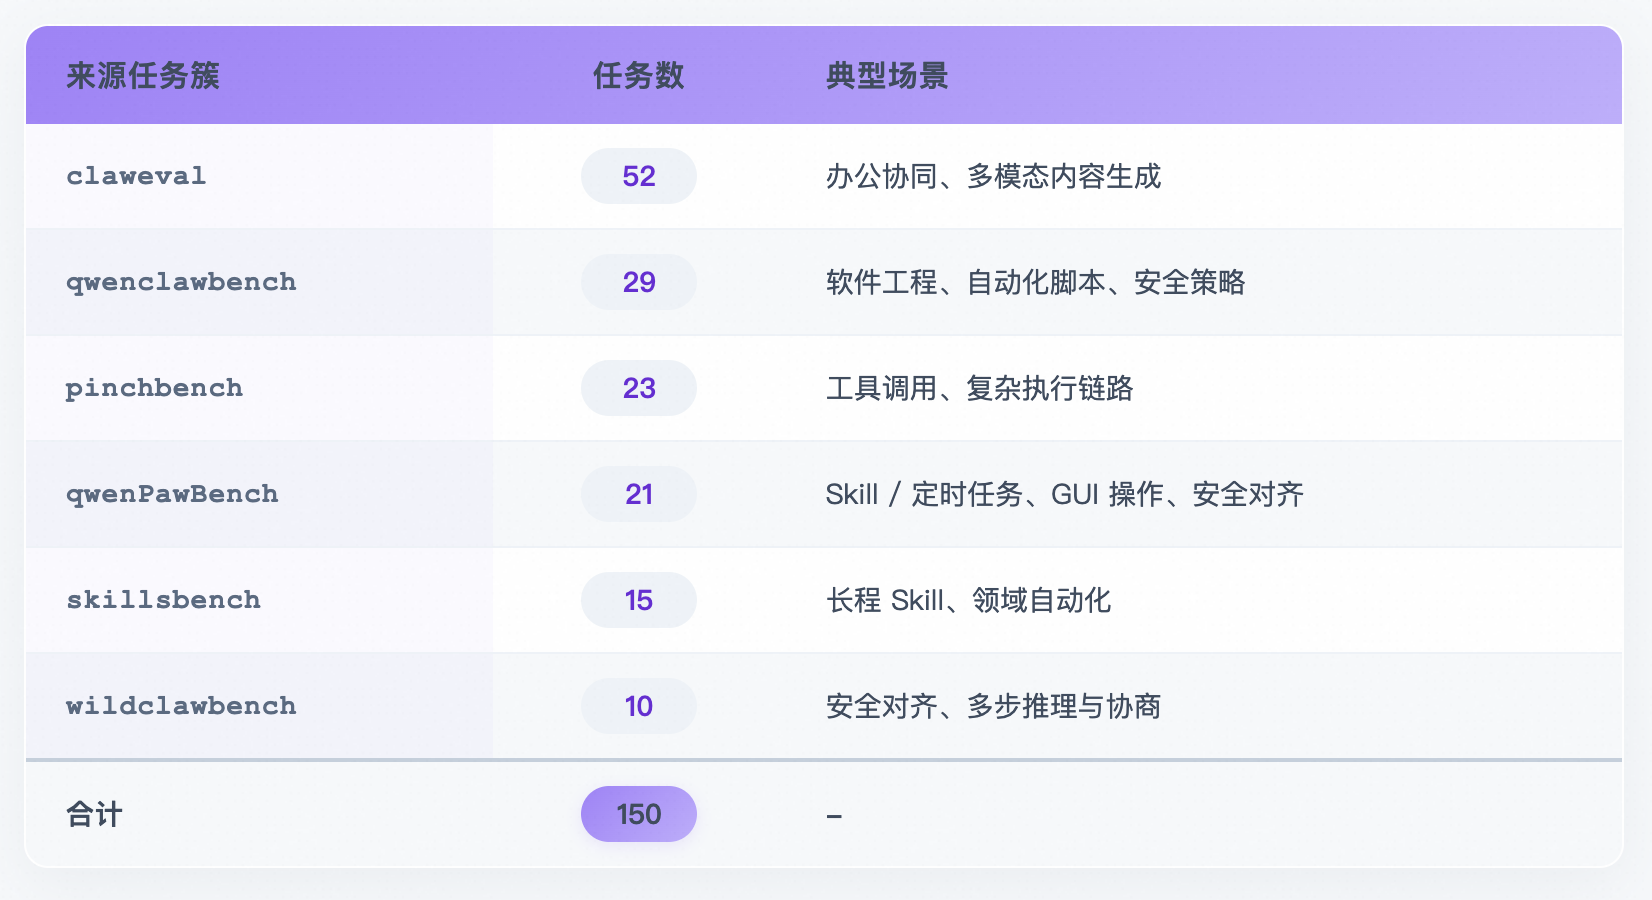
150 道任务从 6 个已有评测集中抽取(Claw-Eval 52 道、QwenClawBench 29 道、PinchBench 23 道、PawBench 自建 21 道、skillsbench 15 道、WildClawBench 10 道),每道题按 5 个维度打标:应用场景(办公协同、软件工程等 13 个一级分类)、原子能力(工具调用、规划、逻辑推理等 7 项)、复杂度(L1/L2/L3 三级)、输入模态(纯文本或多模态)、运行环境(离线沙箱或联网)。
三家参评 Harness 分别是 QwenPaw(来自 AgentScope 官方)、OpenClaw(社区最大的开源智能体框架,GitHub 34.6 万星)和 Hermes(Nous Research 出品,主打自学习闭环)。9 个模型覆盖了 Qwen、GLM、Claude 等主流系列。所有任务在 Docker 沙箱中运行,执行轨迹、评分产物和环境快照均保留用于切片复盘。
评分由两部分组成:自动评分器(规则断言 + 子项检查)和 LLM-as-judge(语义质量评估),混合加权后最终分数在 0-1 之间。榜单支持 Overall、Text(124 道)、Multimodal(26 道)三个切片。
对比来看,SWE-bench 的评分是二元的(测试通过或不通过),AgentBench 按环境独立打分但不做 Harness 交叉。PawBench 的混合评分和多维切片设计,让它更接近"诊断工具"而非单纯的"排行榜"。
三个关键发现:Harness 差距堪比一次模型升级
PawBench 的切片分析能力是它区别于其他评测的核心卖点。4,050 个测试单元按模型规模、模态、任务类型、技能领域等维度拆开后,浮现出三个值得关注的模式。
Harness 间存在稳定且显著的分差。 三家 Harness 的 Overall 均分分别是 QwenPaw 76.4、OpenClaw 75.4、Hermes 70.4,最高极差 6 分。这个差距接近甚至超过许多模型版本升级带来的提升。在 qwen3.6-35b-a3b 上,换 Harness 的分差达到 11.5 分——执行轨迹复盘发现,Hermes 缺少对工作区产物的硬校验(文件是否落盘、diff 是否生成),导致模型过早宣布完工;同时 Hermes 默认装载约 65 个工具(OpenClaw 约 30 个,QwenPaw 约 15 个),庞大的工具 Schema 挤占上下文窗口,加重了小模型的首轮决策负担。
Skill 主动发现是三家共同的短板。 17 道 Skill 任务要求 Harness 从 workspace 中发现并加载项目专属的 SKILL.md,然后指导模型按 Skill 规范执行。但 Hermes 和 QwenPaw 都不会主动扫描 workspace 中的 Skill 文件,只有 OpenClaw 做了这一步。即使 Skill 被成功注入,模型在长链路推理和精细计算上仍容易出错——Harness 能指路,但走不走通还是看模型底座。这与 SWE-bench 社区观察到的"scaffold 对结果影响巨大"结论一致:2026 年 2 月的一项测试显示,三个不同 Agent 框架跑同一个 Opus 4.5 模型,在 731 道题上相差 17 道。
Web 搜索任务高度依赖零配置可用性。 Hermes 内置了 web_search 和 web_extract 工具,但必须配置外部搜索 API Key 才能启用。在只配置 LLM 密钥的评测环境下,这些工具直接锁死,模型只能用基础 browser 硬做。OpenClaw 的 web_search 支持 DuckDuckGo 等免密服务,web_fetch 依赖内置 HTTP 抓取,真正实现了零配置直连。QwenPaw 虽无专属搜索工具,但通过 browser_use 也能完成基础 Web 访问。这说明"默认可用"不只是开发体验问题,它直接影响评测成绩。
竞品对照:PawBench 填补了什么空白
2026 年的智能体评测生态已经相当丰富。SWE-bench Verified 是代码智能体的事实标准,AgentBench 覆盖最广的环境矩阵,GAIA 聚焦多步骤推理,WebArena 测浏览器操作,TAU-bench 测客服场景。但它们有一个共同盲区——都把 Harness 当作固定条件,不参与评分。
这在评测方法论上存在一个漏洞。正如 benchmarkingagents.com 在 2026 年的综述中指出的:一个标着模型名字的 benchmark 分数,实际上反映的是"模型 + 特定 scaffold"的联合效果,而非模型本身。PawBench 把这个隐含变量显式化了。
PawBench 的定位不是取代这些评测,而是补充"Harness 对模型表现的放大或抑制效应"这个被忽略的维度。它属于 OpenJudge 生态的一部分,后者提供 50+ 个生产级评分器(相关性、工具选择、轨迹分析等),可供开发者构建自己的评估流水线。
四条 Harness 设计原则——以及它们的边界
PawBench 团队从切片结果中提炼了 4 条 Harness 设计原则。
Inform Fully(充分告知)。 模型看不见的信息对它等于不存在。Harness 应在 Prompt 中明确告知 cwd、workspace 路径、输出目录、可用 Skill 文件等运行环境信息。Hermes 在路径感知上的缺失直接导致了"写入成功但扫描不到产物"的问题。
Equip on Demand(按需装备)。 关键工具应默认可用(如 keyless web search、内置 HTTP fetch),同时工具总量要匹配目标模型的上下文预算。65 个工具的 Schema 对 35B 参数的小模型来说已经构成认知负担。
Monitor Actively(主动监控)。 不要只听模型说"我完成了",要检查文件是否落盘、是否非空、是否包含必填字段。产物级校验在文件写入、代码修改、报告生成等任务中比模型自我声明可靠得多。
Recover Gracefully(弹性恢复)。 一次异常不等于任务失败。对空响应、工具调用异常或产物缺失的情况,Harness 可以注入当前状态信息给模型一次续推机会,而不是直接判死。
这四条原则的边界也很清楚:它们针对的是 Harness 层可优化的工程问题,不解决模型底座的推理瓶颈。PawBench 的 Skill 任务结果已经证明,即使 Harness 把路标立得再清楚,长链路推理出错仍然是模型自身的能力天花板。
局限和需要注意的地方
PawBench v1.0 有几个需要留意的限制。
评测规模仍然有限。150 道任务、3 家 Harness、9 个模型的矩阵已经产生了 4,050 个测试单元,但任务覆盖面和 Harness 多样性还不够。路线图上标注了 Claude Code、Cursor Agent、CoPaw 等更多框架的接入计划,以及更多开放环境、多模态和长链路任务的扩充。 三家 Harness 的成熟度不同。QwenPaw 是 AgentScope 官方维护的框架,在评测设计上可能存在主场优势——任务格式和评分规则与 QwenPaw 的默认行为更契合。OpenClaw 社区规模最大(GitHub 34.6 万星),工具生态最丰富。Hermes 发布时间最晚(2026 年 2 月),GitHub 星标增速最快但配套成熟度仍在追赶。分数差距可能部分反映了"针对评测格式的适配程度"而非纯粹的工程质量差异。
LLM-as-judge 的评分一致性有待验证。混合评分中的语义评估部分依赖 LLM 裁判,不同裁判模型可能产生不同偏好。PawBench 在这方面没有公布 inter-rater agreement 数据。
零配置评测条件对 Hermes 可能不完全公平。PawBench 还原的是"clone 后只写 LLM 密钥直接跑"的默认体验。Hermes 的 web_search 需要额外 API Key,在这个条件下被锁死,但这也是真实用户的第一次体验。这既是有效的发现,也是评测设计选择——需要读者自行判断这种"默认体验"评测范式是否符合自己的使用场景。
选型建议:谁该关注 PawBench
如果你是智能体用户,PawBench 的榜单可以帮你在"模型 + Harness"的二维空间中做选择。纯文本任务、多模态任务、Skill 任务和 Web 搜索任务的最优组合不同,切片数据比单一总分更有决策价值。当前数据显示,QwenPaw 在综合分和多数切片上略胜,OpenClaw 在 Skill 发现和 Web 搜索的零配置体验上有优势,Hermes 的自学习闭环架构在 PawBench 的单次评测范式下还没有充分发挥。
如果你是 Harness 开发者,PawBench 的价值在于诊断而非排名。4,050 个 cell 的对照矩阵支持横向自检(在哪些任务类型上落后)、失败画像(锁定可疑切片后对比 trace 定位问题)和回归验证(修复后重新切片确认分数变化对应问题点)。这比在 SWE-bench 上跑一个总分然后猜原因要高效得多。
如果你在研究智能体评测方法论,PawBench 的"模型×Harness 交叉矩阵"设计思路值得关注。它与 SWE-bench 社区近期的讨论方向一致——越来越多人意识到,benchmark 分数标的是"模型名"但实际测的是"模型+框架"的联合效果。PawBench 是第一个把这个变量显式拆出来的开源评测集。
 AI 速览