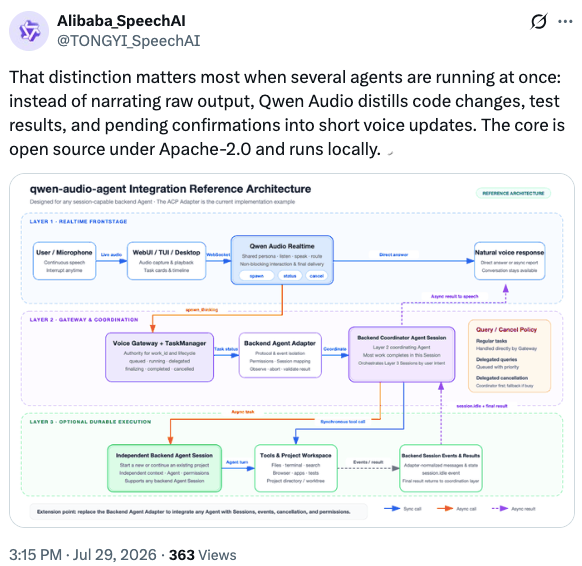
7月29日消息,阿里巴巴 Qwen 团队正式开源 Qwen-Audio-Agent,一个为现有 Agent 框架提供实时语音交互能力的中间层。该项目已在 GitHub 上发布(Apache 2.0 协议),面向 Hermes、OpenClaw 等 Agent 框架开放集成。
不是替代,是加一层
Qwen-Audio-Agent 的定位清晰:不取代任何现有 Agent 框架。它的角色是一个"实时语音层",缝合在用户和已有 Agent 之间——让原本只能通过文本交互的 Agent 获得完整的语音对话能力。
用户可以直接用语音向 Agent 委托任务,语音通道在整个任务执行期间保持激活,而不是只用来发起一次请求。这意味着用户可以像打电话一样和 Agent 对话:说"帮我查一下本周服务器日志的错误率",Agent 开始执行后,过一会儿再说"进度怎么样了",Agent 实时回应。
支持随时打断——Agent 正在汇报时,用户可以直接插话纠正方向或调整参数,Agent 立即响应新指令。任务也可以随时通过语音取消。
解决的是"执行期间失联"的问题
这个开源项目的切入点抓住了 Agent 使用中的一个真实痛点:当前 Agent 在执行长时间任务时,用户只能盯着终端或对话窗口等待,期间 Agent 既不说话也不反馈。一旦任务需要几轮人机交互(确认参数、选择方案、修正方向),现有的"发消息→等回复"模式就显得笨重。
Qwen-Audio-Agent 的实时语音层改变了这个交互模型。语音通道持续开放,Agent 在执行的间隙可以主动汇报状态,用户也可以随时切入确认或调整方向。交互模式从"异步留言"变成了"同步对话"。
技术基础
该 Agent 基于 Qwen 团队此前发布的 Qwen-Audio-3.0 系列模型构建,包括实时全双工模型(Qwen-Audio-3.0-Realtime)和 TTS 模型。这套底层模型支持低延迟流式交互、自然语言风格控制、情感表达和多语言能力,在 Artificial Analysis TTS 排行榜上位居前列。
阿里 Qwen 团队在 2026 年保持了高频率的开源节奏,此前已发布 Qwen3-TTS、Qwen-Audio-3.0-TTS 等多个语音模型。Qwen-Audio-Agent 将这些模型能力封装为一层可复用的 Agent 交互接口,降低了开发者在自己的 Agent 框架上集成实时语音的门槛。
项目仓库地址:github.com/QwenAudio/qwen-audio-agent
 AI 速览