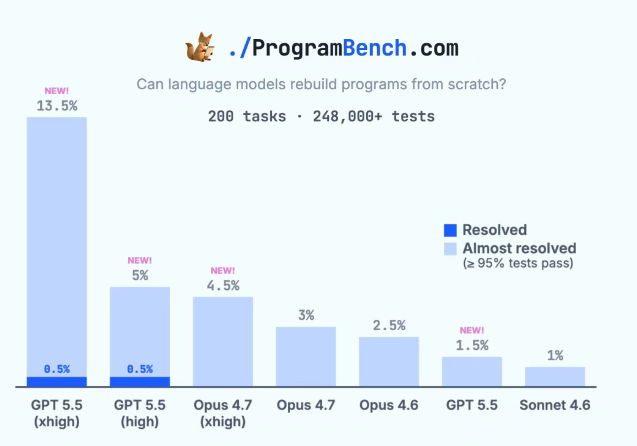
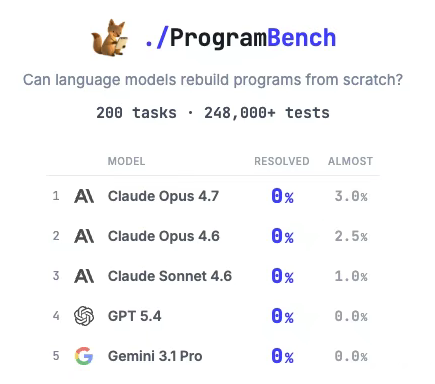
5 月 13 日,新智元消息,OpenAI 的 GPT-5.5 成功攻克ProgramBench首个编程任务,成为全球首个在该基准上实现 “零的突破” 的 AI 模型,标志着编程 AI 正式进入以推理算力为核心的全新阶段。
一、ProgramBench:AI 编程的 “地狱级” 闭卷考试
ProgramBench 是 Meta 联合斯坦福、哈佛推出的全新编程评估基准,被视为当前 AI 编程领域难度最高的测试。
- 测试规则严苛:仅提供编译后的可执行文件与功能文档,无源码、禁止反编译、禁止联网,要求 AI 从零开始完整重写程序。
- 任务覆盖广泛:包含 200 道高难度题目,涵盖 jq、ripgrep、FFmpeg、SQLite、PHP 编译器等实用工具与系统级项目。
- 初始通过率为 0:该基准发布后,所有主流前沿 AI 模型均未能完整解答任意一题,GPT-5.5 是首个破局者。
与 SWE-bench、HumanEval 等 “修 bug、补函数” 的开卷式测试不同,ProgramBench 全面检验 AI 的自主理解、逻辑推理与工程实现能力,更贴近真实开发场景。
二、GPT-5.5 突破表现:双语言解题,高算力模式断层领先
GPT-5.5 成功完成的首个任务是重写终端 “黑客帝国” 数字雨效果程序 cmatrix,展现出超强的自主编程能力。
- 双语言实现:high 版本采用 C 语言,xhigh 版本采用 Python,两种方案均通过全部行为测试。
- 高效解题路径:high 版本经 10 轮探索摸清程序逻辑,一次性写出完整代码,仅 5 次微调即完成;xhigh 版本通过 27 步全面探索,直接写出无缺陷 Python 代码。
- 算力驱动性能跃升:medium 模式表现普通,切换至 xhigh 高推理算力模式后,不仅实现 0.05% 通过率,还让 26 个任务完成超 95% 单元测试,在平均分、通过率等核心指标上全面碾压 Opus 4.7 xhigh。
对比之下,Claude Opus 4.7 xhigh 调用成本超 GPT-5.5 十倍,却因颜色解析、退出码两个基础 bug 导致测试失败,仅在处理缺失头文件时展现出有限工程优势。 三、行业变革:推理算力成为 AI 编程核心决胜因素
GPT-5.5 的突破,彻底改写了 AI 编程的能力评判逻辑。
- 传统基准失效:SWE-bench、GPQA 等传统测试已被 AI 刷至高分,区分度大幅下降,无法衡量顶尖模型差异。
- 算力即能力:同一 GPT-5.5 底座,推理算力档位不同,性能呈现天壤之别,验证了 “推理算力缩放定律”—— 智能水平随算力投入指数级提升。
- 技术路径明确:无需等待架构革命,持续提升推理算力,即可推动 AI 从实现小工具,逐步走向 SQLite、Linux 内核等系统级项目开发。
这一结论也与 OpenAI 研究员 Noam Brown 的观点高度契合,即 AI 研发需转向更考验真实能力的全新评估体系。
四、行业信号:从零到一,ASI 时代序幕拉开
GPT-5.5 在 ProgramBench 上 “首破零”,并非简单的技术进步,而是行业变革的标志性信号。
- 垂直领域质变:AI 从代码辅助工具,进化为可独立完成全流程开发的智能主体。
- 中国 AI 迎挑战:全球 AI 竞赛已进入算力军备竞赛阶段,推理算力将成为未来技术卡位的关键。
- 长期想象空间打开:此次突破复刻了 AlphaGo 战胜棋手、GPT-4 通过律考等历史时刻,预示 AI 能力将进入指数级增长通道,通用人工智能(ASI)的实现路径愈发清晰。
目前 ProgramBench 仍有 199 道题目待攻克,GPT-5.5 的突破只是起点。随着推理算力持续升级,AI 编程将彻底重构软件开发行业,带来生产力的革命性提升。
 AI 速览