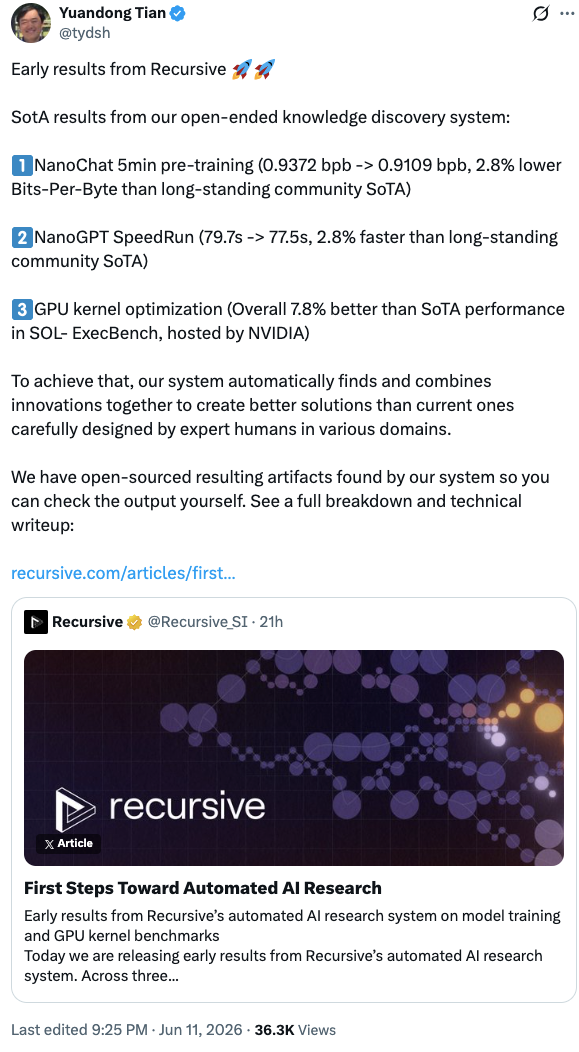
6月12日消息,成立仅半年的 AI 公司 Recursive 发布了首批公开成果。一套通用的自动化 AI 研究系统——没有针对任何单一任务做特殊调优——在三个差异极大的基准上同时刷新了最佳纪录:小模型固定预算训练(NanoChat)、小模型训练速度竞赛(NanoGPT Speedrun)、以及 NVIDIA GPU 内核优化(SOL-ExecBench)。全部产出代码已开源,10 组随机种子结果可复现。
这不是又一个"AI 即将取代科学家"的概念演示。它在三条完全不同的技术栈上都打败了人类社区长期打磨的方案,而且用的是同一个系统。
三项 SOTA 到底强在哪
先看数据。NanoChat Autoresearch 是 Andrej Karpathy 今年 3 月开源的 autoresearch 项目衍生的协作基准。规则简单:单 GPU、五分钟固定训练预算,把小语言模型的验证损失(BPB)压到最低。此前社区最佳成绩 0.9372 BPB 由几十名人类研究者和上百个 AI Agent 协作取得。Recursive 的系统从相同起点出发,将这一数字推到 0.9109 BPB,降低 0.0263,等效于用 1.3 倍更少的训练时间达到相同损失。更值得注意的是,系统从一个极弱的初始实现(朴素 Transformer + AdamW)出发,也能跑到 0.9344 BPB,同样超过社区最佳。
NanoGPT Speedrun 的难度更高。这是一个已经被社区打磨了两年的基准,83 次人类打破记录的提交、数百个 PR 把 8×H100 训练到验证损失 3.28 的时间从最初的约 45 分钟压到 79.7 秒。Recursive 的系统在这个已经高度优化的方案之上又削掉了 2.2 秒,达到 77.5 秒。改进幅度与近期人类贡献相当甚至更大,且通过了排行榜要求的统计显著性检验(均值 ≤ 3.28,p < 0.01)。
第三项是 NVIDIA 的 SOL-ExecBench,235 个真实 GPU 内核优化任务,目标是在 Blackwell B200 上尽可能逼近硬件理论极限(SOL 分数 1.0)。此前最佳均值 0.699,Recursive 达到 0.754——将与理论最优的差距缩小了约 18%。系统在所有 235 个内核上联合搜索,自动复用发现的优化模式(融合归一化、位打包路由、本地 PTX 指令等)。
系统怎么工作
Recursive 没有公布完整系统架构,但披露了核心工作流程。系统执行一个自动化研究循环:提出想法→实现代码→运行实验→验证结果→利用反馈选择下一步实验。关键能力包括长时间并行运行多条研究线程、跨实验保持有用上下文、合并有前景的分支、以及在确认改进为"真实进步"前通过严格的奖励黑客检测和方差校验。
技术细节上,NanoChat 最大的增益来自哈希 bigram/trigram 嵌入表——通过将相邻 token 对和三元组哈希到固定大小的查找表,再经由学习门控混入注意力值路径。这让模型以极低计算成本利用局部 n-gram 信息,不同层使用不同哈希函数以减少碰撞重叠。该思路与 DeepSeek 的 Engram 工作(以哈希表为稀疏性轴)有交叉,但具体变体是系统自主发现的。 NanoGPT Speedrun 的改进则分布在多个层面:将 FP8 精度从仅 LM Head 扩展到注意力投影路径(前向用 float8_e4m3、反向保持 bf16);在优化器中注入退火探索噪声(类 Langevin/SGLD),训练前期增大搜索范围、后期线性衰减到零;对嵌入表应用"谨慎 Adam"(仅保留梯度方向一致的更新分量);以及重写 Triton 融合 MLP 核以减少一次完整激活张量的显存往返。
SOL-ExecBench 中,系统发现了多种精巧的内核工程手法:将 GRN 算子的仿射变换吸收进下一层权重矩阵以消除中间同步;用位打包技术将 score 和 expert_index 编码进单个 uint32 实现高效 top-K 路由;利用 NVIDIA 原生 PTX 指令 cvt.rn.satfinite.e2m1x2.f32 直接做 FP4 打包。这些方案覆盖了从高层融合策略到汇编级别的优化。
和竞品比,Recursive 的差异化在哪
"AI 做 AI 研究"在 2026 年已经不是新概念。Karpathy 的 autoresearch 在 3 月发布后一周内拿到 26000 星,验证了"Agent + 单一指标 + 固定预算"的循环范式。Google DeepMind 的 AlphaEvolve 用进化算法+Gemini 模型做通用算法发现,已在数据中心调度、芯片设计、基因组学等场景落地。Sakana AI 的 AI Scientist 则瞄准端到端论文生成,v2 版本产出了首篇通过人类同行评审的全 AI 论文,相关工作已发表在 Nature。 Recursive 的定位有几个差异点。第一,通用性:同一个系统、同一套流程在模型训练、训练速度优化、底层内核三个完全不同的技术栈上都超过了人类最佳,而非针对单一任务特化。第二,对抗奖励黑客的工程深度:他们在文章中多次强调,随着搜索能力变强、评估器也必须同步变强——迭代式奖励黑客检测器是系统的核心组成部分。第三,开放验证:代码和全部 10 组种子结果已开源在 GitHub,任何人都可以复现。相比之下,AlphaEvolve 的核心系统闭源,autoresearch 更偏向可复现的个人/社区实践框架而非集中式研究系统。
当然,局限也很明显。这三个基准的共同特点是指标明确、反馈快速、评估可硬编码——这正是当前自动化研究最容易发挥的领域。面对需要长周期实验、模糊评估标准、或涉及现实世界部署的研究任务,系统的泛化能力尚未得到验证。Recursive 自己也承认这是"第一步"。
为什么值得关注
Recursive 的团队配置解释了为什么资本愿意在没有产品的情况下开出 46.5 亿美元估值:CEO Richard Socher 曾任 Salesforce 首席科学家、创办 MetaMind 和 You.com;联合创始人田渊栋(Yuandong Tian)是前 Meta FAIR 负责人;团队还包括 Jeff Clune、Tim Rocktäschel、Josh Tobin 等来自 DeepMind、OpenAI、Uber AI 的知名研究者。6.5 亿美元融资由 GV 和 Greycroft 领投,NVIDIA 和 AMD Ventures 跟投,硬件厂商的参与意味着他们预判递归自改进不是理论奇观而是近期算力客户。
但真正让这次发布脱离"有钱团队又融了一大笔"叙事的,是可复现的基准改进。在一个充斥着 Benchmark 操纵和选择性报告的行业里,开源代码 + 多种子结果 + 在人类社区长期维护的排行榜上取得显著进步,这是一种比融资数字更有说服力的信号。
接下来值得追踪的问题是:当系统面对更开放、更模糊的研究目标时,这套循环还能保持多大的有效性?以及 Recursive 宣称的"Level 1 自主训练系统"何时公开——那才是"递归自改进"从工程优化迈向真正科学发现的分水岭。
开源地址: https://github.com/recursive-org/first-steps-toward-automated-ai-research
官方文章: https://www.recursive.com/articles/first-steps-toward-automated-ai-research
 AI 速览