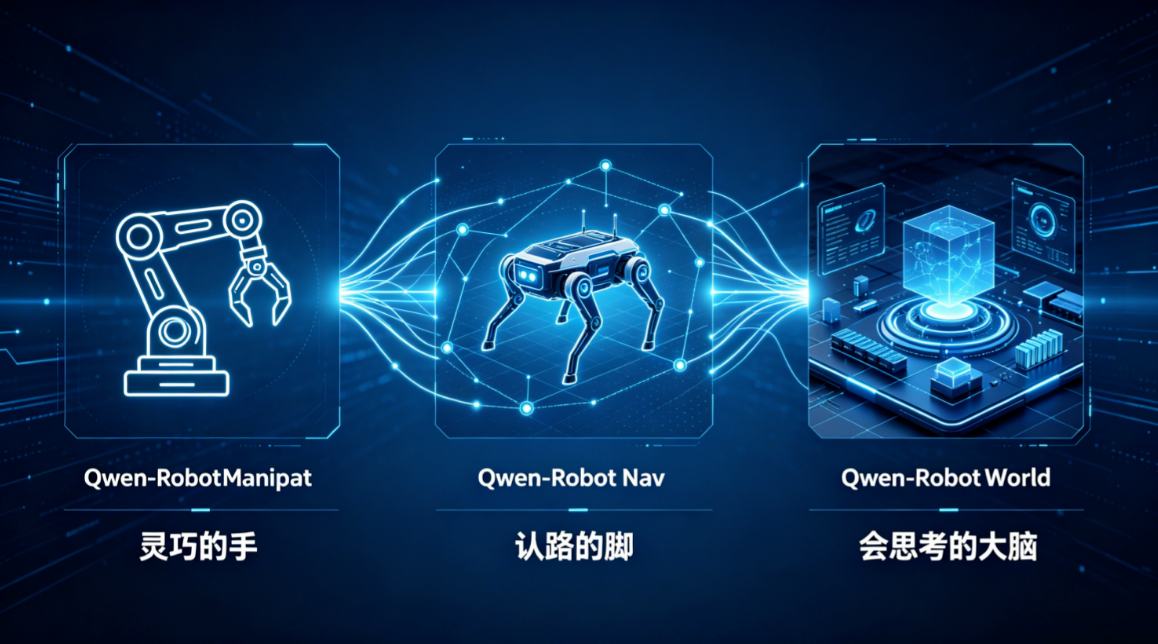
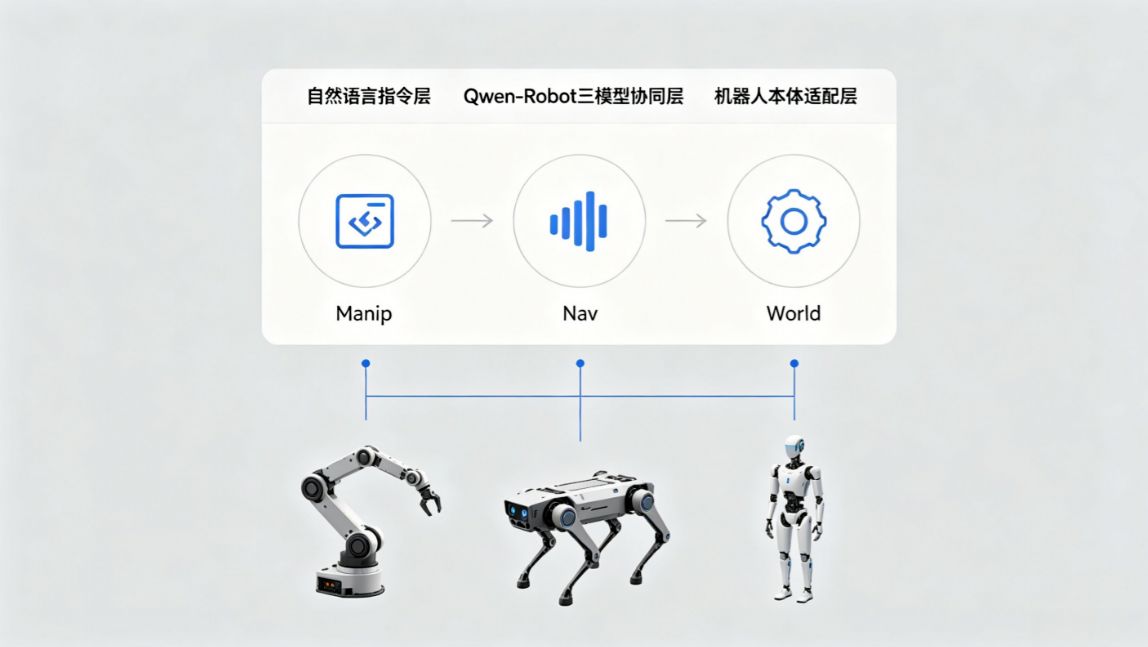
6月16日,阿里巴巴正式推出千问具身智能大模型Qwen-Robot系列,三款模型分工明确:VLA操作模型Qwen-RobotManip管"动手"、VLN移动模型Qwen-RobotNav管"认路"、世界模型Qwen-RobotWorld负责"预判",合在一起构成一套可独立部署、也能协同运作的机器人通用底座。这是千问大模型家族首次完整布局具身智能,也是阿里从数字智能迈向物理智能的一次正式落子。
大语言模型的战场在数字世界,而具身智能要解决的,是让机器人在真实物理空间里听得懂、走得稳、做得准。当前行业卡在"实验室能跑、真实场景就翻车"的临界点,换个机器人、换个场景,模型性能就打折扣——这是Qwen-Robot三款模型共同要攻克的核心难题。
Qwen-RobotManip:让机器人真正会动手
传统VLA模型最让人头疼的,是迁移能力差。Qwen-RobotManip从两个方向切入:用一套80维的统一动作表征,给不同硬件定义通用的"肢体语言",让机器人学到的是物理规律而不是生硬模仿;同时放弃依赖繁琐绝对坐标的老路,改成直接基于摄像头画面中的相对位置操作,面对环境变化时反应更快、更准。部署到新硬件上时,只需数步反馈就能自动适配——有点像老司机坐进陌生车辆,试几脚油门就能上路。
训练规模上,Qwen-RobotManip在超过38000小时的语料上完成预训练,且全程只用开源数据,没走私有自采的常规路径。在横跨30项真实世界任务、4个机器人平台的三方真机测评RoboChallenge Table30 v1中,代号"Lira"和"Atlas"的两个版本分列前两名,成功率达到45%,领先第三名20%,任务涵盖拧水龙头、插网线、双臂倒薯条等高难操作。
Qwen-RobotNav:让机器人自己找路
VLN模型解决的是移动问题。以往这类模型有个通病——记忆策略死板,记少了迷路,记多了混乱。Qwen-RobotNav引入任务自适应观察机制,根据任务类型灵活切换记忆策略,把指令跟随、点/目标导航、目标追踪、自动驾驶四类任务统一在同一框架下,不用人工切换模型。
更重要的是,它被设计成一个通用接口,可以被上层模型直接调用,是业内少数原生支持多种智能体框架的VLN模型。实际效果怎样?对着搭载该系统的宇树Go2四足机器人说"帮我找找不记得放在哪的行李箱",它能一边自主巡逻一边做视觉推理,最后顺畅完成寻物导航。
Qwen-RobotWorld:让机器人先"脑补"再动作
会动手、能跑腿,还差最后一块——提前预判。Qwen-RobotWorld本质上是一个物理世界模拟器,基于对物理规律的理解,推演出下一时间点机器人合理的动作和状态。
实际使用中,它有两个作用:
一是生成视频数据来扩充训练集,大幅缓解数据匮乏的问题;
二是在执行动作前帮机器人提前推演动作轨迹,让操作更到位、更精准。
三款模型在具身智能多项评测中拿到SOTA。
如果把Qwen-Robot系列放在更大的视角下看,它代表着千问从数字智能体向物理智能体的跨越。手、脚、大脑三个模块各司其职,又能在统一的自然语言指令下协同工作,这套"通用大脑"接下来将陆续搭载到更多形态的机器人上。机器人能去哪、能做什么、会有什么后果——这些问题,阿里正在尝试用大模型的方式给出答案。
 AI 速览