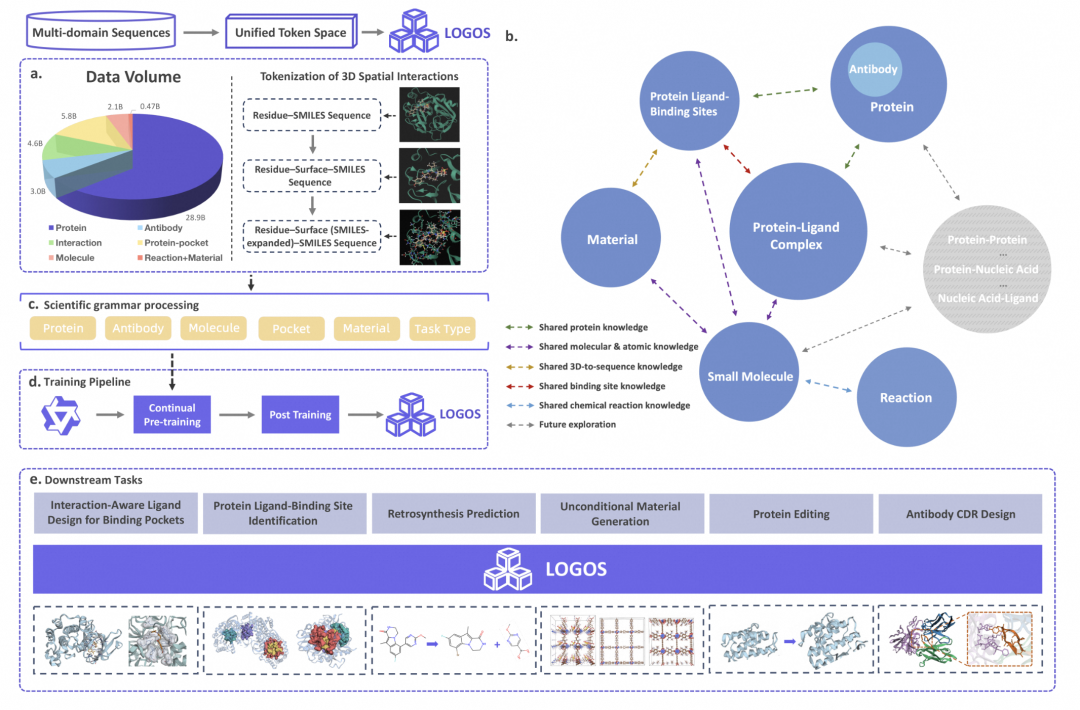
近日,阿里巴巴ATH-Token Foundry 联合中国人民大学高瓴人工智能学院正式开源了 LOGOS(Language Of Generative Objects in Science)——首个基于统一"科学语法"的多领域科学生成基础模型。它在蛋白质、小分子、材料和化学反应等六大科学任务上,以纯序列建模范式一致性地匹配或超越了领域专用方法,其中1B参数版本仅用1/56的参数量就在多个任务上超越了 8×7B 的 NatureLM。
核心洞察:科学对象本就是同一种语言的方言
AI for Science 当前的主流路径,是为每个问题训练一个专家模型——结构预测、分子生成、逆合成规划各有一套独立的模型与技术栈,且大多依赖稀缺的 3D 坐标数据和专用的几何网络,与 LLM 生态的成熟工程基建完全割裂。
LOGOS 团队的核心洞察在于:蛋白质、小分子、材料虽然表面各异,但底层遵循着相似的组成规则、结构约束和相互作用语义——它们本就是同一种"科学语言"的不同方言。统一语法能让跨领域知识迁移、多任务协同优化、预训练与下游目标对齐成为可能。
三项关键设计
1. 统一"科学语法" + 空间交互离散化
这是 LOGOS 最具突破性的设计。它包含两个层面:
- 统一词汇表:将蛋白质、小分子、材料等异构对象全部编码为统一的离散 Token 序列,让它们在同一个生成空间中被大模型自回归地理解和生成。
- 空间序列化:把 3D 空间接触模式"语法化"为离散 Token——通过残基标注序列、表面接触序列和对齐转换序列,完全不需要输入 3D 坐标,仅靠序列预测就能构建出空间互作规律。
2. 预训练与下游任务形式-目标完全一致
传统范式中换一个研究环节就得换一套模型。LOGOS 的科学语法让预训练数据的序列形式等于下游任务的输入输出形式,预训练的 next-token prediction 等于下游的条件生成目标——消除了"学用脱节",无需大量微调即可激活生成能力。
3. 跨领域知识正向迁移
团队通过多项实验证实了统一语法的有效性:
- "跨语言翻译"能力:模型看到蛋白质口袋序列,能直接"翻译"出小分子的 SMILES 结构
- 组分必要性验证:去除口袋与复合物数据后性能接近随机(Vina -3.57),加入全部语法组分后跃升至 -7.64
六大任务实战成绩
| | |
|---|
| 超越 NatureLM(8×7B),纯序列范式首次打败 3D 扩散模型 | AI 制药核心场景,生成分子满足结合亲和力、药物相似性和合成可行性三重要求 |
| Top-1 准确率 74.8%,全面超越所有基线方法 | 化学家可直接用 LOGOS 辅助设计合成路线,减少试错成本 |
| HOLO4K 数据集 Top-n 准确率 58.5%,超越传统 3D 方法 | 将口袋识别从"依赖 3D 结构"扩展至"仅需序列信息"的新范式 |
| NBB 从 MOFFlow-2 的 10.10% 提升至 17.78%,提升 76% | |
| Hard 难度 Fitness 0.93,相比基线 0.34 提升 174% | |
| AAR 达 79.82%,超越结构依赖的逆折叠方法 RADAb | |
44.87B tokens 预训练语料:遵循科学知识体系
LOGOS 严格遵循科学界的知识体系来选择模态,构建了涵盖 7 类模态、总计 44.87B tokens 的预训练语料库:
- 生物大分子层:蛋白质(28.9B tokens)+ 抗体(3.0B tokens)
- 化学实体与转化层:小分子(2.1B tokens)+ 化学反应与 MOF 材料(0.47B tokens)
- 界面互作层:蛋白质口袋(5.8B tokens)+ 蛋白口袋-配体复合物(4.6B tokens)
三层结构确保知识面既广且深,且符合真实的科学规律。
LLM 生态深度对齐,降低部署门槛
LOGOS 的一个重要战略选择是:让科学基础模型与大语言模型深度对齐——共享架构、共享训练范式、共享推理基础设施。通过继承 LLM 的预训练权重,科学模型能直接复用 vLLM 推理加速、模型量化等成熟基建,大幅降低训练与部署成本。统一的语法空间也打破了学科壁垒,让生物、化学、材料等不同领域的数据在同一个模型框架内回流训练,形成跨领域的知识闭环。
获取方式
LOGOS 已完整开源模型权重、推理代码与技术报告:
从"筛选已知"到"设计未知",LOGOS 正在推动自然科学研究向"设计驱动"与"发现驱动"转变。未来团队将进一步把"科学语法"扩展至基因组等更多领域,并探索科学语言与自然语言的深度融合。
 AI 速览