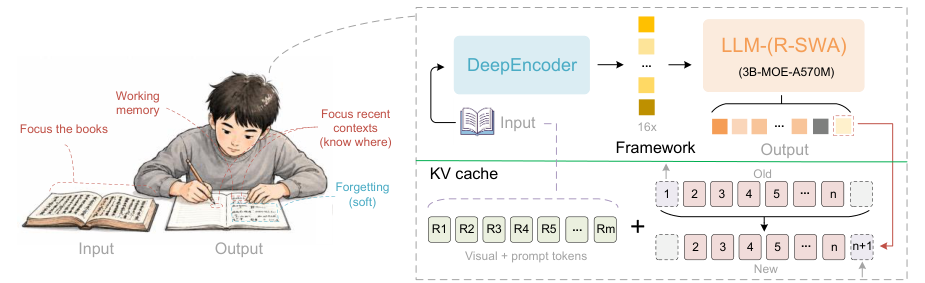
6月23日消息,百度在 Hugging Face 发布 Unlimited-OCR,定位"One-shot Long-horizon Parsing"——一次性解析长文档,不需要分页裁切再拼接。3B 参数,MIT 协议开源,模型权重、推理代码和 GitHub 仓库同步上线。
模型卡上写得很直接:"aiming to push DeepSeek-OCR one step further"。Unlimited-OCR 基于 DeepSeek-OCR 架构构建,继承了其视觉压缩(Contexts Optical Compression)的核心思路,但在长文档连续解析上做了针对性优化。致谢部分列出 DeepSeek-OCR、DeepSeek-OCR-2 和 PaddleOCR 三个项目。 需要澄清一个常见混淆:Unlimited-OCR 发布在 baidu/ 命名空间下,不是飞桨团队的 PaddlePaddle/ 系列。它和 PaddleOCR-VL(0.9B 参数,NaViT + ERNIE 架构)是完全不同的产品线。百度内部目前有两条 OCR 技术路线并行。
技术拆解:Gundam 模式与 Base 模式
Unlimited-OCR 提供两种推理配置。Gundam 模式(base_size=1024,image_size=640,crop_mode=True)适合单页文档,通过裁切拼接的方式处理高分辨率图像。Base 模式(image_size=1024,crop_mode=False)处理全图,用于多页文档和 PDF 批量解析。多页和 PDF 场景仅支持 Base 模式。
推理管线支持三种输入:单张图片(infer)、多张图片序列(infer_multi)、PDF 自动转图再批量解析(通过 PyMuPDF 实现页面光栅化)。SGLang 部署方案已同步提供,支持 OpenAI 兼容 API 和流式输出。关键参数包括 max_length=32768(最大生成 Token 数)和 no_repeat_ngram_size=35(防止输出重复的 n-gram 过滤窗口)。
从代码结构看,Unlimited-OCR 复用了 DeepSeek-OCR 的 NGram 重复抑制逻辑(DeepseekOCRNoRepeatNGramLogitProcessor),这进一步印证了它的技术血统。
三条 OCR 路线怎么选
2026 年开源 OCR 赛道形成了三条清晰的技术路线:
DeepSeek-OCR-2(3B 参数,2026 年 1 月发布):核心创新是 DeepEncoder V2 的 Visual Causal Flow 机制,用 LLM 风格的编码器替代传统 CLIP,在 OmniDocBench v1.5 上得分 91.09%。强在阅读顺序准确性和视觉压缩效率,弱在复杂金融文档上准确率下降 15-25%。
PaddleOCR-VL-1.6(0.9B 参数,2026 年 5 月发布):超轻量级,NaViT + ERNIE-4.5-0.3B 架构,在 OmniDocBench v1.6 上达到 96.33% SOTA。支持 109 种语言,包括藏文和孟加拉文。强在资源效率和多语言覆盖,适合边缘部署。
Unlimited-OCR(3B 参数,2026 年 6 月发布):基于 DeepSeek-OCR 架构,聚焦长文档一次性解析。目前没有公开基准测试数据——论文标注"Coming soon",这是最大的不确定性。
选型建议:如果优先考虑轻量部署和多语言,PaddleOCR-VL-1.6 是当前最优解;如果处理大量英文商业文档且有 GPU 预算,DeepSeek-OCR-2 有最完整的基准验证;Unlimited-OCR 适合想要长文档端到端解析的早期尝鲜者,但需等待基准数据公布后再做生产决策。
对开发者和内容创作者的实际价值
独立开发者和内容创作者天天处理 PDF、扫描件、合同、发票、学术论文。传统 OCR 流程需要分页、裁切、逐页识别、再拼接——Unlimited-OCR 的"一次性长文档解析"直接砍掉了这个工作流中最繁琐的环节。
MIT 协议意味着可以直接集成到商业产品中,无需担心授权问题。3B 参数的模型在单张消费级 GPU(16GB VRAM)上可以运行,不需要企业级算力。配合 vLLM 或 SGLang 部署,可以搭建本地化的文档解析 API,数据完全不出本地环境——对处理敏感文档的场景(法律、财务、医疗)尤其重要。
局限与风险
第一,没有基准数据是最大的红旗。模型卡上论文标注"Coming soon",没有在 OmniDocBench 或 Fox 等标准测试集上公布成绩。没有基准对比,就无法判断 Unlimited-OCR 相对于 DeepSeek-OCR-2 和 PaddleOCR-VL-1.6 的实际性能差距。在技术报告发布之前,任何关于"性能更强"的说法都是猜测。
第二,模型刚发布不到 48 小时,Hugging Face 上的月下载量仅 47 次,社区反馈几乎为零。没有经过大规模用户验证的模型,在边缘案例(歪斜扫描、水印文档、手写体、低分辨率图片)上的表现完全未知。DeepSeek-OCR 在基准上达到 97% 但生产环境降到 75-80% 的案例表明,基准成绩和实际部署之间存在巨大鸿沟。
第三,"基于 DeepSeek-OCR 架构"意味着它继承了同样的局限。DeepSeek-OCR 系列在超过 10 倍压缩比时准确率急剧下降,1200+ Token 的文档仅 59.1% 精度;金融报表的编辑距离(0.289)几乎是基准成绩(0.134)的两倍。Unlimited-OCR 是否解决了这些问题,在没有技术报告的情况下无法判断。
 AI 速览