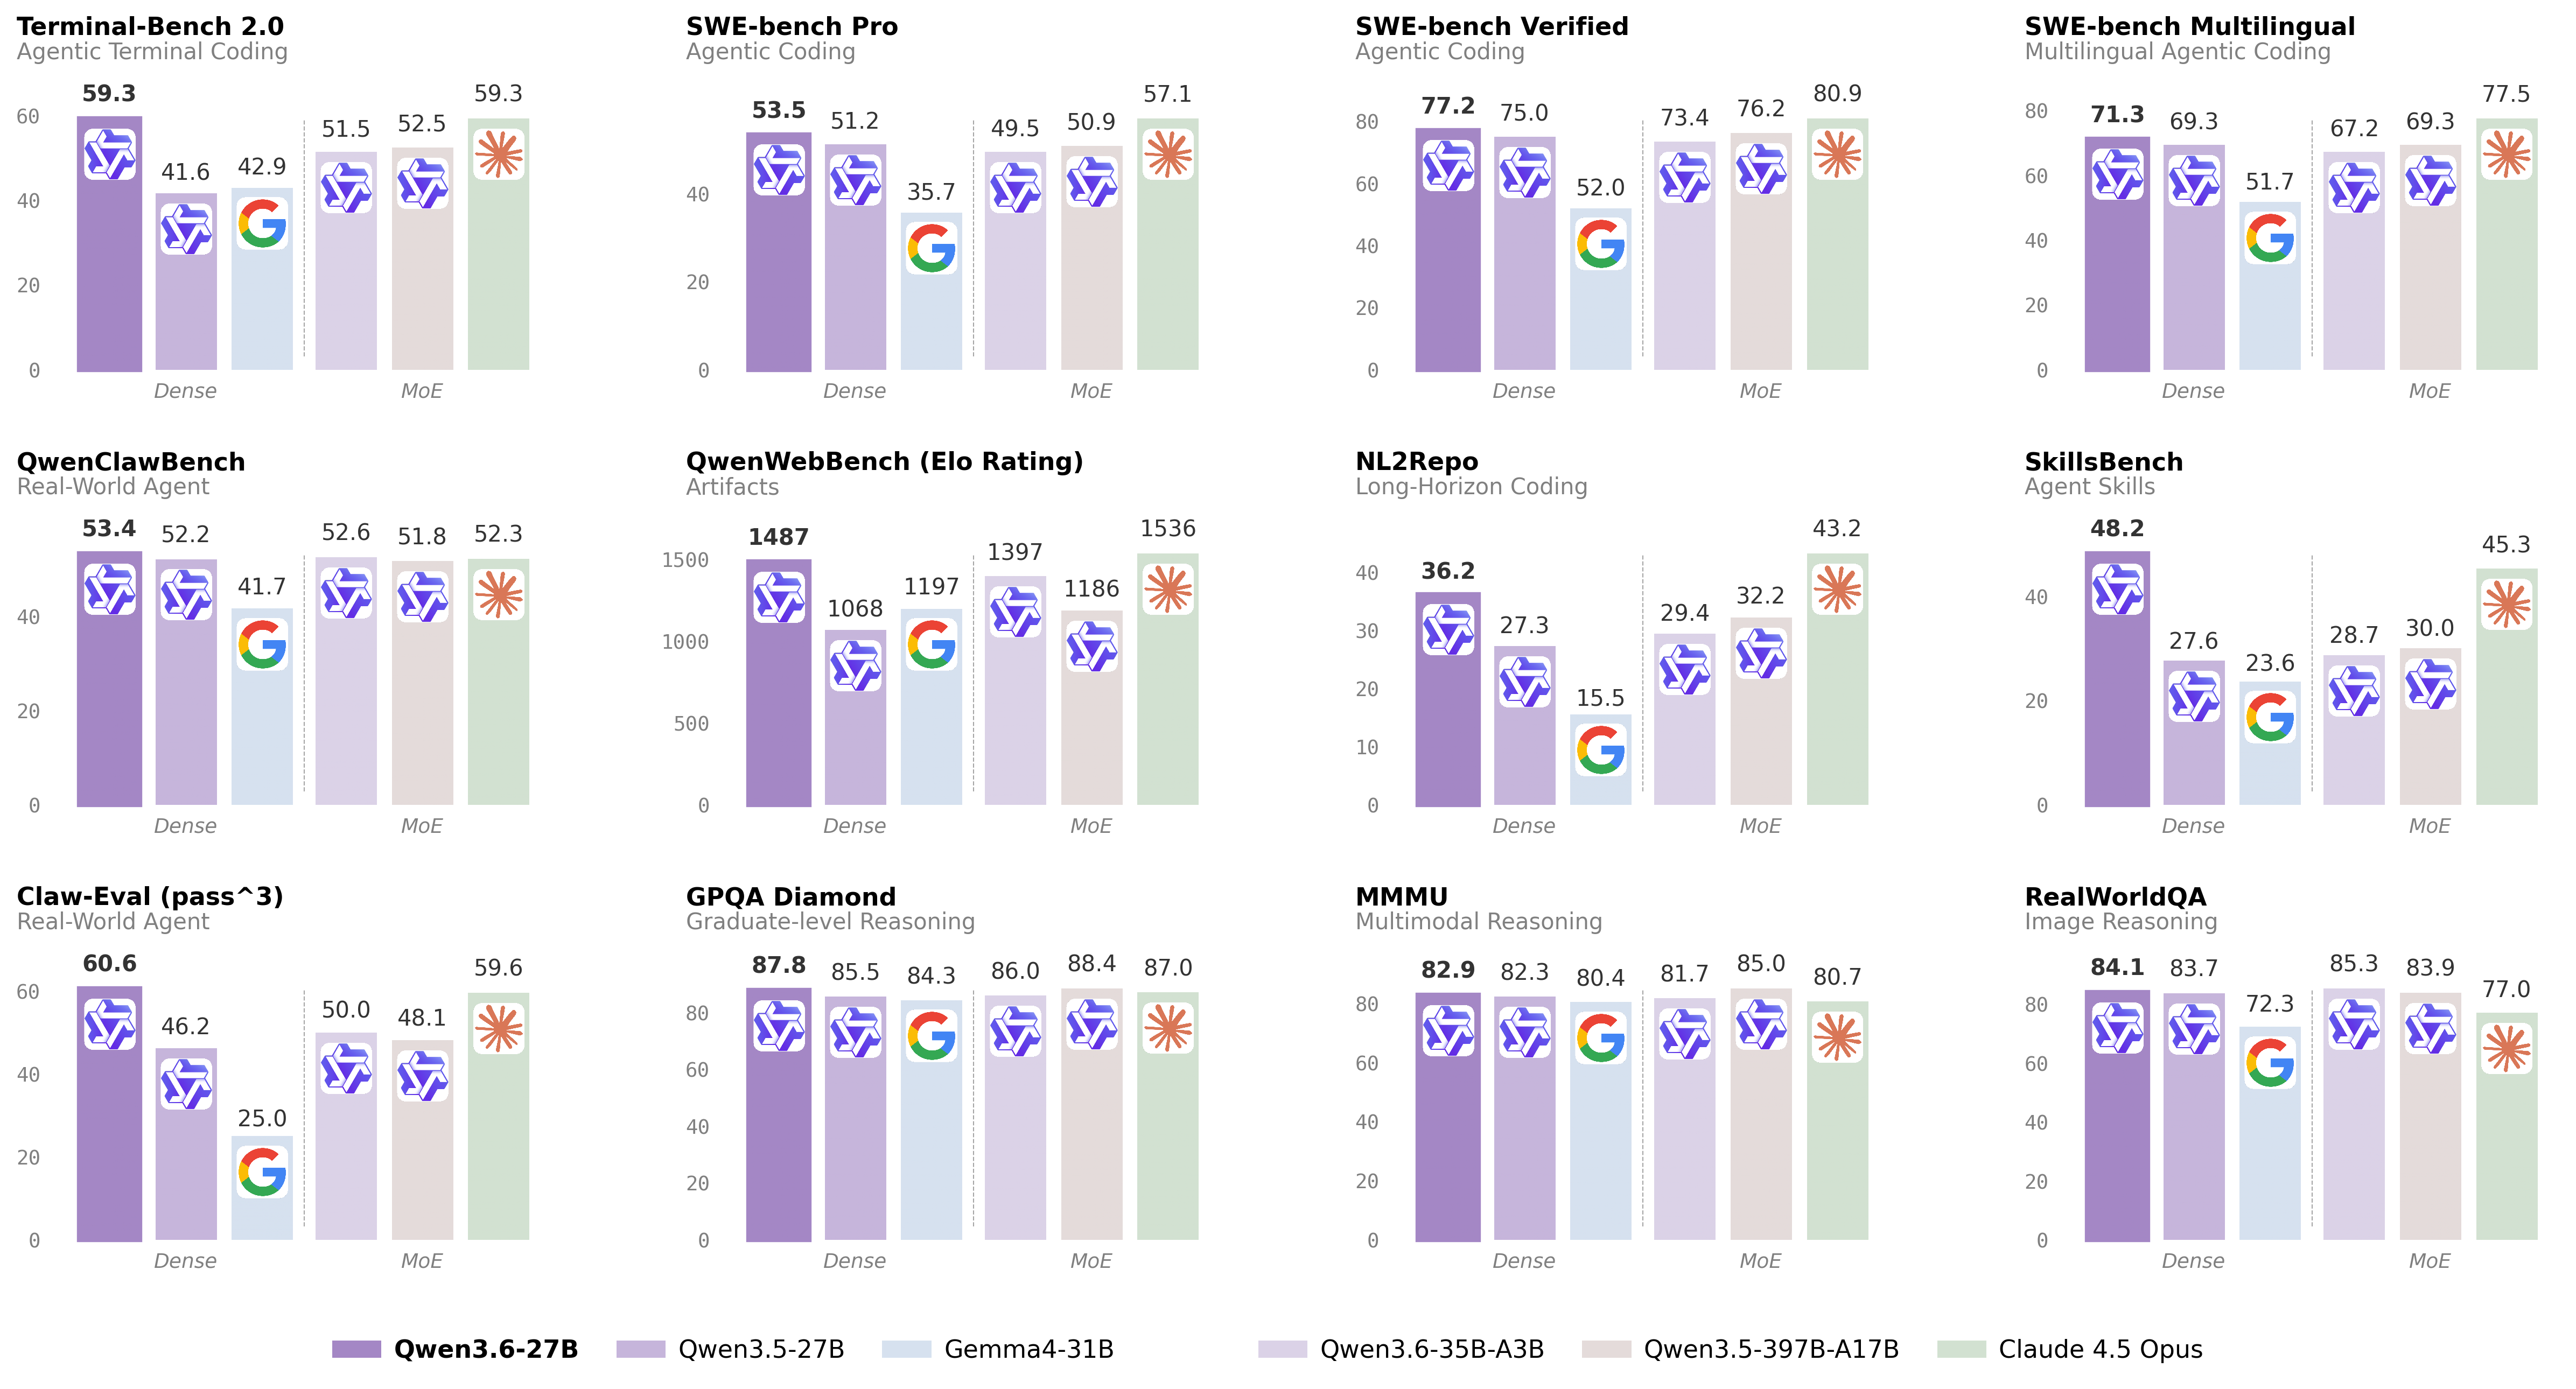
4月23日消息,阿里通义千问团队开源 Qwen3.6 系列最新模型 Qwen3.6-27B——一个 270 亿总参的稠密多模态模型,在 SWE-bench、Terminal-Bench 2.0、SkillsBench 等智能体编程权威基准上反超前代开源旗舰 Qwen3.5-397B-A17B(总参 397B、激活 17B 的 MoE 模型)。模型以 Apache 2.0 协议开源权重,原生支持文本、图像、视频三模态,单个 checkpoint 同时提供思考与非思考两种模式。 SkillsBench 拉开 18.2 分,SWE-bench Verified 反超 1 分
核心基准对比(Qwen3.6-27B 稠密 vs Qwen3.5-397B-A17B MoE):SWE-bench Verified 77.2 vs 76.2,SWE-bench Pro 53.5 vs 50.9,Terminal-Bench 2.0 59.3 vs 52.5,SkillsBench 48.2 vs 30.0。差距最大的 SkillsBench 拉开 18.2 分,Terminal-Bench 2.0 拉开 6.8 分。
稠密架构在推理时每个参数都参与计算,要让整体能力提升必须压榨每个参数的性能密度。27B 稠密版本能反超 397B 总参的 MoE 模型(激活 17B),说明 Qwen 团队在后训练阶段的智能密度优化起到了关键作用。对本地部署场景来说,这意味着不需要承担 397B 总参的显存、KV cache 和专家路由开销,就能获得接近甚至超过的编程能力。
262K 上下文原生支持,三模态 + 双模式集成于单 checkpoint
技术栈层面,Qwen3.6-27B 原生上下文窗口 262,144 tokens,通过 YaRN 可扩展至约 101 万 tokens;通过集成视觉编码器原生支持文本、图像、视频三模态输入;单个 checkpoint 同时覆盖 thinking 和 non-thinking 两种模式,切换开销低;为智能体工作流新增 preserve_thinking 选项,在多轮对话中保留历史推理上下文,减少迭代式开发的重复思考开销。
硬件门槛方面,Unsloth 社区的 Dynamic 2.0 GGUF 量化版本在总内存约 18GB 的设备上即可运行,覆盖 Apple Silicon Mac(如 M 系列 32GB 机型)和消费级 GPU(如 RTX 4090 24GB)两类典型个人开发者环境。
OpenClaw / Qwen Code / Claude Code 三方工具即时对接
开源权重已在 Hugging Face 和 ModelScope 上线(同步提供 FP8 版本),企业和开发者通过阿里云百炼 API 调用(模型 ID qwen3.6-27b ),或在 Qwen Studio 直接体验。
工具生态方面,该模型即时适配三款主流智能体编程工具。OpenClaw(自托管开源编码智能体)通过编辑 ~/.openclaw/openclaw.json 将 provider 指向百炼即可接入;Qwen Code(针对 Qwen 系列深度优化的终端智能体)通过 npm install -g @qwen-code/qwen-code@latest 一键安装;Claude Code 则依赖阿里云 Dashscope 提供的 Anthropic API 兼容协议,设置 ANTHROPIC_BASE_URL=https://dashscope.aliyuncs.com/apps/anthropic 即可切换底层模型。对同时使用多种 Agent 工具的开发者来说,"一处调用、多处兼容"降低了框架切换成本。 局限:闭源前沿对比缺失、评估环境未对齐
几项信息需要读者自行补全,避免仅凭官方跑分做结论。
第一,官方基准对比集中在 Qwen 同系列(Qwen3.6-27B vs Qwen3.5-397B-A17B vs Qwen3.5-27B 等),未给出对 gpt-5.4、Claude Sonnet 4.6、Gemini 3.1 Pro 等闭源前沿模型的直接跑分对比;以闭源的 Qwen3.6-Plus 在 Terminal-Bench 2.0 上的 61.6 分作参照、27B 版本拿到 59.3 分来看,27B 稠密版在绝对排名上仍落后于 Claude Opus 系列在同场景下的配置,开发者需要按自己的实际业务跑测验证。 第二,所有基准跑分均为 5 次运行的平均值,官方未披露标准差或 best-of-N 曲线,生产环境下的单次可靠性可能低于平均跑分。
第三,SWE-bench 系列使用的是 Qwen 团队自建 agent scaffold(bash + file-edit 工具、200K 上下文、temp=1.0/top_p=0.95),且官方对 SWE-bench Pro 公开集做了"问题任务修正"后重跑所有基线,这套评估环境与公开排行榜的原版 scaffold 存在差异,跨模型横向比较时需注意对齐评估条件。
第四,QwenClawBench 是 Qwen 团队自建的"真实用户分布 Claw 智能体基准",暂未公开,第三方无法独立复现该项数字。
如何看这次开源
对国内开源 LLM 生态来说,Qwen3.6-27B 的意义不只是"多一个开源模型"。"稠密 27B 超越 MoE 397B"这条数据指向一条工程路径——在后训练数据和智能密度压榨到位的前提下,27B 量级已足以承载 Agent 编程场景的主力工作负载,而 27B 恰好是消费级硬件和小型企业私有化部署的"舒适区"。对"本地部署优先"的开发者、以及 OpenClaw、Hermes Agent 等自托管智能体框架来说,这是从"能用"到"可替代闭源 API"的关键节点。 下一个看点是 Qwen3.6 系列的更大尺寸开源版本何时出现,以及 GLM、DeepSeek、MiniMax 等厂商在稠密路线上的跟进速度。  AI 速览