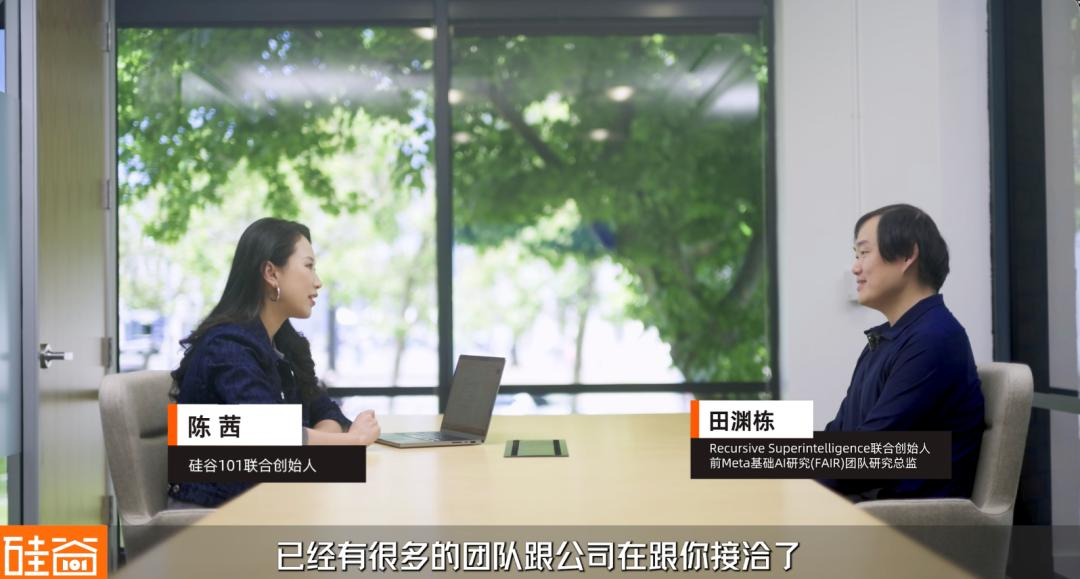
在最近的《硅谷101》节目中,前 Meta FAIR 研究总监田渊栋接受了采访,他认为编程赛道的商业逻辑已经被验证——Claude Code、Codex、Cursor 正在替代年薪数十万美元的软件工程师。但这条赛道的天花板肉眼可见:一旦所有玩家都达到"够用"的能力线,竞争就会退化为价格战。他给出的判断是,编程之后,AI 自动化科研才是真正的高回报赛道。围绕这个判断,他与另外 7 位顶级研究员共同创立了 Recursive Superintelligence(RSI),融资 6.5 亿美元,估值 46.5 亿美元。 8 位联创、零产品、46.5 亿估值:资本到底在买什么
RSI 的融资数字在 Neolab 阵营中属于第一梯队,但公司至今没有发布任何产品。田渊栋对此的解释很直接:最顶级的资本还是看人。8 位联合创始人的履历覆盖了预训练、强化学习、世界模型、Agent 工程和商业化运营的完整链条——Richard Socher 此前创立 MetaMind 并被 Salesforce 收购,Tim Rocktäschel 在 Google DeepMind 主导了 Project Genie 1/2/3 和 Agent Open-Endedness 方向,Jeff Clune 的 AI Scientist-v2 已被 Nature 收录,Alexey Dosovitskiy 是 Vision Transformer 一作,Josh Tobin 曾任 OpenAI Agent Science Lead。Google Ventures 参与了本轮投资,田渊栋透露 Tim Rocktäschel 在 Google 内部的背调评分对融资有很大贡献。
团队目前 25 人,计划扩充至 40 人左右。田渊栋坦言,按当前烧钱速度,6.5 亿美元的 runway 大约只有两到三年。
递归自我改进:不是让 AI 写代码,而是让 AI 优化 AI 本身
RSI 的核心技术路线是 Recursive Self-Improvement——用 AI 来优化 AI 自身的训练过程、研究方法和知识发现效率。田渊栋将其拆解为两步:第一步是让 AI 替代研究员的重复性劳动,第二步是让 AI 自主产生新假设并验证。公司官网将目标概括为"最大化知识发现速率"(maximizing knowledge discovery rate)。
这与 Google DeepMind 的 AlphaEvolve 有本质区别。AlphaEvolve 用 LLM 变异和组合算法来优化特定代码,仍然是 AI 优化某个具体对象;RSI 的目标是 AI 优化自己——模型训练的 recipe、推理效率、甚至架构搜索本身都在优化范围内。
田渊栋评估当前进展时给出了一个坦率的数字:如果最终目标是 10,现在大约在 0.5 到 2 的位置,而且翻过已知的山之后,后面可能还有 100。他预计第一年到一年半内完成系统搭建,之后再寻找落地场景。商业化方面,他列举了几条可能路径:训练出更高效的推理方案可以直接卖效率,发现新的训练 recipe 本身就有商业价值,而 AI for Science 方向(新药、新材料)则是高风险高回报的长线赌注。
竞品全景:SSI 保密、AMI Labs 太早、Ineffable Intelligence 太纯粹
Neolab 阵营正在快速分化。田渊栋逐一给出了评价:
Ilya Sutskever 的 SSI 极度保密,外界完全不知道内部在做什么,但可能在探索全新的训练范式——他去年的公开访谈中提到的泛化、记忆等问题与田渊栋自己的研究方向高度重合。Yann LeCun 的 AMI Labs 押注视觉世界模型和机器人,田渊栋对此持保留态度:语言的信息密度和可嵌套性远高于像素,上限可能更高,JEPA 系列的视觉模型"可能还太早了"。David Silver 的 Ineffable Intelligence 想用纯强化学习复现 AlphaZero 的"左脚踩右脚"路线,但田渊栋认为在开放域中缺乏明确的评价函数,算力需求可能无法满足。Thinking Machines Lab 最近发布了持续交互模型,方向偏向人机交互,与 RSI 的路线正交。
田渊栋对所有 Neolab 的共性挑战有一个核心判断:以前在大厂做实验可以花几亿美元,公司买单;现在自己融资,必须找到比 Scaling Law 堆算力更聪明的方法。"如果一个人只有 Scaling Law 这个思想,可能不太容易成功。"
前沿模型之争的本质:不是算法之争,是组织架构之争
访谈中最尖锐的部分是田渊栋对大厂组织问题的分析。他指出 xAI 和 Llama 4 的问题如出一辙:CEO 急于求成,组织中层无法有效 push back,最终交付与承诺脱节,引发"地震"式重组。他将其归纳为"先进生产力与落后生产关系之间的矛盾"。
大厂的另一个结构性问题是趋同化。方向由高层自上而下制定,而高层倾向于追热点——编程 Agent 火了所有人都做编程 Agent。田渊栋以 Anthropic 为正面案例:在所有人刷数学 benchmark 的时候,Anthropic 坚持押注 Coding,不发布数学成绩,最终证明这条路能赚钱,"突然之间所有人都涌过来了"。他认为 Anthropic 和 OpenAI 的下一轮竞争焦点不再是模型能力本身,而是谁能让用户持续付费——一旦进入上市和收入叙事,研究实验室的逻辑就让位给资产负债表的逻辑。
关于 Anthropic 的 Mythos 模型,田渊栋注意到其在图搜索问题上表现远超前代,行业猜测可能使用了 Looped Transformer 等新架构,但他表示"去问 A 家的人,他是不会回答的"。他同时给出了一个关键技术判断:预训练的上限决定了强化学习的上限。强化学习本质上是把模型已有答案中排在第 200 名的正确答案提到第 1 名,但如果正确答案的种子根本不存在,强化学习再做也没用。
RSI 的三重挑战:算力约束、评估悖论与路线风险
RSI 的路线面临三个层面的结构性挑战,值得持续关注。
第一是算力约束。递归自我改进需要大量计算资源做实验迭代,而 RSI 的资金 runway 只有两到三年。田渊栋承认可解释性研究的一个实际动机正是降低试错成本——如果能在训练过程中提前评估模型质量,就不必等到训练完成才判断好坏。但可解释性本身仍处于早期阶段,能否真正转化为效率提升是未知数。
第二是评估悖论。当 AI 系统开始自主设计实验和评估结果时,"评估评估者"的递归难题就会浮现。田渊栋的回应是:短期内人类仍然可以作为评判者,长期来看评估会从中间 benchmark 转向最终结果导向——但这也意味着中间过程变成了黑盒,这与他同时强调的可解释性目标存在内在张力。
第三是路线风险。RSI 选择了一条大厂目前无暇顾及的方向,这既是差异化优势也是赌注——如果大厂在适应新生产力工具后回过头来投入同一方向,小团队的 focus 优势可能被资源优势碾压。田渊栋自己也承认"这个也很难",他的反驳逻辑是大厂的执行效率不如想象中高,但这并不构成长期壁垒。对于一家尚无产品、runway 有限的公司而言,能否在窗口期内产出足够有说服力的阶段性成果,是决定其后续融资能力和生存空间的核心变量。
 AI 速览