如果你长期靠 AI 辅助写代码,Kimi K2.7-Code 和 Claude Code 两款工具总会让你纠结,两者底层逻辑完全不同,适配的开发场景天差地别。 两款模型底层架构,从根源就不一样
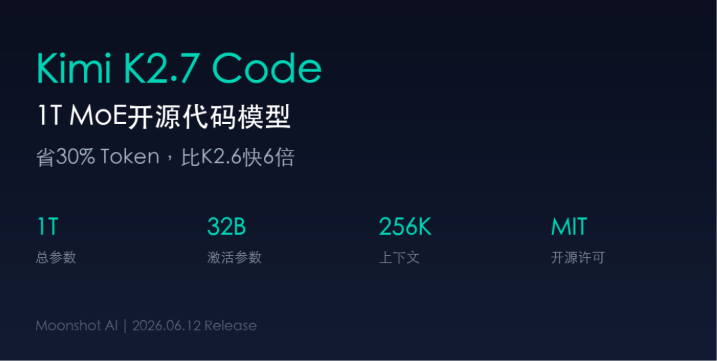
Kimi K2.7-Code 是月之暗面刚更新的开源混合专家模型,1.1 万亿总参数,但每次推理只激活 32B 参数,384 个专家模块按需调度,专门针对工具调用、多智能体协同做了大量训练优化。它有个硬性设定,思考模式无法手动关闭,API 参数里禁用思考会直接报错,网页端强行关闭思考功能会自动降级到 K2.6 版本。相比上一代 K2.6,整体思考消耗的 token 直接减少三成,高频调用能省下不少成本。256K 上下文窗口是它的标配,权重完整开源支持本地私有化部署,商用授权门槛很低,小型开发团队很容易落地,只是量化版本最低也需要六百多 GB 显存,普通消费级显卡很难流畅运行。 Claude Code 没有独立专属模型,完全依托 Anthropic 自家 Opus、Sonnet 系列闭源稠密架构模型运行,没有拆分专家模块,推理流程更偏向线性深度思考。标称 200K 上下文窗口,但系统提示词、内置 Skill 会占用大量额度,实际留给代码读写的可用长度会明显缩水,官方从未开放模型权重下载,不存在原生本地私有化部署方案,只能通过官方 API 或者 IDE 插件调用,所有上传的代码片段都会经过海外云端服务器处理,数据隐私层面天然存在短板。Anthropic 企业版仅提供云端隔离集群服务,代码仍存储在海外服务商服务器,无法将模型部署至企业本地内网,和 Kimi 完整权重本地私有化有本质区别。它没有强制思考机制,简单脚本需求可以跳过冗余推理,单行代码补全时响应会更轻快。 不少人会混淆第三方中转套壳和原生私有化,网上那种修改接口地址对接其他开源模型的客户端,只是借用 Claude Code 交互外壳,底层运行的并非 Claude 本体,不能算作真正的私有化部署。Kimi 完整权重可部署在内网服务器,企业涉密代码全程不用流出内部环境,合规行业里这个差距会被无限放大。
基准测试数据,纸面优势各占一半
网上流传的各类代码评测榜单,很难直接分出绝对强弱,不同测试维度两款模型各有胜负。
MCP 工具调用相关基准里,Kimi K2.7-Code 优势非常明显,MCPMark Verified 拿到 81.1 分,反观 Claude Code 对应的 Opus 版本仅 76.4 分,批量联动终端、第三方接口、MCP 服务时,Kimi 出错概率更低,多步骤工具串联不容易断流程。如果你的日常工作需要频繁调用接口、执行自动化脚本,这个差距会实实在在影响开发效率。
但纯代码逻辑、大型工程重构的基准测试,风向直接反转。Kimi 自家 Code Bench v2 仅 62 分,Claude Opus 能冲到 67.4 分,面对多层级项目架构、跨模块复杂逻辑、底层算法编写时,Claude 生成的代码漏洞更少,幻觉概率被压得很低,很少出现逻辑自相矛盾的情况。
还有个容易被忽略的细节,Terminal 终端实操测试,Claude 得分 71.2,高于 Kimi 的 66.7,该基准仅针对单条 Shell 运维命令场景,批量自动化 Agent 任务里 Kimi 的稳定性反而更强,处理单次 Git 命令、服务器部署脚本时,Claude 给出的命令系统兼容性更强,踩兼容坑的次数会少很多。
代码输出风格,适配不同开发习惯
同样一段字符串处理需求,两款模型写出来的代码风格能看出明显区别,没有好坏,只看你的团队编码规范。
Claude Code 写出来的通用业务代码冗余度更高,但可读性拉满。每一个函数、判断分支都会附带详细注释,变量命名偏向长语义化单词,会单独抽离常量、例外词表做分离定义,后续其他同事接手维护,不用反复追问代码逻辑。适合多人协作的中大型团队,代码可维护性优先级高于简洁度,生成的单元测试用例分支覆盖也更全面。加密、底层内核这类高安全代码,两款模型都会自动补齐完整注释,不会出现极简无说明的写法。
Kimi K2.7-Code 偏爱极简写法,大量使用正则、链式调用压缩代码行数,通用业务场景不会额外堆砌注释,更贴合 Pythonic、简洁后端脚本的开发习惯。处理海量文本、批量数据清洗任务时,同等功能代码行数能少三分之一。个人独立开发者、写自动化小工具、爬虫脚本这类单人项目,用它写出来的代码会更清爽。
有次测试同一个分页查询接口,Claude 分了五个函数拆分逻辑,Kimi 直接用链式查询完成核心逻辑,两种写法都能正常运行,只是适配的工程场景完全不同。
生态与工具集成,成熟度差距肉眼可见
Claude Code 上线运营时间更早,社区沉淀了接近一年,生态完善度甩开 Kimi 一大截。
Stack Overflow、GitHub 社区能搜到海量实操案例,几百款社区自制 Skill 工具可以直接接入,还有 cc-switcher、claude-mem 这类第三方辅助插件,VS Code、JetBrains 全系列 IDE 深度适配,本地文件读取、多文件批量修改、冲突自动处理都做了长期优化,随便搜一个报错,基本都能找到现成解决方案。官方免费网页端仅开放 Haiku 轻量模型,每日固定 token 额度,批量工程重构、多文件上传等高阶功能全部锁定,重度开发必须付费订阅 Pro 套餐。 Kimi K2.7-Code 的生态还处在起步阶段,官方配套工具只有自家 CLI 和网页插件,第三方社区工具几乎空白,Skill 系统内容寥寥无几,遇到 MCP 服务冲突、大文件上传崩溃这类故障,只能翻阅官方文档,很难找到用户分享的踩坑经验。高负载时段稳定性也偏弱,批量上传几十份代码文件时,偶尔会出现内存溢出中断会话,Claude Code 长期使用很少出现这类崩溃问题。不过 Kimi CLI 原生适配国内文件路径、中文注释脚本,本土化优化做得更到位。
还有独一份的多模态优势,原生搭载图像编码器,截图报错、手绘流程图、设计稿丢进去,能同步解析需求生成代码;Claude 3 系列原生支持识图,但免费网页版识图功能受限,完整图片解析能力需要付费订阅解锁,做前端页面还原、截图报错排查时,Kimi 免费渠道的体验会省事不少。
调用成本与使用门槛,个人和企业选择分化
单看国内官方 API 直连计价,Kimi K2.7-Code 性价比优势突出,标准输入每百万 token6.5 元,输出每百万 token27 元,缓存命中输入仅 1.3 元,高频批量生成代码、跑自动化 Agent 任务,长期使用能省下大量开支。再加上开源权重支持本地部署,中小工作室、独立开发者可以搭建私有服务,完全规避云端按量计费,只是本地部署硬件门槛偏高,低配设备无法流畅运行。
Claude Code 的云端调用定价偏高,长期高频使用成本会成倍上涨,而且不支持原生私有化部署,预算有限的小型团队很难长期高频使用。但它有免费网页端基础额度,偶尔写小段代码、简单调试 Bug,不用充值就能临时使用,适合低频轻度开发需求。
还有一个很现实的门槛,国内网络环境下,Claude 官方海外服务访问波动极大,API 调用经常超时,第三方中转接口还存在代码数据泄露、账号封禁风险;Kimi 是国内厂商产品,国内服务器直连稳定,接口延迟更低,不用额外配置复杂网络环境,这一点对国内开发者来说,是很难忽视的加分项。
各自最适配的开发人群,不用盲目跟风
如果你是独立开发者、自动化脚本工程师、爬虫与数据处理从业者,日常大量写批量工具、多接口联动 Agent 程序,看重低成本、本地部署、识图辅助,Kimi K2.7-Code 会更贴合需求。它的多智能体协同能力能同时运行上百个子任务,长时间自动化任务不会轻易中断,自研 MCP 工具链也能无缝对接各类自建服务。
如果你在中大型团队负责项目架构、老系统重构、底层算法开发,代码需要多人长期维护,追求低幻觉、规范可读、成熟社区工具链,Claude Code 会更合适。处理上万行老项目重构、复杂跨模块 Bug 排查时,它对全局项目结构的理解更到位,生成代码的安全冗余设计更完善,线上生产环境落地调试成本更低。
不存在一款能通吃所有编码场景的 AI 模型,结合自身项目规模、使用频率、数据隐私需求去选,才能最大化提升开发效率。
 AI 速览