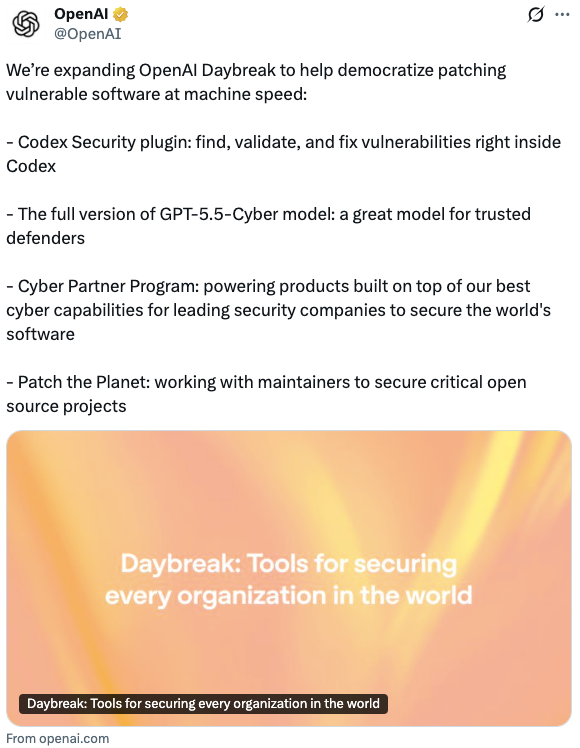
6月23日消息,OpenAI 对 Daybreak 网络安全计划进行了最大规模的能力扩展,四个核心组件同步更新。
GPT-5.5-Cyber 完整版正式发布,面向经验证的防御者开放限量访问。这是专为网络安全场景深度优化的模型变体,在 CyberGym 基准上达到 85.6%(标准 GPT-5.5 为 81.8%),ExploitGym 39.5%(标准版 25.95%,提升超过 50%),SEC-bench Pro 69.8%(标准版 63.1%)。模型设计用于在大型代码库中持续分析安全相关组件、追踪漏洞是否可达、在隔离环境中验证问题、开发和测试补丁,并为人工审查准备证据。
Codex Security 插件更新,可在 Codex 内直接发现、验证和修复漏洞。自 3 月份的研究预览以来,已扫描超过 30,000 个代码库的 3000 万次提交。
Daybreak 网络安全合作伙伴计划上线,首批合作方包括 Accenture、Akamai、Check Point、Cisco、Cloudflare、CrowdStrike、IBM、Palo Alto Networks、Zscaler 等。合作伙伴可以在自己的安全产品和服务中使用 GPT-5.5 with Trusted Access for Cyber。
Patch the Planet 倡议由 Trail of Bits 联合发起,与 HackerOne 合作,目标是帮助关键开源项目从发现漏洞到修复漏洞的全流程。已有 30 多个项目参与,包括 cURL、Go、Python、Sigstore、pyca/cryptography。
三层模型访问体系
Daybreak 建立了三层模型访问控制:标准 GPT-5.5 用于通用开发和知识工作;GPT-5.5 with Trusted Access for Cyber 面向经验证的防御工作,在授权环境中使用,由合作伙伴在其产品中集成;GPT-5.5-Cyber 是权限最高的变体,面向红队测试、渗透测试和受控验证场景,需要更强的验证和账户级控制。
这套分层设计的核心逻辑是:网络安全需要模型具备"做坏事的能力"(发现漏洞、模拟攻击),但又不能把这种能力无差别开放。OpenAI 通过访问控制而非模型能力限制来解决这个矛盾——三个版本的底层能力递进开放,但访问门槛同步提高。
国际合作层面,Trusted Access for Cyber 已与澳大利亚、加拿大、法国、德国、日本、韩国以及欧盟机构(包括 ENISA)建立合作关系。
竞品对比:Anthropic Mythos 和 Microsoft MDASH
Daybreak 的直接竞争对手是 Anthropic 的 Mythos 和 Microsoft 的 MDASH。
Anthropic 的 Mythos 于 4 月通过限量预览发布,在 SaaS 行业引发强烈反响——预览期间发现的现有软件漏洞严重到让多家企业暂停了业务。Mythos 通过 Project Glasswing 寻找技术合作伙伴,但不像 Daybreak 那样公开可请求评估。Daybreak 的差异化在于公开可及性——企业可以直接向 OpenAI 申请漏洞扫描。
Microsoft 同期披露了内部开发的 MDASH 系统(Multi-model Agentic Scanning Harness),使用超过 100 个专门化 AI 代理,在 CyberGym 基准上超过了 Mythos 的表现,计划于 6 月以预览形式向客户开放。
三家的定位不同:Mythos 侧重于发现深层漏洞的"攻击性"能力,Daybreak 强调从发现到修复的"全流程防御",MDASH 依托 Azure 生态做企业级集成。Gartner 分析师评价 Daybreak 更直接地与应用安全和态势管理能力竞争,会"补充而非完全替代"现有工具。
对安全从业者的实际影响
Codex Security 的操作模式是:为给定代码库构建可编辑的威胁模型,聚焦现实攻击路径和高影响代码;在隔离环境中识别和测试漏洞;提出修复方案。它不只是一个更好的扫描器,而是一个完整的修复循环——从发现问题到生成补丁、测试补丁、准备审查材料。
对于使用开源项目的团队,Patch the Planet 的价值更直接。cURL、Go 标准库、Python 生态中的安全问题历来依赖志愿者维护者的个人精力。有了 AI 辅助的漏洞发现和补丁生成,修复周期有望从"天"缩短到"分钟"级别。OpenAI 的说法是"以机器速度修补漏洞"。
局限与风险
第一,AI 安全工具本身就是攻击面。OWASP 连续两年将提示注入列为 LLM 的头号漏洞。一个能访问代码库的安全 Agent,如果处理了包含对抗性代码注释或依赖文件的仓库,可能被操纵执行非预期操作。OpenAI 表示 Daybreak 包含审计日志和保守默认配置(自主提交需要人工签字),但这些保障措施在实际企业环境中的可靠性尚待验证。
第二,Daybreak 的可及性仍然有限。尽管宣称比 Mythos"更公开",但 GPT-5.5-Cyber 仍然仅面向"经验证的防御者"限量开放,具体资格要求和定价均未披露。中小企业和独立开发者短期内可能只能接触到 Codex Security 的基础功能,无法使用完整的 Cyber 模型。对于 ChooseAI 读者群体中的独立开发者来说,Daybreak 的直接可用性有限。
第三,85.6% 的 CyberGym 成绩需要谨慎看待。基准测试衡量的是模型在标准化环境中发现漏洞的能力,不是在真实企业代码库中的表现。从基准到生产的落差在 AI 安全领域尤其显著——真实代码库的复杂度、规模和上下文依赖远超基准测试环境。多位安全专家指出,AI 发现的漏洞数量增长,如果没有匹配的验证和修复能力,只会产生更多噪声而非更多安全。
 AI 速览