codex可以做什么?或许大多数人的第一反应是"写代码"。但根据OpenAI最新使用报告,这个答案只触及了冰山一角。从代码理解、Bug修复、工程运维,到数据分析、文档生成、业务流程自动化,Codex正在悄然渗透进越来越多的真实工作场景。更关键的是,用户使用它的方式也在发生根本性转变——任务越来越重,并发越来越多,可复用的自动化流程正在逐步成型。你以为自己在用Codex,但你可能只解锁了它1%的能力。
用户实际在用Codex做什么?
根据OpenAI的使用报告,用户交给Codex的任务被归纳为十大类:代码实现、代码理解、代码验证、工程运维、应用管理、数据分析、研究、知识产物生成、协作支持以及业务流程处理。
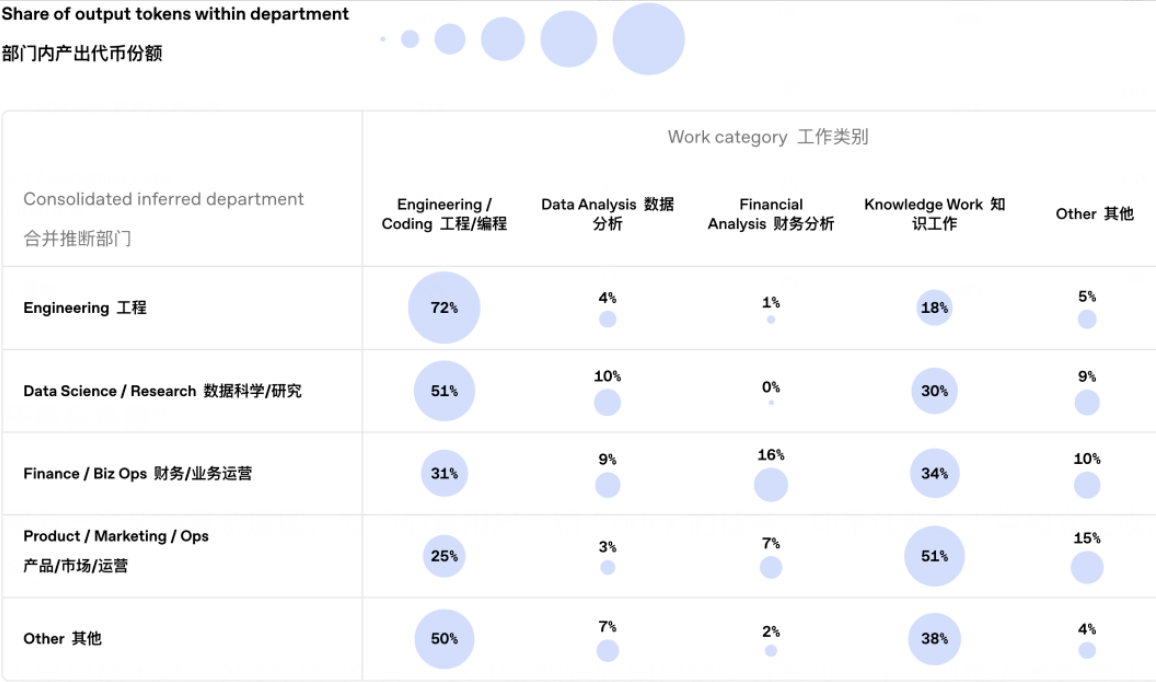
从数据分布来看,软件相关任务依然占据主体。但值得注意的是,用户并不只是让Codex写新代码——他们同样会让它阅读既有代码、解释架构设计、定位并修复Bug、执行测试、配置开发环境、管理代码仓库,乃至处理构建和发布过程中的各类问题。
到了OpenAI内部,任务边界进一步向外延伸。报告显示,OpenAI员工会用Codex辅助研究工作和数据分析;外部企业用户也开始出现类似趋势,尤其在销售、市场营销、招聘等非技术岗位,Codex被用来生成各类知识性产出物,包括操作文档、培训材料、使用说明和分析报告等。
任务有多重?数据说明问题
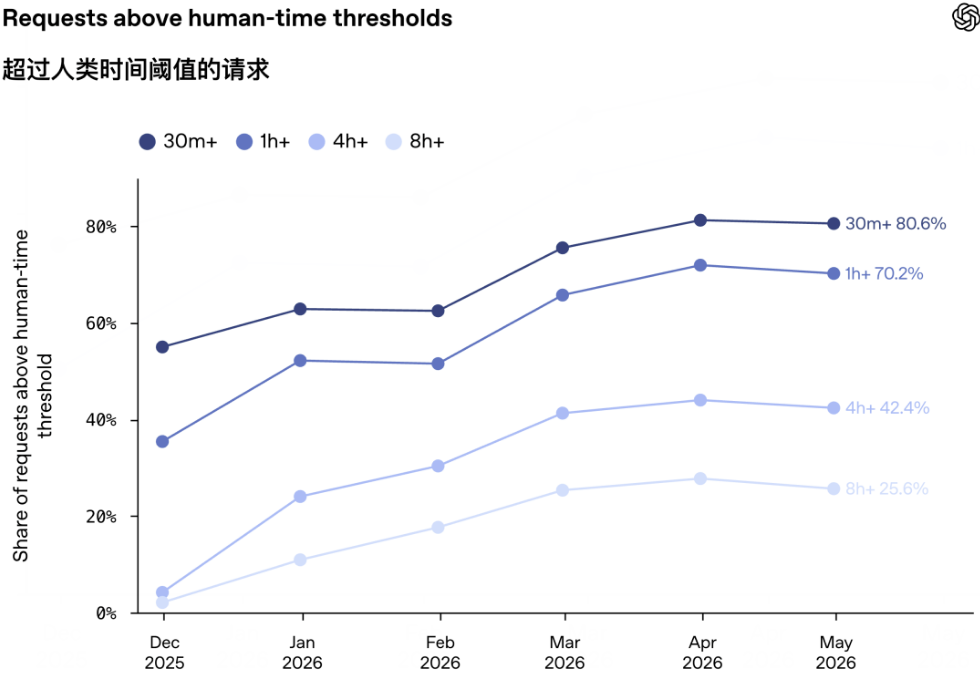
报告中有一张任务复杂度分布图,专门评估用户提交给Codex的任务——如果换成一位熟练的人类独立完成,大约需要花费多少时间。
数据的变化相当显著:
2025年12月,个人用户样本中有35.4%的活跃用户,提交过至少一个"熟练人类需要1小时以上才能完成"的任务。到2026年5月,这一比例已经攀升至70.2%。
更重量级任务的渗透率同样在快速扩大。提交过至少一个"需要8小时以上"任务的用户占比,从2.1%增长到了25.6%。
使用方式本身也在变
报告重点追踪了三个维度的变化:并发、运行时长和Skill调用。
并发:越来越多的用户开始在一周内同时推进多个Codex任务,并行管理多个Agent成为常态。
运行时长:平均每天71小时的Codex累计运行时间,是最直观的一个数字——它意味着Codex正在被持续、密集地嵌入真实工作流,而不只是偶发性地被调用。
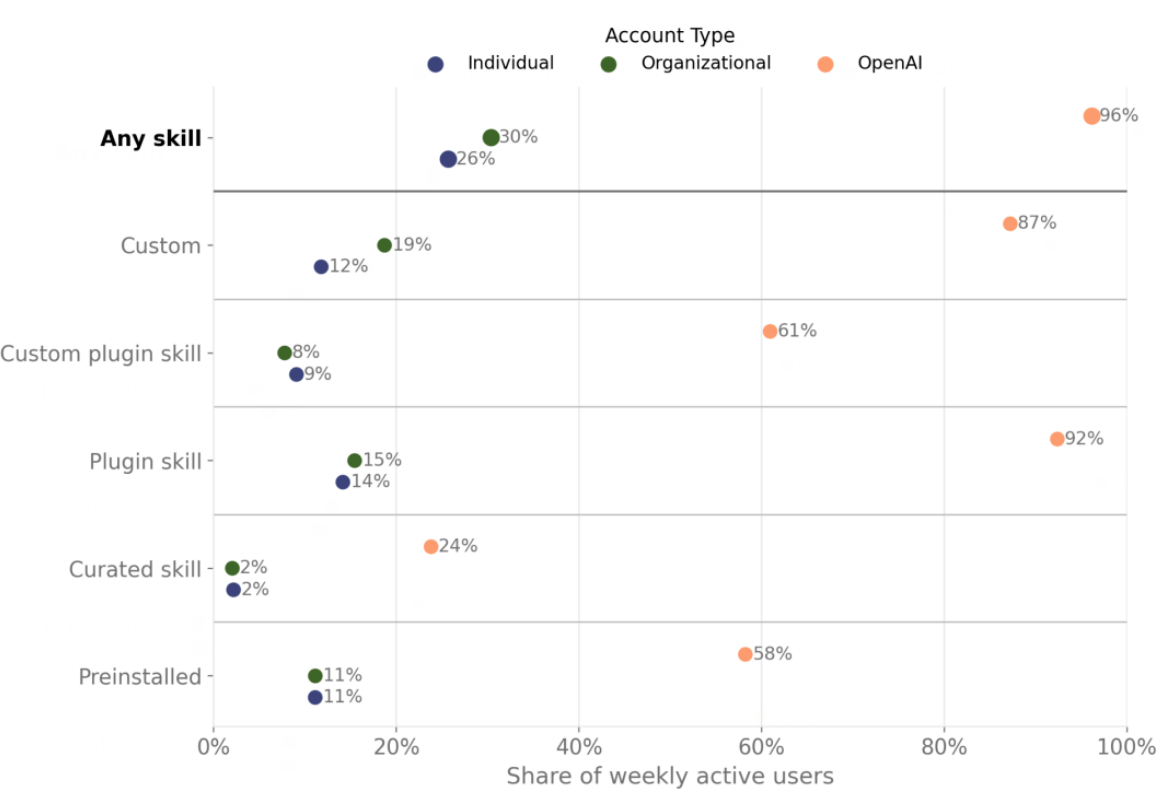
Skill调用:这或许是变化最深层的信号。用户开始把反复出现的工作沉淀为可复用的自动化流程。报告数据显示,活跃Codex用户中调用过Skill的比例,从2026年3月1日的5.4%,增长至6月11日的26.6%。分群来看,个人用户为25.7%,外部企业用户为30.4%,而OpenAI内部用户的这一比例已经达到96.2%。
这些数据不能直接等同于生产率的量化提升,但足以说明一件事:当Codex真正进入工作流之后,人类使用AI的方式已经发生了结构性转变。
当Agent开始真正改变工作组织方式
现在,GPT-5.6的发布命运似乎正在重演Fable 5的轨迹——甚至还未正式亮相,就已经被美国政府要求分批审核后再行发布。
这背后的逻辑,或许可以从Codex的渗透方式中找到线索。
当Agent真实地参与到工作组织之中,一个人可以同时开启几条并行任务线:一个Agent负责查阅资料,一个Agent负责修改脚本,一个Agent负责生成数据表格,另一个Agent负责撰写说明文档。人站在这些Agent的中间,扮演的角色更像项目经理,或者说编辑——决定哪些输出结果可以进入下一个环节。
Codex向越来越多场景渗透的这种能力,或许正好解释了为什么GPT-5.6的发布节奏会变得如此敏感。
当模型只是在对话框里回答问题,风险的边界主要由"它说了什么"来划定;但当模型开始具备调用工具、读写文件、自主执行任务的能力,风险就会真实地进入工作流本身。能力越是接近执行层,发布就越像是基础设施的上线——无法再被简单理解为一次普通的产品版本迭代。
AI的能力,正在开始像资源一样被调度和分配——既是人力资源意义上的,也是物质资源意义上的。而这一切,可能才刚刚开始。
 AI 速览