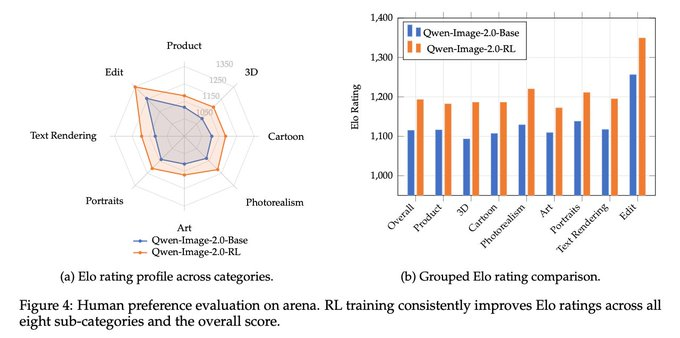
阿里 Qwen 团队发布 Qwen-Image-2.0-RL 技术报告,对 Qwen-Image-2.0 扩散模型应用 RLHF 后训练流程,提出基于 VLM + Chain-of-Thought 的复合奖励模型,覆盖对齐度、美学质量、肖像保真度三个维度。
Qwen-Image采用 GRPO 强化学习框架训练扩散模型,配合混合 CFG 策略和按类别权重校准。引入 On-Policy Distillation(OPD)合并 T2I 和图像编辑两个专业化策略,消除训练与推理阶段的分布偏移。Qwen-Image-Bench 总分 57.84(较基线 +2.61),T2I Elo +78,图像编辑 Elo +93。
问题:扩散模型的后训练为什么难做
大语言模型的后训练已经有一套标准流程——SFT 对齐指令、RLHF 优化偏好、DPO 直接优化。但扩散模型的情况完全不同。扩散模型的生成过程是一步步去噪,每一步的决策空间是连续的像素值而不是离散的 token。传统的强化学习框架依赖离散动作空间和明确的奖励信号,无法直接套用到扩散模型上。
这意味着即使基座扩散模型能力很强,也很难像 LLM 那样通过后训练进一步"调教"它的输出偏好。你可以换更好的基座模型,但没法让现有模型在理解指令和审美偏好上持续进步。Qwen-Image-2.0-RL 要解决的就是这个问题——把 RL 后训练的范式从语言模型移植到图像生成模型。
解决方案:三层架构的 RL 后训练流程
Qwen-Image-2.0-RL 的训后流程可以拆解为三个层次,每一层解决一个具体问题。
第一层:奖励信号从哪来
图像生成的奖励信号比文本生成更难定义。一张图"好不好"涉及美学、对齐度、肖像保真度等多个维度,单一标量分数无法反映这种多维度判断。Qwen-Image-2.0-RL 的做法是:用视觉语言模型(VLM)作为裁判,且要求裁判输出 Chain-of-Thought 推理过程。裁判不是简单打分,而是说清楚"为什么这张图比那张好"——比如"构图合理但角色面部与描述不符"或"色彩和谐但缺少指定元素"。这种可解释的评分信号更难被 exploitation,也更有利于 RL 训练的稳定收敛。
第二层:怎么在扩散模型上做 RL
传统 RL 框架假设动作空间是离散的(选 A 还是选 B),但扩散模型的生成过程是一系列连续的去噪步骤。Qwen-Image-2.0-RL 采用 GRPO(Group Relative Policy Optimization),在采样阶段为同一个提示词生成一组候选图像,然后用组内相对排名作为优势信号,而不是依赖一个独立的 value network。
训练中还有一个关键设计:混合 CFG 策略。标准扩散模型训练会产生一个副作用——模型在 RL 优化过程中逐渐丢失预训练阶段的先验知识。混合 CFG 通过交替使用有引导和无引导的采样路径,在偏好优化和知识保留之间取得平衡。
第三层:两套策略怎么合二为一
T2I 和图像编辑是两种不同的任务,各自用不同的奖励模型训练后会产生两个专业化的策略网络。简单合并会造成冲突——适用于生成的高质量策略在编辑任务上表现不佳,反之亦然。
Qwen-Image-2.0-RL 用 On-Policy Distillation(OPD)来解决:在最终训练阶段,T2I 教师和编辑教师同时对学生模型进行轨迹级别的速度匹配蒸馏。学生模型在生成过程中每一步的去噪方向都向两个教师的最佳方向对齐,最终得到一个同时擅长生成和编辑的单一模型。OPD 的一个附带好处是消除了扩散模型训练和推理之间的分布偏移——训练时用 RL 展开的轨迹和推理时实际采样的轨迹不再是两种分布。
效果数据
Qwen-Image-2.0-RL 在三个评测维度上均显示提升:
- Qwen-Image-Bench 综合得分 57.84(较基线 Qwen-Image-2.0 提升 +2.61)
- 文本到图像 Elo 评分 1193(+78),反映人类偏好评估中视觉质量和提示对齐度的提升
- 图像编辑 Elo 评分 1349(+93),提升幅度是三者中最大的,说明 RL 训练对编辑类指令跟随的改善尤为显著
社区对这项工作的评价普遍积极,有研究者将其称为"图像模型的 RLHF 时刻"——类比于 LLM 领域中 RLHF 带来的能力跃迁。
对开发者的实际意义
Qwen-Image-2.0-RL 展示了在扩散模型上应用 RL 后训练的可行路径。对于需要用图像生成模型的开发者和产品团队,这意味着:
- Qwen-Image-2.0-RL 的权重预计会在 Qwen 的官方渠道开放,可以直接替换原有的 Qwen-Image-2.0 基座模型,获得更好的指令跟随能力
- 论文中的 VLM 奖励模型框架可以被复用——如果你有自己的图像生成模型,可以参照这套流程构建自己的奖励信号和训练管道
- OPD 方法为多任务蒸馏提供了参考——不需要维护多个专业模型,一个模型可以同时覆盖生成和编辑
当然,GRPO 训练和 OPD 蒸馏需要一定的计算资源,不适合零 GPU 环境。对于多数应用场景,直接使用 Qwen 提供的训练后权重是最快捷的方式。
 AI 速览