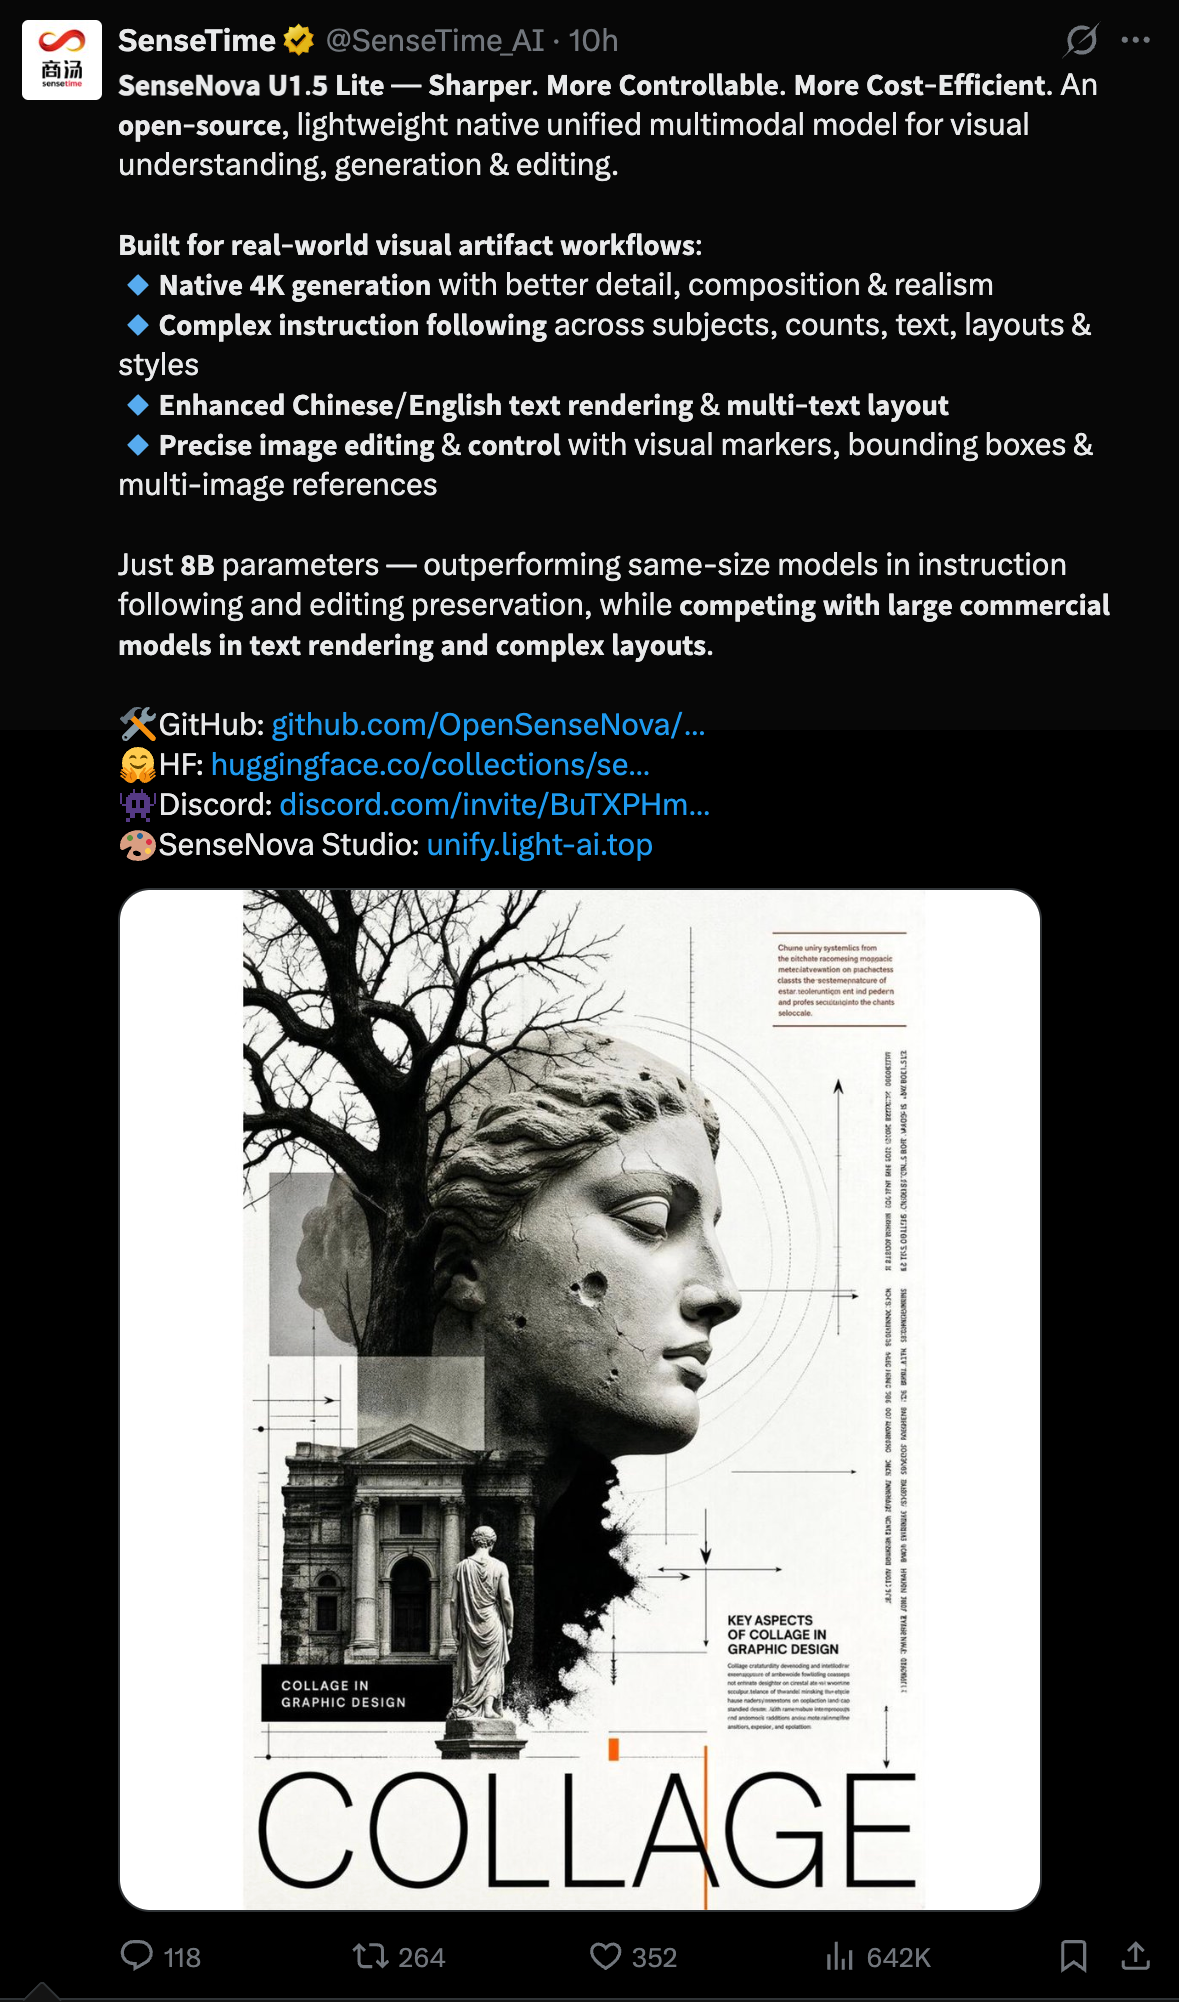
8月21日消息,商汤科技在 GitHub 开源组织 OpenSenseNova 发布 SenseNova U1.5 正式版,权重名 SenseNova-U1.5-8B-MoT,采用 Apache 2.0 许可。这是本月初官宣的 U1.5-Lite-Preview 的正式版本:Preview 于 7月31日上线、8月3日对国内官宣,正式版在 20 天后落地。与权重同时发布的还有一个 8 步推理的 LoRA 加速权重,商汤同时预告将开源技术报告和从 SFT、RL 到 MOPD 的完整训练管线,目前这两部分尚未放出。量子位在 Preview 报道中曾提到"U1.5 的正式版很快就会开源",这次发布兑现了这一预告。
正式版改了什么,预告开源的不只是权重
按官方说明,正式版集中改进六个用户可感的方向:生成质量(构图、色彩和谐度、材质与光照的真实感)、中英文文字渲染与信息图生成、原生 4K 生成的效率与稳定性、编辑过程中对主体和未编辑区域的保持、复杂指令遵循(物体数量、空间关系、版式、风格等多约束同时执行),以及通过 bounding boxes、视觉标记和单图或多图参考实现的区域级视觉控制。
同步发布的 SenseNova-U1.5-8B-MoT-LoRA-8step 是一个 0.4B 的加速权重,用于把推理压缩到 8 步。商汤在今年 4 月底就为 U1 发布过类似的 8 步模型,当时官方的说法是多数场景下生成质量与基础模型接近。真正值得开发者关注的预告是另一条:技术报告和覆盖 SFT、RL 到 MOPD 的完整训练管线正在准备开源。这部分目前仍是计划状态,如果落地,意味着这条统一多模态路线从"开源权重"走向"开源可复现的训练流程",复现门槛会明显降低。
「8B」的口径与本地部署条件
官方名字里的"8B-MoT"需要拆开看。按 GitHub 文档的注释,它指理解侧约 8B 参数加生成侧约 8B 参数,Hugging Face 页面上模型总量标注约 18B。底层是商汤自研的 NEO-Unify 架构,特点是不使用独立的视觉编码器(VE)和变分自编码器(VAE),在单一模型内端到端完成视觉理解与生成。
部署门槛是这条产品线的主要卖点。官方提供 GGUF 量化和显存分级模式,推荐 Q4 量化加 balanced 模式的组合,约 10 到 12 GB 显存的消费级显卡即可运行。不想本地部署的用户可以通过 SenseNova Studio 在线体验。
官方承认的短板有五项
商汤在发布文档中明确列出了正式版仍然存在的问题:部分提示词会产生过度强调的高频细节或过饱和色彩;密集、长篇幅或中英混排的小字可能出错;强约束版式下的精确数量和对齐仍不完美;小尺寸人脸、手部等人体细节不稳定;大范围、多轮次或多参考图的编辑可能出现漂移。官方给出的缓解方式是调低 cfg_scale 参数。
需要说明的是,"超越同规模模型、比肩商用闭源模型"这类对比结论来自官方自测的 benchmark,目前没有第三方复测结果。开源统一多模态赛道上,字节跳动的 BAGEL、智源研究院的 OmniGen2 和阿里的 Qwen-Image 系列此前均已开源,但各家评测口径不同,无法据此直接横评。
从时间线看,商汤今年在这条路线上的节奏很密:4月发布 U1,首次完整展示 NEO-Unify 原生统一架构;7月在 WAIC 发布旗舰线 U1 Pro 预览版,支持原生 8K 和长程编辑,目前仍在邀测;开源轻量线则从 7月31日的 Preview 走到今天的正式版,只用了 20 天。对需要本地部署图像生成与编辑能力的开发者,这次更新的实际意义来自三样同时到位的东西:Apache 2.0 的宽松许可、消费级显卡可跑的显存门槛,以及一个承诺开源完整训练流程的官方时间表。最后一项目前还只是预告,能否兑现、何时兑现,是判断这条路线开源诚意的直接证据。
 AI 速览