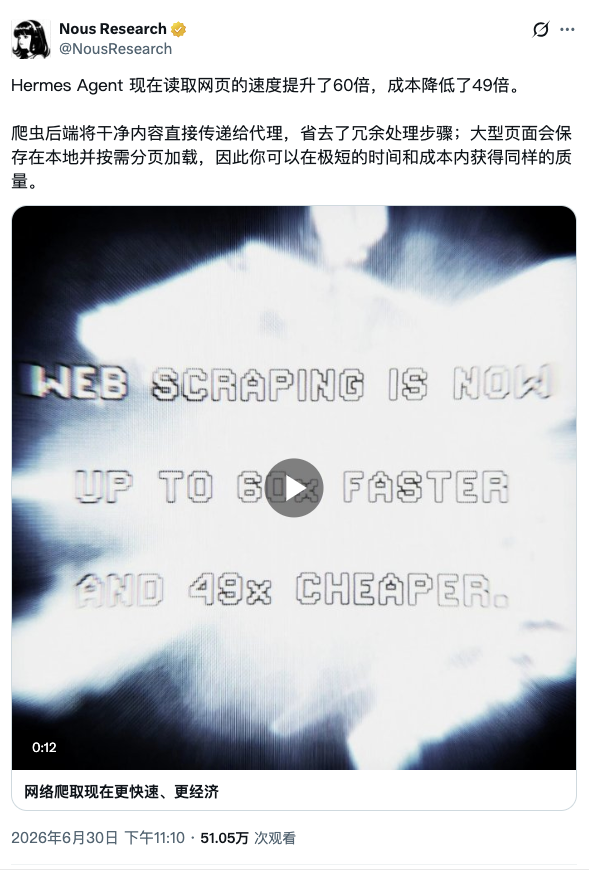
7月1日消息,NousResearch 宣布对其开源 AI 智能体平台 Hermes Agent 的网页读取能力进行重大升级,网页处理速度提升最高 60 倍,成本降低 49 倍。核心改动是引入爬取后端直接生成干净的 Markdown 内容传递给智能体,跳过此前冗余的中间处理步骤,同时对大型页面采用本地保存和按需分页策略。这是一次针对 AI 智能体在网页信息获取环节的工程优化,直接影响智能体执行研究、数据采集和网页交互任务时的运行成本和响应速度。 爬取后端跳过冗余步骤,直传 Markdown
此前 Hermes Agent 读取网页时,内容需要经过多步转换才能进入智能体的上下文窗口。升级后,爬取后端(默认为 Firecrawl)在抓取页面时直接完成渲染和 Markdown 转换,将干净的结构化内容传递给智能体,省去了重复的格式处理环节。开发者只需在配置文件中设置 Firecrawl API 密钥,web_search 和 web_extract 两个核心工具就会自动通过该后端路由,对 JavaScript 渲染页面同样有效。
Hermes Agent 目前支持八个搜索后端,包括 Firecrawl、Tavily、Exa、Brave、DuckDuckGo、SearXNG、Parallel 和 xAI,其中 Firecrawl 和 Tavily 同时支持搜索、提取和整站爬取三种能力。对于偏好本地化部署的开发者,SearXNG 负责搜索、自托管 Firecrawl 负责提取的组合可以实现完全脱离外部 API 的运行。
大型页面按尺寸分级处理,控制上下文开销
网页读取的另一个成本来源是大型页面对上下文窗口的消耗。升级后,Hermes Agent 对返回内容按字符量分级处理:5000 字符以下的页面直接传递给智能体,不经过任何压缩;5000 至 50 万字符的页面通过辅助模型进行单次摘要,输出约 5000 字符;50 万至 200 万字符的页面先分割为 10 万字符的块,并行摘要后再合成最终输出;超过 200 万字符的页面则直接拒绝并提示使用更精确的源地址。辅助摘要模型默认使用主聊天模型,但开发者可以将其切换为低成本快速模型(如 Gemini 3 Flash),避免在使用 Opus 或 MiniMax M2.7 等高价模型时因页面摘要产生不必要的推理开销。 此外,NousResearch 近期还通过 PR 合并了基于 Crawl4AI 的本地深度爬取工具,支持递归链接跟踪和多页 Markdown 提取,无需外部 API 即可完成整站爬取。
智能体的网页读取成本是一个被低估的运行瓶颈
对于使用 AI 智能体执行研究、代码调试或数据采集任务的开发者而言,网页读取是最频繁触发的工具调用之一,也是上下文窗口消耗的主要来源。一个论坛帖子、一篇带评论的新闻文章或一份技术文档,在不经压缩的情况下可能占据数万甚至数十万 Token。60 倍的速度提升和 49 倍的成本降低如果在实际场景中可复现,意味着智能体执行多网页研究任务的经济性将发生实质性变化。但这些数字的具体测试条件——页面类型、模型配置、是否包含摘要开销——NousResearch 尚未公布详细的基准测试数据,实际效果需要开发者在自己的工作负载上验证。
Hermes Agent 的差异化在于开放架构和本地化能力
Hermes Agent 在 AI 智能体工具市场中的定位是开源、可本地部署、后端可插拔。与 Claude Code 或 Cursor 等商业工具不同,Hermes 的搜索、提取和浏览器后端均可替换或自托管,支持从完全云端到完全本地的部署光谱。此次网页读取优化是否能在竞争日趋激烈的智能体工具市场中构成持续的差异化优势,取决于开源社区的采纳速度以及 NousResearch 在后续版本中对更多实际使用场景的优化深度。60 倍和 49 倍的数字需要更透明的测试方法论来支撑,目前的信息主要来自官方社交媒体公告,尚未有独立的第三方验证。  AI 速览