LibTV这轮更新之后,AI视频创作终于有点像真拍戏的样子了。深度体验下来,人像调节、Storyboard脚本工作流、3D导演台这三个新能力,让LibTV从「输入提示词生成视频」的工具,变成了一套真正面向AI影视创作的工作台。 一、先把角色搞定,别再有那张「一眼AI脸」
做视频最要紧的是先把角色定下来,所以你最先该注意的是人像调节和虚拟角色库。
1、人像调节
人像调节这功能专治那种「看着还行,但一眼假」的人物图——脸磨得太光、皮肤没纹理、人物边缘跟背景融合得很生硬,或者脸上的光跟场景光源根本不在一个世界里。以前遇到这种情况,你大概率会继续抽卡,或者重写一大段prompt死磕。用完LibTV的人像调节之后你会发现,它不是把人物换成另一张脸,而是在原有身份基础上处理皮肤质感、面部细节以及人物和背景的融合——过度磨皮的地方会收回来,脸部反光更贴近环境,边缘过渡也更自然了。
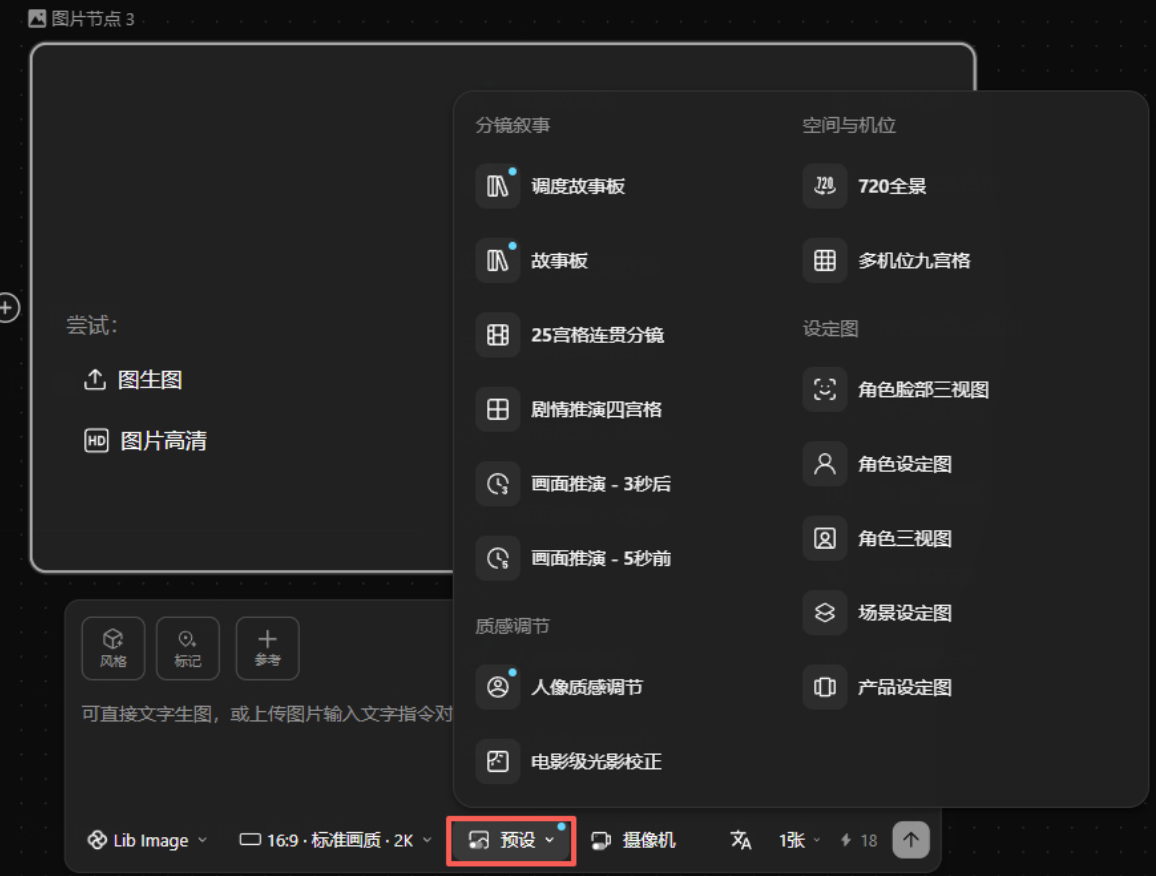
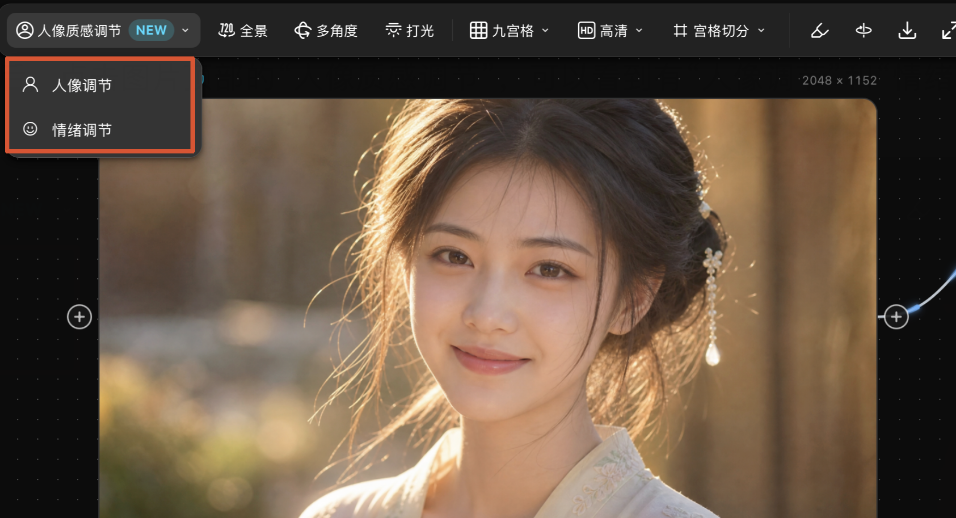
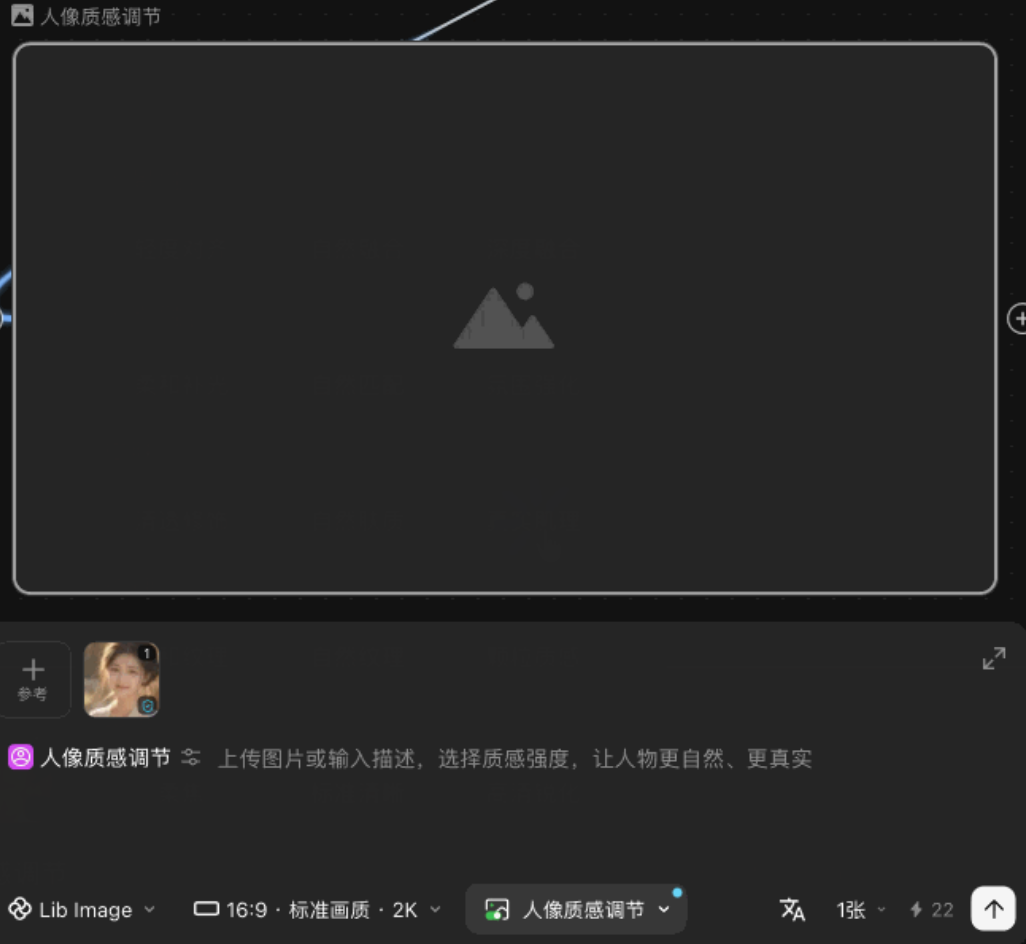
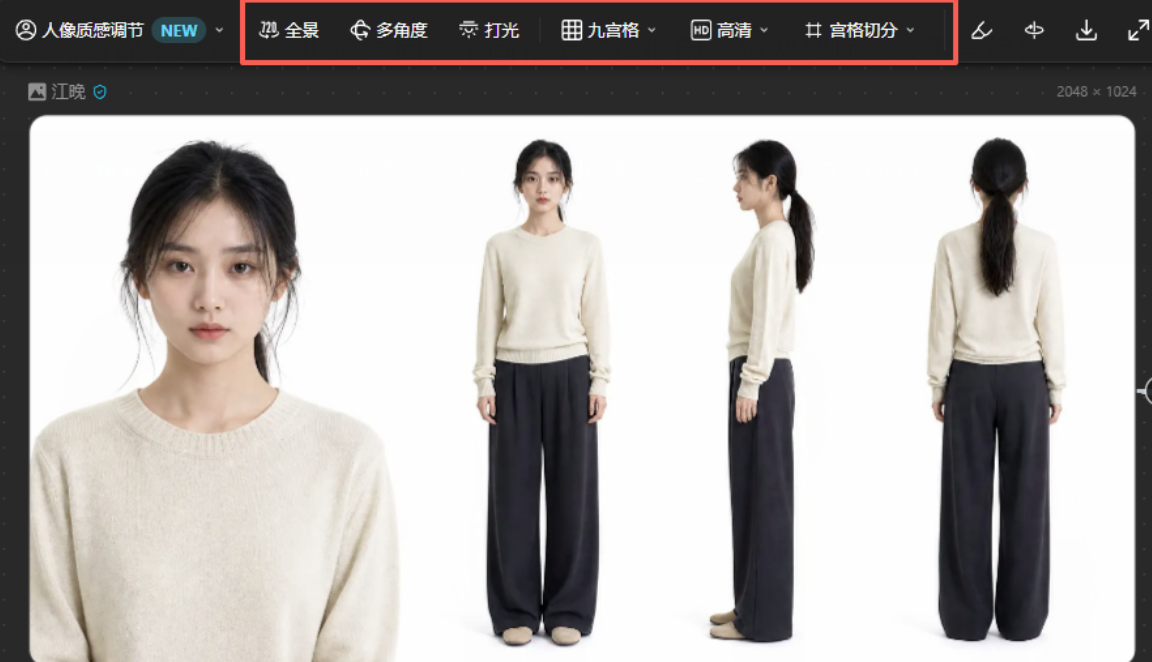
操作上,把图放进画布,点顶部的「人像质感调节」,里面有「人像调节」和「情绪调节」两块。
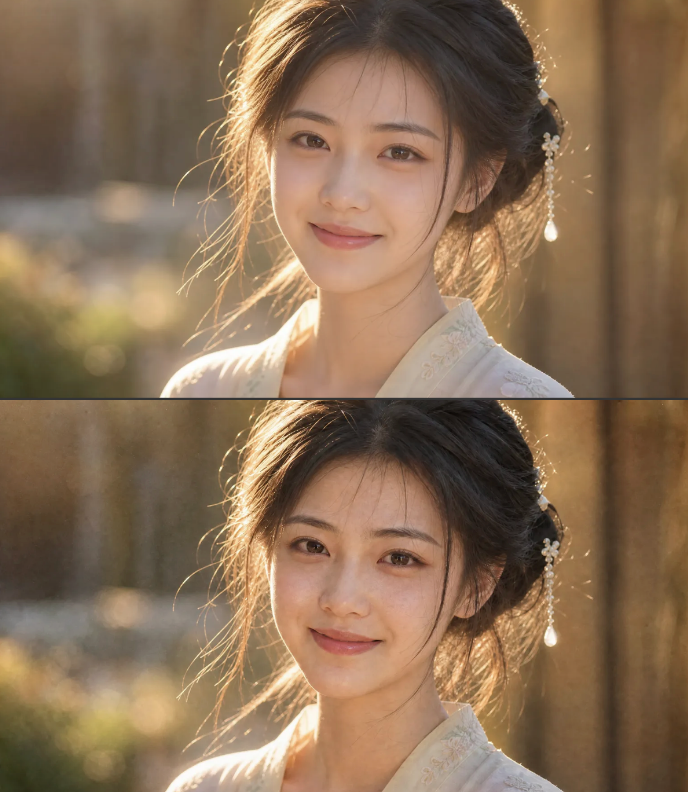
人像调节能调人景光影融合、皮肤、纹理和锐度,生成出来的效果比原图真实不少,很适合修那些「差一点就能用」的图——五官没大毛病,但皮肤太平、脸太亮、边缘不贴的那种。
生成效果:
这里得说清楚一点,它不是把图变成完全不同的风格,更像是把原图往真实拍摄感上推一把。
2、情绪调节
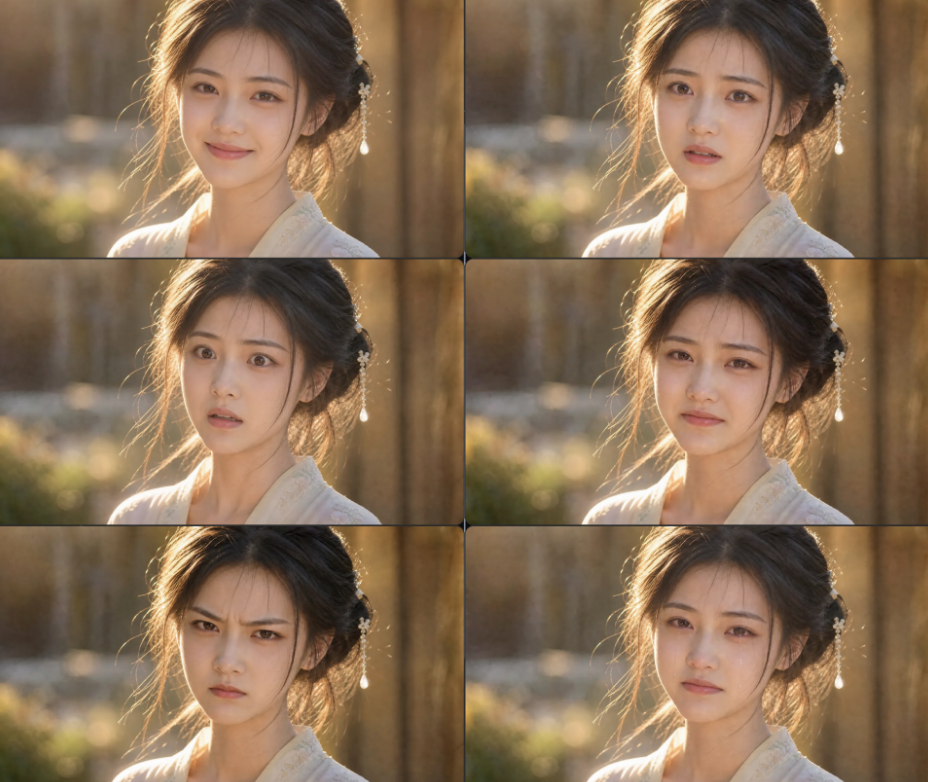
情绪调节的用法也很直白,上传人物图,选中要调的那个人,再选目标情绪就行。这功能补短剧的表演细节挺好用,比如同一角色要从平静过渡到惊讶再到生气,建议先用同一张角色图调情绪,再接到后面的分镜里。
生成效果:
3、虚拟角色库
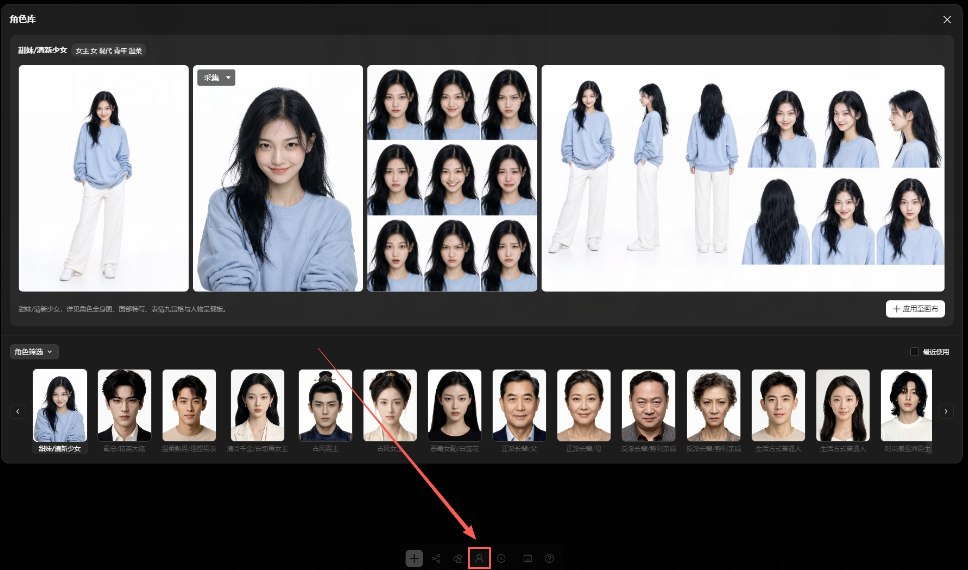
虚拟角色库有两个入口,画布底部一个,视频生成节点里也能直接调。
这次给的角色库质感挺真实,覆盖了短剧主角、配角,小孩、年轻人、老年人,也有广告时尚场景常用的模特形象。
比较喜欢的一点是角色能直接进入后续工作流——在生成节点里调用角色库,就不用在prompt里一遍遍描述「同一个人」了。
这对短剧、漫剧、系列广告这类连续内容特别关键,观众记住一个角色靠的从来不是「这张脸好看」,而是这个人在不同镜头里始终是同一个人。
二、Storyboard:从写剧本变成拆分镜
角色搞定之后,面对的就是最枯燥的批量生产环节。做一集漫剧动辄几十上百个分镜,以前只能一个节点一个节点复制粘贴,画布很快就乱成一锅粥。
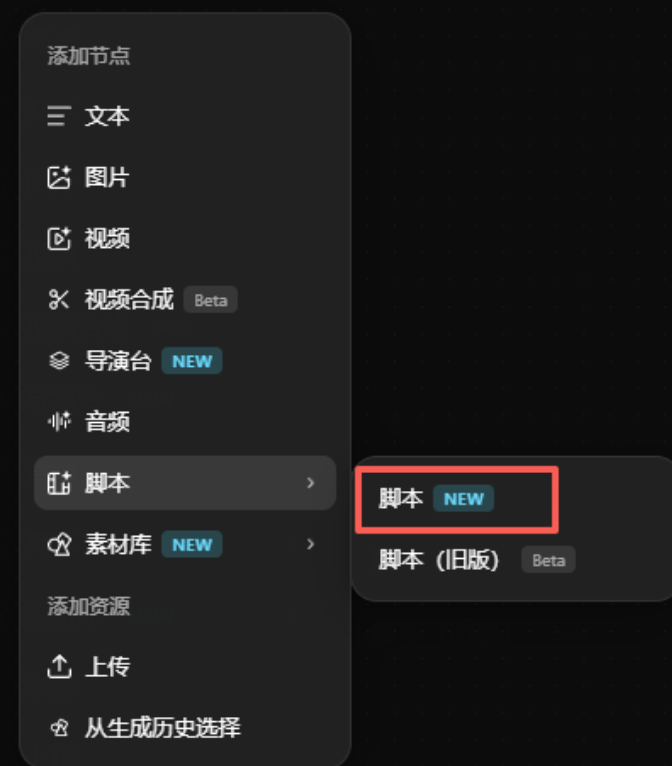
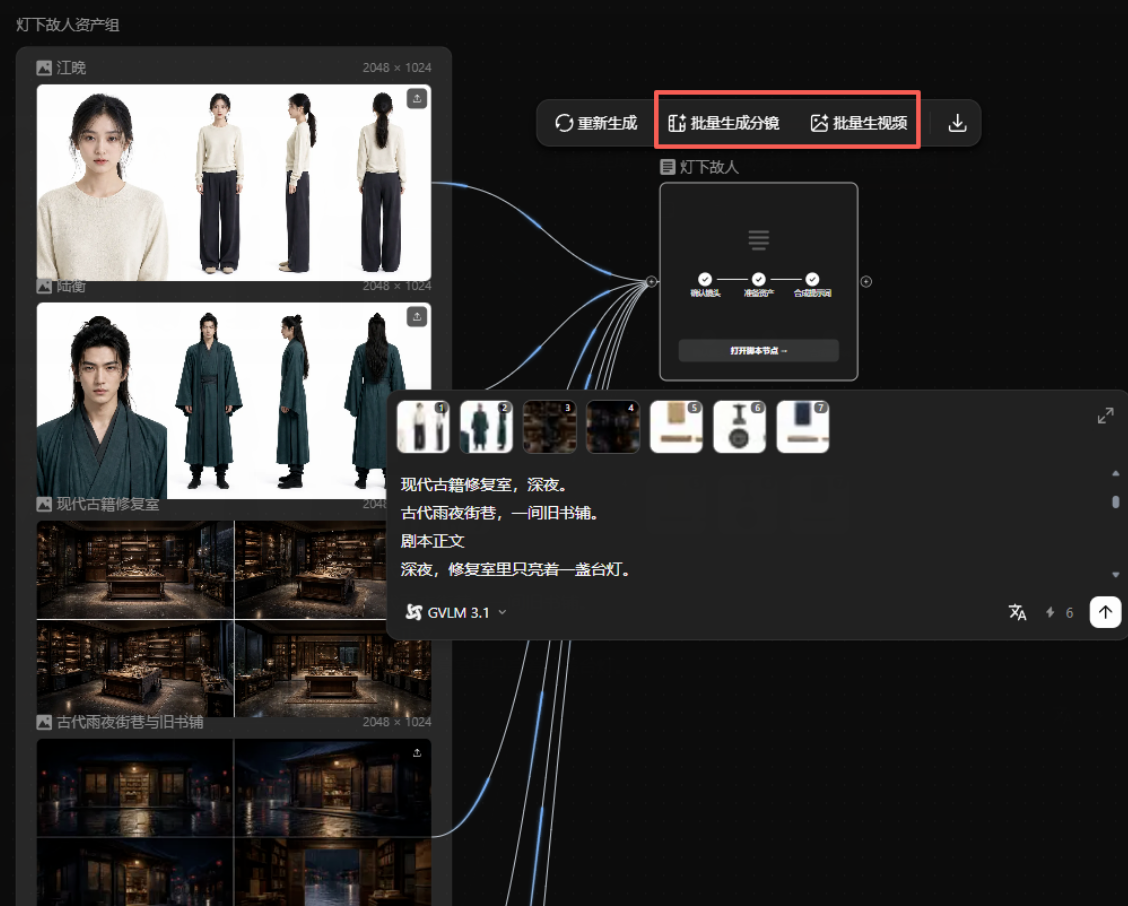
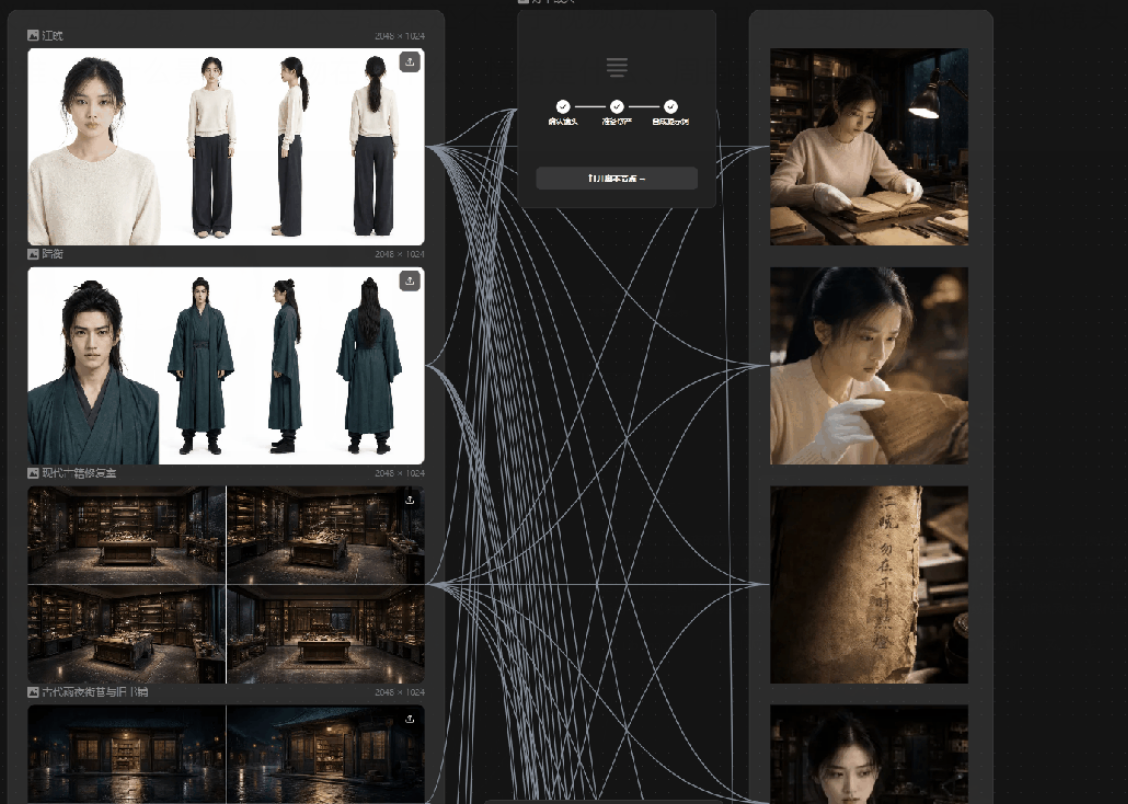
这次更新的「脚本」工作流,把剧本文本接入脚本节点,系统会自动拆成结构化的Shot(镜头),还会自动提取角色、场景和道具资产。
这里建议你别生成完就立刻批量出图,先人工过一遍——脚本节点拆得再细,还是有需要你判断的地方,比如某个镜头转场是不是太快、角色动作说没说清楚、场景跟前后镜头连不连得上。
下一步是资产管理。
脚本节点会从剧本里自动识别角色、场景和道具,整理成一张张可管理的卡片。点开角色卡片能看到系统默认生成的角色提示词,如果你已经有更合适的角色图,直接上传替换就行。
资产和提示词确认无误之后就能生成分镜或视频了。建议你先出分镜,毕竟剧本写完不等于成片,中间还要拆成具体镜头——这一镜谁出场、用什么景别、人物在做什么、情绪是什么、周围环境又是什么。对哪个镜头不满意,还能继续改提示词或参数重新生成。
三、3D导演台:先摆好画面,再让AI照着拍
这里有个绕不开的问题:有些镜头单靠语言根本描述不清楚。比如「两个人在车旁对峙,男主在前景偏左,女主站在车后,镜头从低角度拍,旁边还有围观人群」这种空间关系和人物走位,你prompt写出一朵花来,AI大概率还是会给你生成两个人肩并肩傻站着。
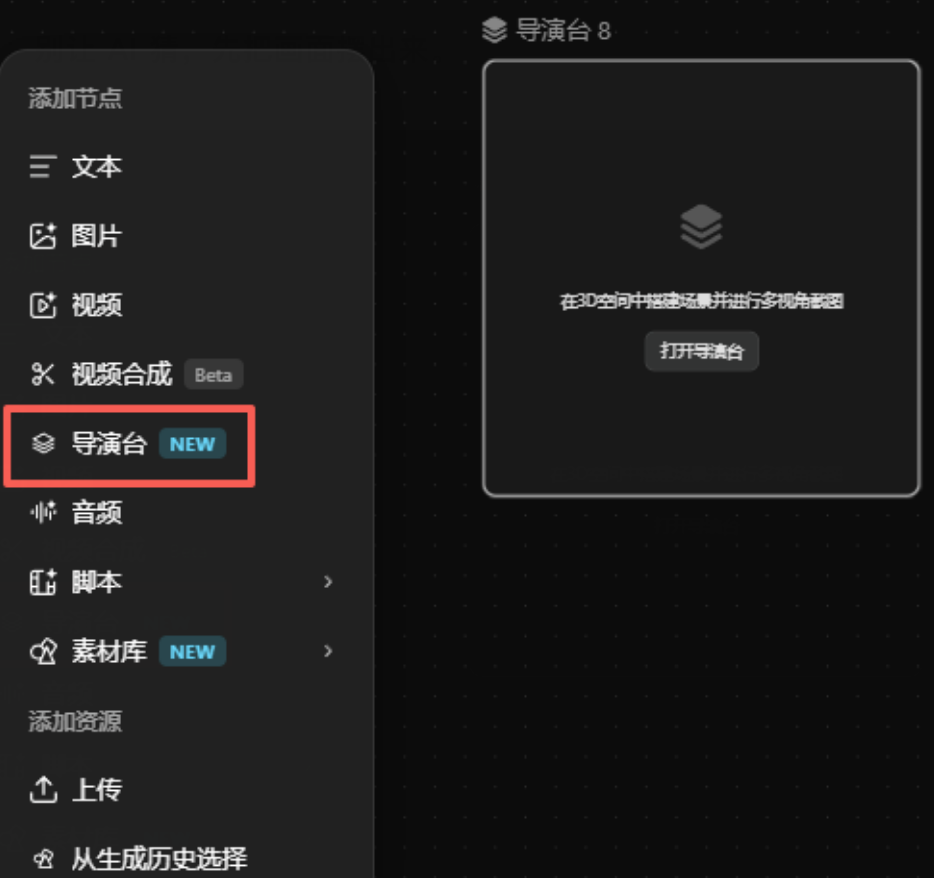
这就是3D导演台要解决的问题,思路很简单——别让AI猜,先把画面摆出来。
你可以在3D空间里放人体素模、基础几何模型、群众阵列,也能上传本地模型。添加角色之后,调整位置、旋转、缩放,再摆好摄像机位置,画面右上方就能看到机位视角。视角觉得没问题了,点下方的「截图」,就会把当前画面截下来发到画布里当参考图。它没有复杂的建模门槛,更像是给AI视频创作者用的「构图草稿台」。最后生成效果当然还是要看模型和prompt本身,复杂动作也不可能光靠摆个姿势就百分百还原,但作为「让AI看懂你要什么镜头」的中间步骤,确实比纯文字描述稳得多。
顺手也试了下画布里的其他功能,视频合成支持多轨道和变速、720°全景、打光效果、视频字幕擦除等等。这些功能单看都不算复杂,但放在同一个画布里连着用,越用越顺手,效果会很不错。
这轮试下来最大的感受是,LibTV不是只在死磕「单张图更好看」,它更在意AI视频能不能连续做下去——角色要稳定,剧本要能拆,镜头要能控,最后才能从一张张好看的图变成一条真正能看的片子。
如果你只是偶尔生成几张图,这套东西可能有点重;但如果你在做AI短剧、AI漫剧、广告短片或分镜提案,或者经常被角色跑脸、镜头跑偏、prompt来回改这些事折磨,LibTV这套工作台值得你花时间试一下。
 AI 速览