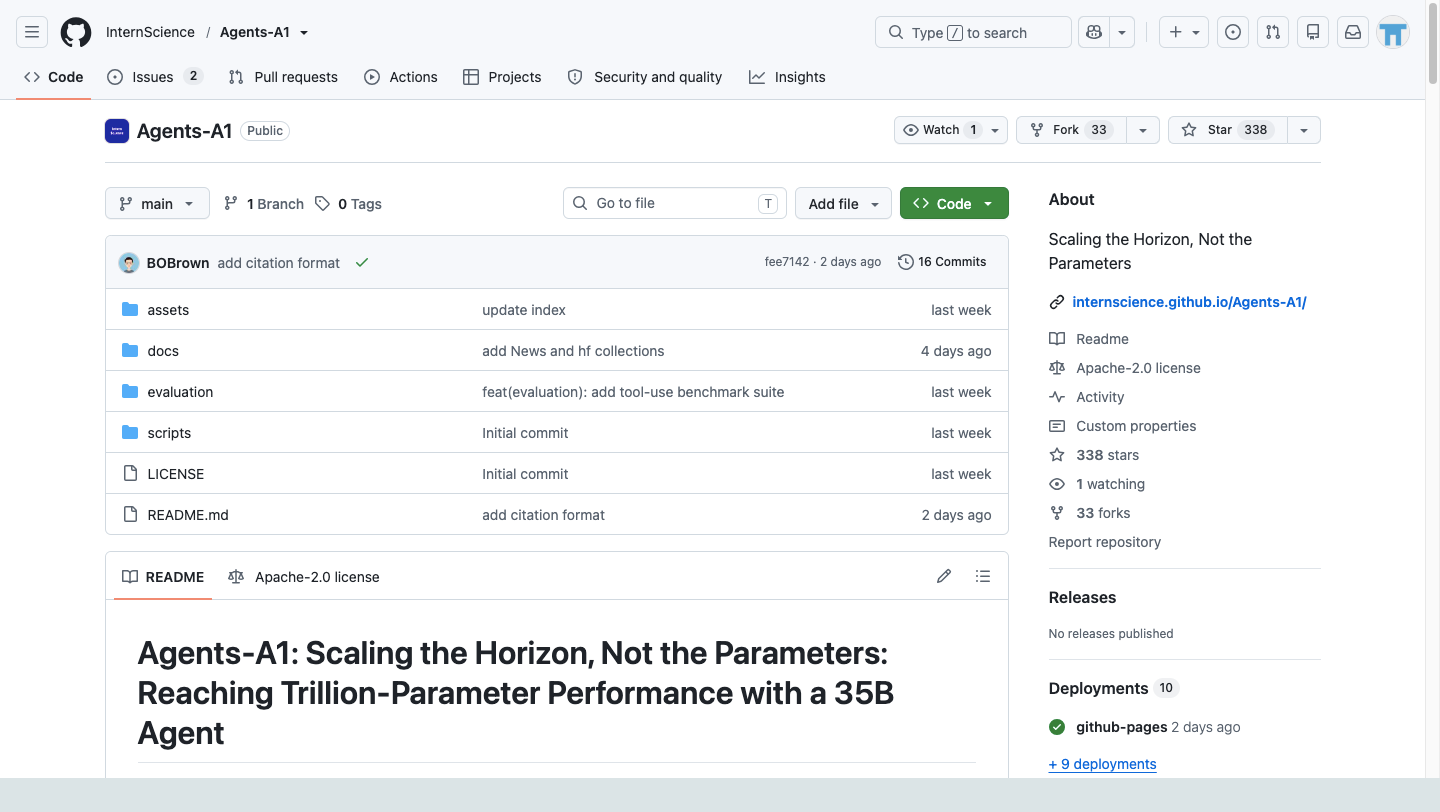
- 上海AI实验室(InternScience团队)开源Agent-A1,一个基于Qwen3.5-35B-A3B初始化的350亿参数MoE智能体模型,核心命题是"扩展行动时序而非堆参数"
- 训练使用三阶段pipeline:全领域SFT(约10万条平均45K token的长轨迹)→ 多领域教师模型(搜索用GRPO强化学习、科研用两阶段SFT、指令遵循用两阶段RL、工具调用用SFT+RL)→ 领域路由on-policy蒸馏+显著词汇对齐,将六个异构领域能力统一到一个学生模型
- 构建了知识-行动图(KAG)基础设施,将外部知识、工具调用、环境观察、验证器信号串联成结构化轨迹,确保Agent能从失败中学习和自我纠错
- 关键基准成绩:SEAL-0 56.4、IFBench 80.6、HiPhO 46.4、FrontierScience-Olympiad 79.0、MolBench-Bind 56.8,均超越Kimi-K2.6和DeepSeek-V4-pro;BrowseComp 75.5、HLE 47.6、SciCode 44.3保持竞争力
- 局限明确:在MLE-Bench-Lite等全流程工程任务上(35.7% medal rate vs GPT-5.5的72.7%)和通用基准上仍弱于万亿参数模型,蒸馏后模型在某些任务上未超过专业教师
Agent-A1是什么:从堆参数到堆行动时序
Agent-A1是上海人工智能实验室InternScience团队开源的一个350亿参数MoE智能体模型,论文标题直指核心命题:"Scaling the Horizon, Not the Parameters"——扩展智能体的行动时序长度,而不是扩大参数规模。模型以Qwen3.5-35B-A3B为初始化,在这个35B级别的基座上通过三阶段训练实现与万亿参数模型比肩的长周期Agent能力。
它的核心逻辑清晰:传统路线通过增加模型参数来内化更多的推理模式、工具使用行为和领域知识,效果虽好但复制门槛极高。Agent-A1走的是另一条路——把知识获取、工具执行、观察解读和验证反馈变成可训练的监督信号,让中间决策过程显式化、可追溯。
Agent-A1在Hugging Face以InternScience/Agents-A1发布,同时开源在GitHub(github.com/InternScience/Agents-A1),使用Apache 2.0协议,支持256K上下文窗口。项目页面internscience.github.io/Agents-A1提供了完整的模型卡和基准结果。
核心技术之一:知识-行动图基础设施
Agent-A1构建了一套将异构数据转化为可训练轨迹的基础设施,论文将其定义为知识-行动图。传统训练中Agent的轨迹数据通常被当作序列文本处理,知识-行动图的做法是把外部知识语料、Agent动作、工具执行结果、环境观察和验证器信号全部记录为一阶链接对象。一个四元组被用来表示每一步:当前状态(来自语料库和过去观察)、执行的动作(工具调用、检索查询、代码编辑)、产生的观察结果(工具返回值、执行状态)和验证器反馈(正确性检查、约束满足度)。
这种设计的价值在于过程级的监督而非仅最终的答案监督。一条平均45K token的轨迹包含成功的推理路径,也包含失败的尝试、工具调用错误和自我修正步骤。验证器通过一个提议者-求解器-验证者的自博弈循环来检查每条轨迹的质量,只有同时满足可验证、有效、过程信息丰富、证据覆盖充分和无捷径解五个条件的候选才会被接受。失败的轨迹会被写回图中用于后续的自博弈扩展。
论文将长周期智能体能力拆解为五种原子能力:信息获取、工具调用、可执行迭代、证据验证和约束跟踪。每个领域的知识-行动图为这些原子能力提供专门的监督信号。
核心技术之二:三阶段训练pipeline
第一阶段是全领域监督微调,在约10万条平均45K token的长周期轨迹上对Qwen3.5-35B-A3B进行SFT。数据覆盖深度研究、编程与工程、科学问题求解、指令遵循和通用Agent任务五个类别,通过样本打包策略提升训练效率。SFT阶段的目标是让模型获得广泛的Agent行为模式,但论文也观察到SFT后的模型在通用Agent任务、指令遵循和HLE上出现了性能下降——长思考推理模式与多轮Agent模式之间的冲突无法通过全领域SFT简单解决。
第二阶段训练多个领域特定的教师模型。搜索任务的教师模型经过搜索轨迹SFT后再用GRPO强化学习训练,配备搜索、页面读取和代码三个工具,奖励设计结合了正确性奖励、搜索行为惩罚(效率惩罚和重复惩罚)和格式校准奖励。科研领域的教师模型采用两阶段SFT:第一阶段用高质量无工具的科学推理轨迹强化推理深度,第二阶段用工具增强的科研轨迹训练交互能力,配备搜索、页面访问、代码和学术搜索四个工具。指令遵循的教师模型同样用GRPO强化学习,第一阶段优化细粒度约束满足,第二阶段优化长上下文情境学习,使用基于规则的奖励(格式、长度、关键词等)而非LLM裁判。工具调用的教师模型先做工具专用SFT,再用强化学习优化完整轨迹,奖励设计同时包含结果奖励和过程评分,并且不对称地只在失败轨迹上使用过程奖励——成功轨迹已经满足所有条件,再加过程奖励会重复计数。
第三阶段是多教师领域路由on-policy蒸馏(OPD)与显著词汇对齐。核心问题在于:不同领域的推理模式差异很大——长指令遵循使用单轮长思考模式,长周期搜索使用多轮工具调用的短思考模式,简单的全领域SFT无法处理好这些冲突。OPD的方案是让多个领域教师各自产生rollout,学生模型通过领域路由从对应教师那里接收监督信号。显著词汇对齐将教师和学生之间的对齐集中在教师选出的最相关词汇子集上(top-k),而不是在整个词表上做KL散度。领域归一化目标则确保高频或高损失领域不会主导梯度更新,每个活跃领域在batch中享有可比的影响力。
真实成绩与诚实边界
Agent-A1在长周期Agent基准上交出了一份值得关注的成绩单。SEAL-0达到56.4,超过Kimi-K2.6和DeepSeek-V4-pro的对应成绩。IFBench达到80.6,在严格指令遵循上表现出色。HiPhO 46.4和FrontierScience-Olympiad 79.0展示了在物理和前沿科学奥林匹克竞赛级问题上的优势。MolBench-Bind 56.8在分子结合亲和力比较任务上领先。BrowseComp达到75.5,HLE 47.6,SciCode 44.3。 在这些之外,论文同时还报告了一些重要但较少被引用的数据。搜索教师模型经过RL后在GAIA上从59.8提升到85.4,提升了25.6分——这是单个领域RL带来的最大增量。在事实核查的数据集中,Agent-A1也取得了不错的成绩。
但论文诚实地报告了多条边界。在MLE-Bench-Lite(端到端机器学习工程)上,Agent-A1的medal rate为35.7%——远高于同级的Qwen3.5-35B-A3B,但GPT-5.5达到了72.7%。论文的分析是,MLE优化不是一个静态问题求解任务,它要求模型在多次实验间保持稳定的目标、记住过去的决策并避免重复试验,这对35B模型的记忆和状态保持能力提出了更高要求。在Tau2-Bench(通用Agent任务)上,Agent-A1经过工具增强RL后从32.53提升到82.50,但在VitaBench上从26.00提升到44.16后与万亿参数模型仍有差距。
论文在第六章专门列出了局限和未来工作。Agent-A1的能力主要来自三个来源:Qwen3.5-35B-A3B的基线能力、为长周期场景构建的统一知识-行动基础设施、以及跨领域蒸馏方法。论文指出,在从基线模型扩展行动时序的过程中,几个基础的原子能力对保持Agent的目标一致性和效率至关重要——包括推理前先规划、行动前先反思、在长上下文中总结关键信息、识别重要的历史信息。这些原子能力的强化是论文明确列出的后续方向。此外,蒸馏后的学生模型并不总是在每个任务上都超过对应的领域教师——这是预期的,因为每个教师专注于单一领域,而学生需要在异构任务之间维持统一的行为策略。
在Agent生态中的定位
Agent-A1是中等级别模型,与万亿参数模型不是替代关系。万亿参数模型在通用知识宽度和全流程工程任务上依然领先,但Agent-A1证明了另一条路线的可行性——通过高质量的长轨迹数据、精细的结构化蒸馏和有针对性的强化学习,35B模型在长周期Agent任务上可以做到与万亿参数模型同台竞技。论文支持vLLM部署,Apache 2.0协议,权重已发布在Hugging Face和ModelScope。这个开源动作使更多的研究团队和中小开发者能够在此基础上复现和改进Agent能力的扩展方法。
论文地址:arxiv.org/abs/2606.30616
模型权重:huggingface.co/InternScience/Agents-A1
代码仓库:github.com/InternScience/Agents-A1
 AI 速览