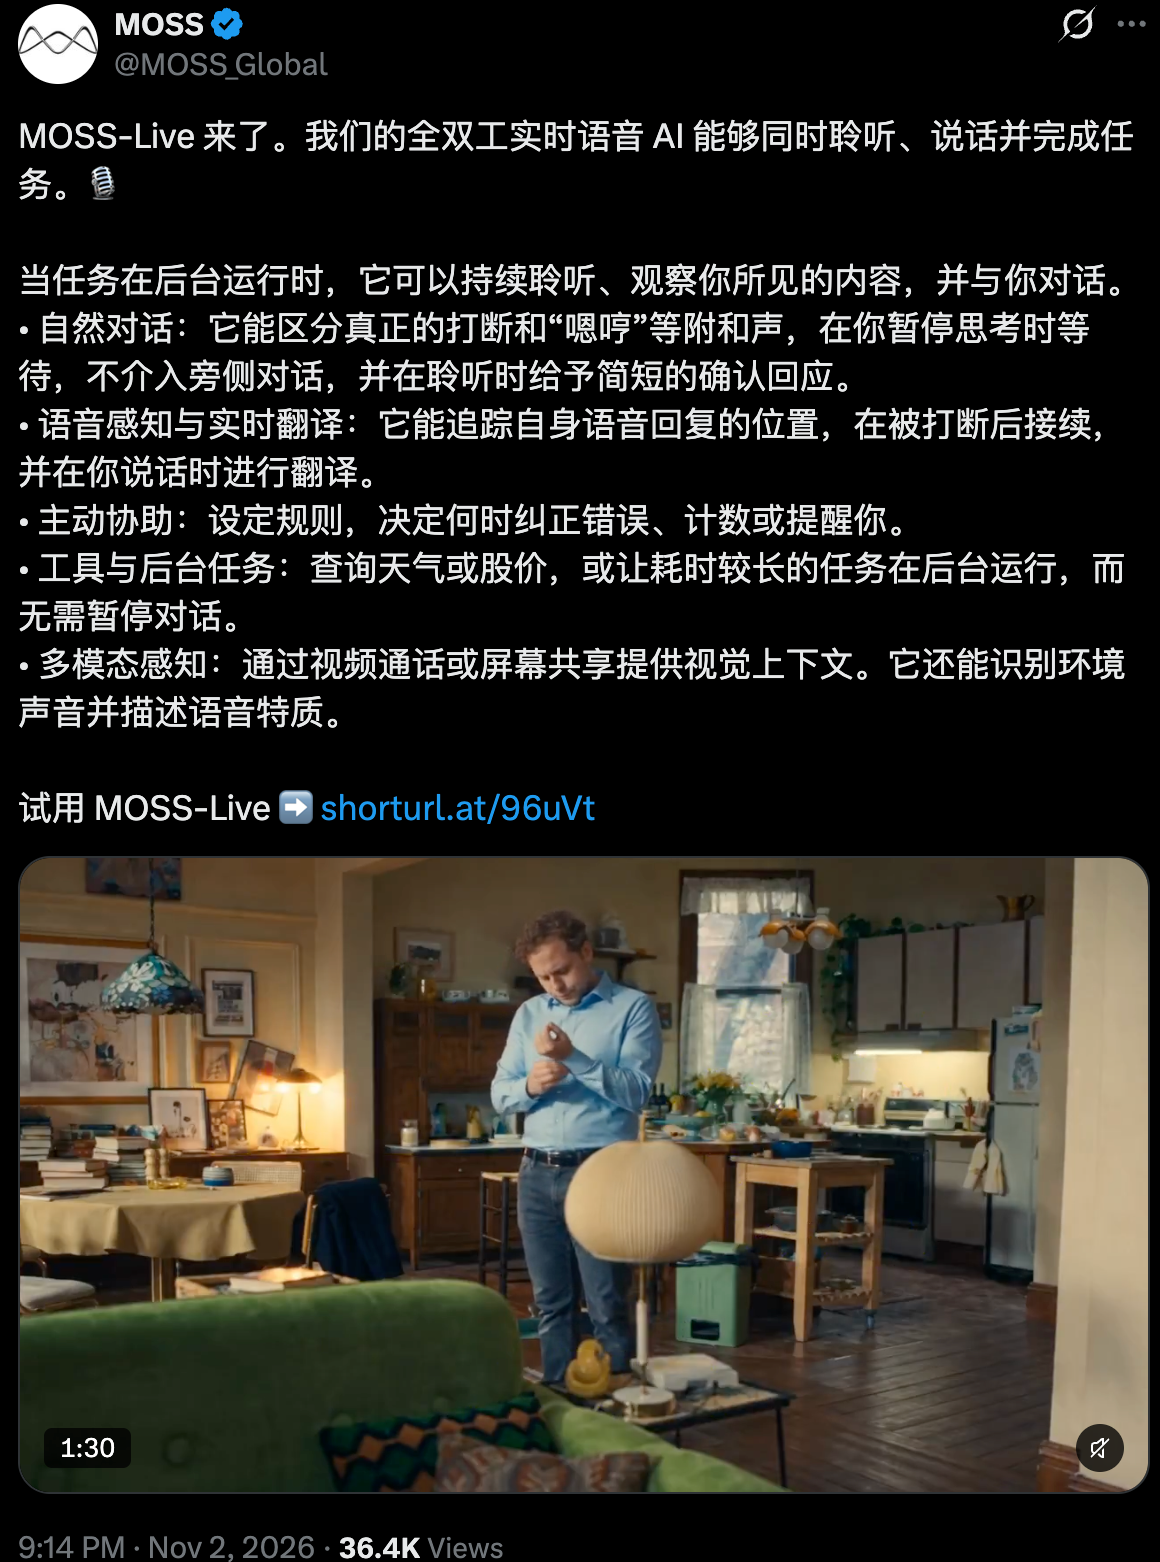
11 月 3 日消息,模思智能发布 MOSS-Live 1.0,定位为全双工实时语音模型。官方文档将其标为 Beta,当前通过 WebSocket /v1/realtime 提供调用。
边听边说,按语义决定停或等
MOSS-Live 在说话时继续接收和理解用户输入。用户以“嗯”等附和回应时,模型继续表达;用户真正打断时,模型停止当前回答。用户停顿思考时,它会等待对方说完。
多人场景中,模型会判断哪些话是在对自己说话,并避开旁人对话。被打断后,它还能从刚才的位置继续,而不是重新回答一遍。
这些能力指向对话节奏的变化。语音交互不再只按“用户说完、模型回答”轮换,模型需要持续判断何时说、何时听,以及何时保持安静。
长任务转到后台,对话继续
MOSS-Live 支持工具调用,可查询天气、股票等实时信息。研究和规划等长程任务可委派给后台 Agent,模型在任务执行期间继续与用户交流,并在合适时播报进度或结果。
全双工与后台委派因此承担不同工作:前者让输入和表达同时发生,后者避免复杂任务占住整段对话。两者结合后,用户不必为了等待任务结果而暂停交流。
这里有一个接口边界。文档支持实时会话内的长任务异步委派,但不提供独立异步任务接口。不能把后台协作写成一套可单独调用的通用任务 API。
视频仅作输入,实时接口已经提供
官方模态表显示,MOSS-Live 接受实时音频和实时视频流,输出音频与文本。文本只作输出,视频只作输入,图片不受支持。
产品页还列出视频通话和屏幕共享。官方 X 帖称模型可识别环境声音并描述声音特质,这些能力目前属于官方宣传,未披露独立测评结果。
当前实时交互端点为 /v1/realtime。单人语音生成、音频转写和通用多模态理解等其他端点均不在本模型的支持范围内。
MOSS-Live 1.0 目前限时按 0 积分计费,免费截止时间未公布。官方也未披露参数规模、开源许可、支持语言清单、GA 时间和延迟指标。当前模型 ID 为 moss-live-1.0。
 AI 速览