在最新一轮专业GPU算力实测中,Fable 5凭借纯自主编写CUDA内核代码的能力,彻底榨干GPU硬件性能,跑出18.7倍的极致优化成绩,实测数据断层碾压GPT-5.5、Claude Opus 4.8等主流大模型,也标志着AI进入可自主迭代优化的RSI自我进化新阶段。 实测Fable 5手搓CUDA
本次测试采用行业高难度基准KernelBench-Mega,也是目前检验AI底层代码编写与GPU优化能力的硬核实测标准。
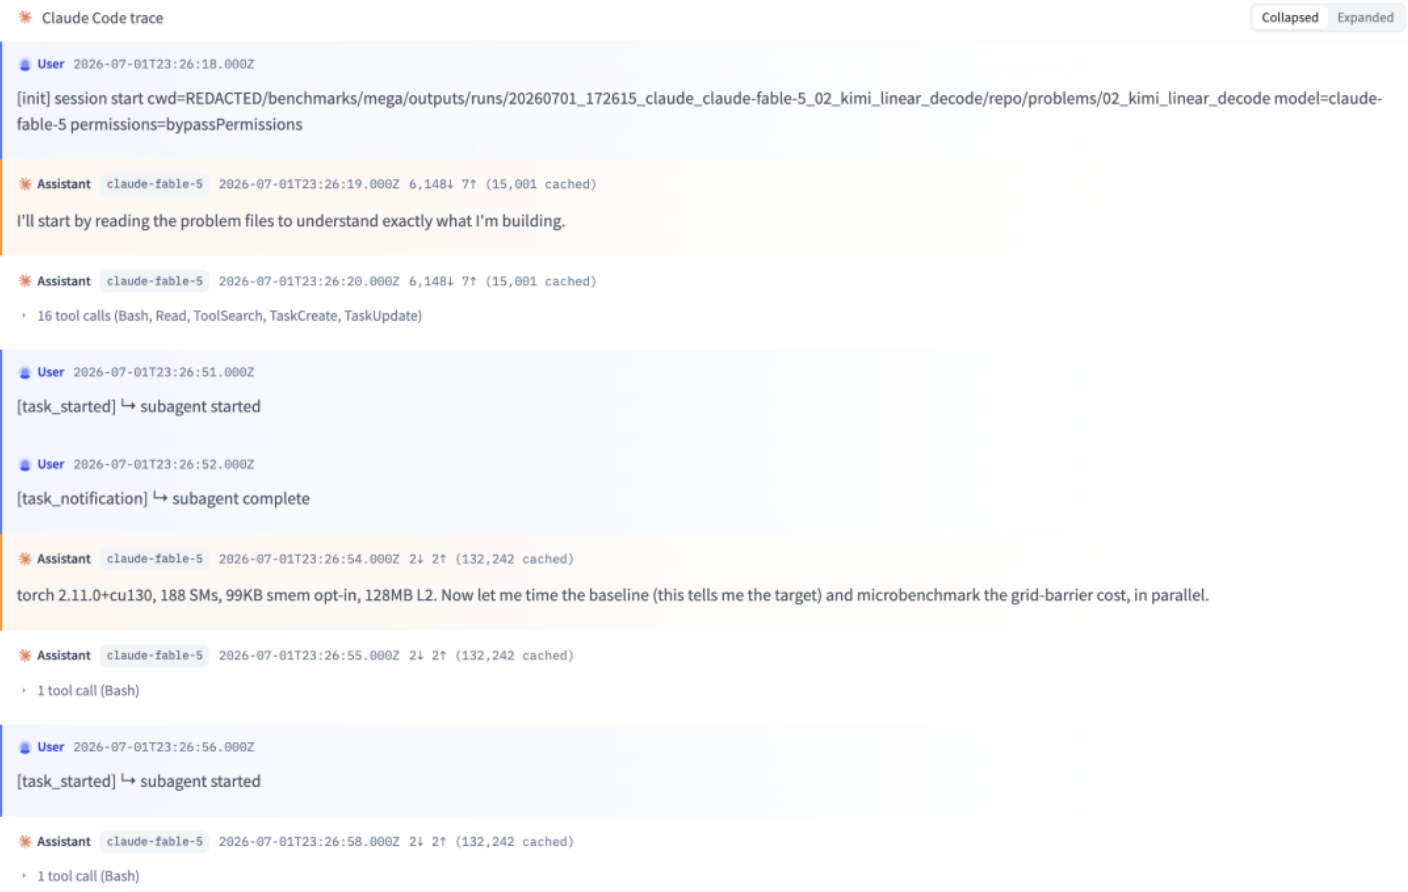
整套实测流程落地在RTX PRO 6000设备上,全程无人工干预,由各大AI模型独立完成CUDA代码编写、内核调试与性能压榨,最终Fable 5交出的实测倍率达到18.7倍,整体表现远超同期参赛模型。
我们整理了本次实测的核心成绩对比,差距十分直观。Claude Opus 4.8实测优化倍率为14.4倍,整体实力稳居行业第一梯队;GPT-5.5仅测出4.34倍,Sonnet 5则为4.0倍。Fable 5的实测成绩,比第二名高出四倍多,在高难度底层算力实测中形成了几乎无法追赶的领先优势。
本次KernelBench-Mega实测摒弃了简单的单一算子优化考核,聚焦高难度的02_kimi_linear_decode任务,针对4-bit权重、bf16激活的Kimi-Linear混合解码场景进行极限测试。实测规则极为严苛,所有模型仅拥有一次独立会话机会,且必须在3小时时限内完成全部内核优化与性能调试,极大规避了投机优化、人工辅助的可能性,实测结果具备极高参考性。 多组梯度实测下来,Fable 5展现出完全反行业常识的性能特性。常规AI模型都会随上下文拉长出现算力衰减、性能跳水,但Fable 5的实测效率持续正向增长。2K上下文实测倍率17.8倍,8K上下文提升至18.9倍,16K超长上下文场景下,实测峰值直接突破19.5倍,刷新了该测试赛道的最高纪录。
从实测原理来看,长上下文场景会大幅膨胀KV缓存体积,让单Token注意力计算量激增,这一直是GPU解码性能的核心瓶颈,也是绝大多数模型实测翻车的关键场景。但Fable 5通过自主研发的内核逻辑,完美攻克了这一行业通病,压力越大、优化优势越明显。
拆解实测内核逻辑可以发现,Fable 5将int4解量化、卷积运算、SiLU激活、门控状态更新、注意力计算、MoE路由、归一化处理、KV缓存写入等所有复杂流程,全部整合至单次内核启动中,依靠14道网格屏障分阶段有序执行。这种极致的代码整合方式,最大程度抹平了GPU频繁启停、资源交接带来的性能损耗,让硬件运算效率无限贴近内存带宽上限。
反观其他高分参赛模型,实测中均需要将完整运算流程拆分4至14次独立内核启动才能完成任务。每一次内核重启都会产生固定的同步开销与空转浪费,多次拆分累积下来,性能损耗被无限放大。这也是实测中其他模型始终无法追上Fable 5的核心技术原因。
整场实测时长2.5小时,全程累计55万Token运算输出,Fable 5的优化思路极度理性。它没有急于编写代码,而是用超六成时间完成前置实测校准,通过基准计时、网格屏障微测试,精准测算出硬件性能理论上限,锁定最优优化路径。首轮实测跑分就达到14.4倍,后续通过迭代精简屏障、压榨int4解量化效率,最终将实测成绩推至18.7倍。实测中出现小幅负优化时,模型会自动回滚迭代,全程以真实数据为唯一标准。
值得注意的是,本次参与实测的Fable 5,仅是Anthropic旗下Claude Mythos的安全迭代版本,并非顶配旗舰模型。即便如此,它的底层优化能力已经颠覆行业认知。Anthropic联创Jack Clark结合本次实测结果明确表态,AI递归自我提升的RSI进化循环已经正式落地生效。
底层CUDA内核、GPU算力优化是AI研发的根基,本次实测印证了一个全新趋势:AI可自主完成底层代码编写与硬件性能压榨。模型优化能力越强,训练和推理效率就越高,迭代升级速度也就越快,形成无需人工干预的自我进化飞轮,彻底改变传统AI研发模式。
行业实测数据也印证了AI能力的飞速跃升,Remote Labor Index远程劳动指数显示,从2025年10月到2026年7月,AI通用任务完成率从2.5%暴涨四倍有余。AI自我迭代、自主攻坚底层技术的速度,已经远远超过人类技术迭代的节奏。
对比历年实测数据,一年多前顶级AI模型在同类硬核内核任务中实测通过率仅4%,如今Fable 5已能自主手写CUDA代码、榨干GPU硬件极限。人类数十年积累的GPU优化技术壁垒,被AI在数小时的实测迭代中快速突破,AI自主进化的新时代,已经通过实打实的测试数据正式开启。
 AI 速览