Cursor(Anysphere)于2026年4月6日发布Warp Decode技术,通过将MoE(混合专家模型)推理的并行化维度从"按专家分配"翻转为"按输出值分配",在NVIDIA B200 GPU上实现1.84倍吞吐量提升,同时输出精度比传统路径更接近FP32基准1.4倍。这项优化直接服务于Cursor自研编码模型Composer的训练和推理管线,使新版本模型能更快迭代和上线。
传统MoE推理路径的瓶颈在哪里
现代MoE模型在每一层将token路由到一部分专家网络——例如从128个专家中选择8个。标准实现围绕专家组织所有计算:收集每个专家需要的token,执行运算,再重新组装结果。
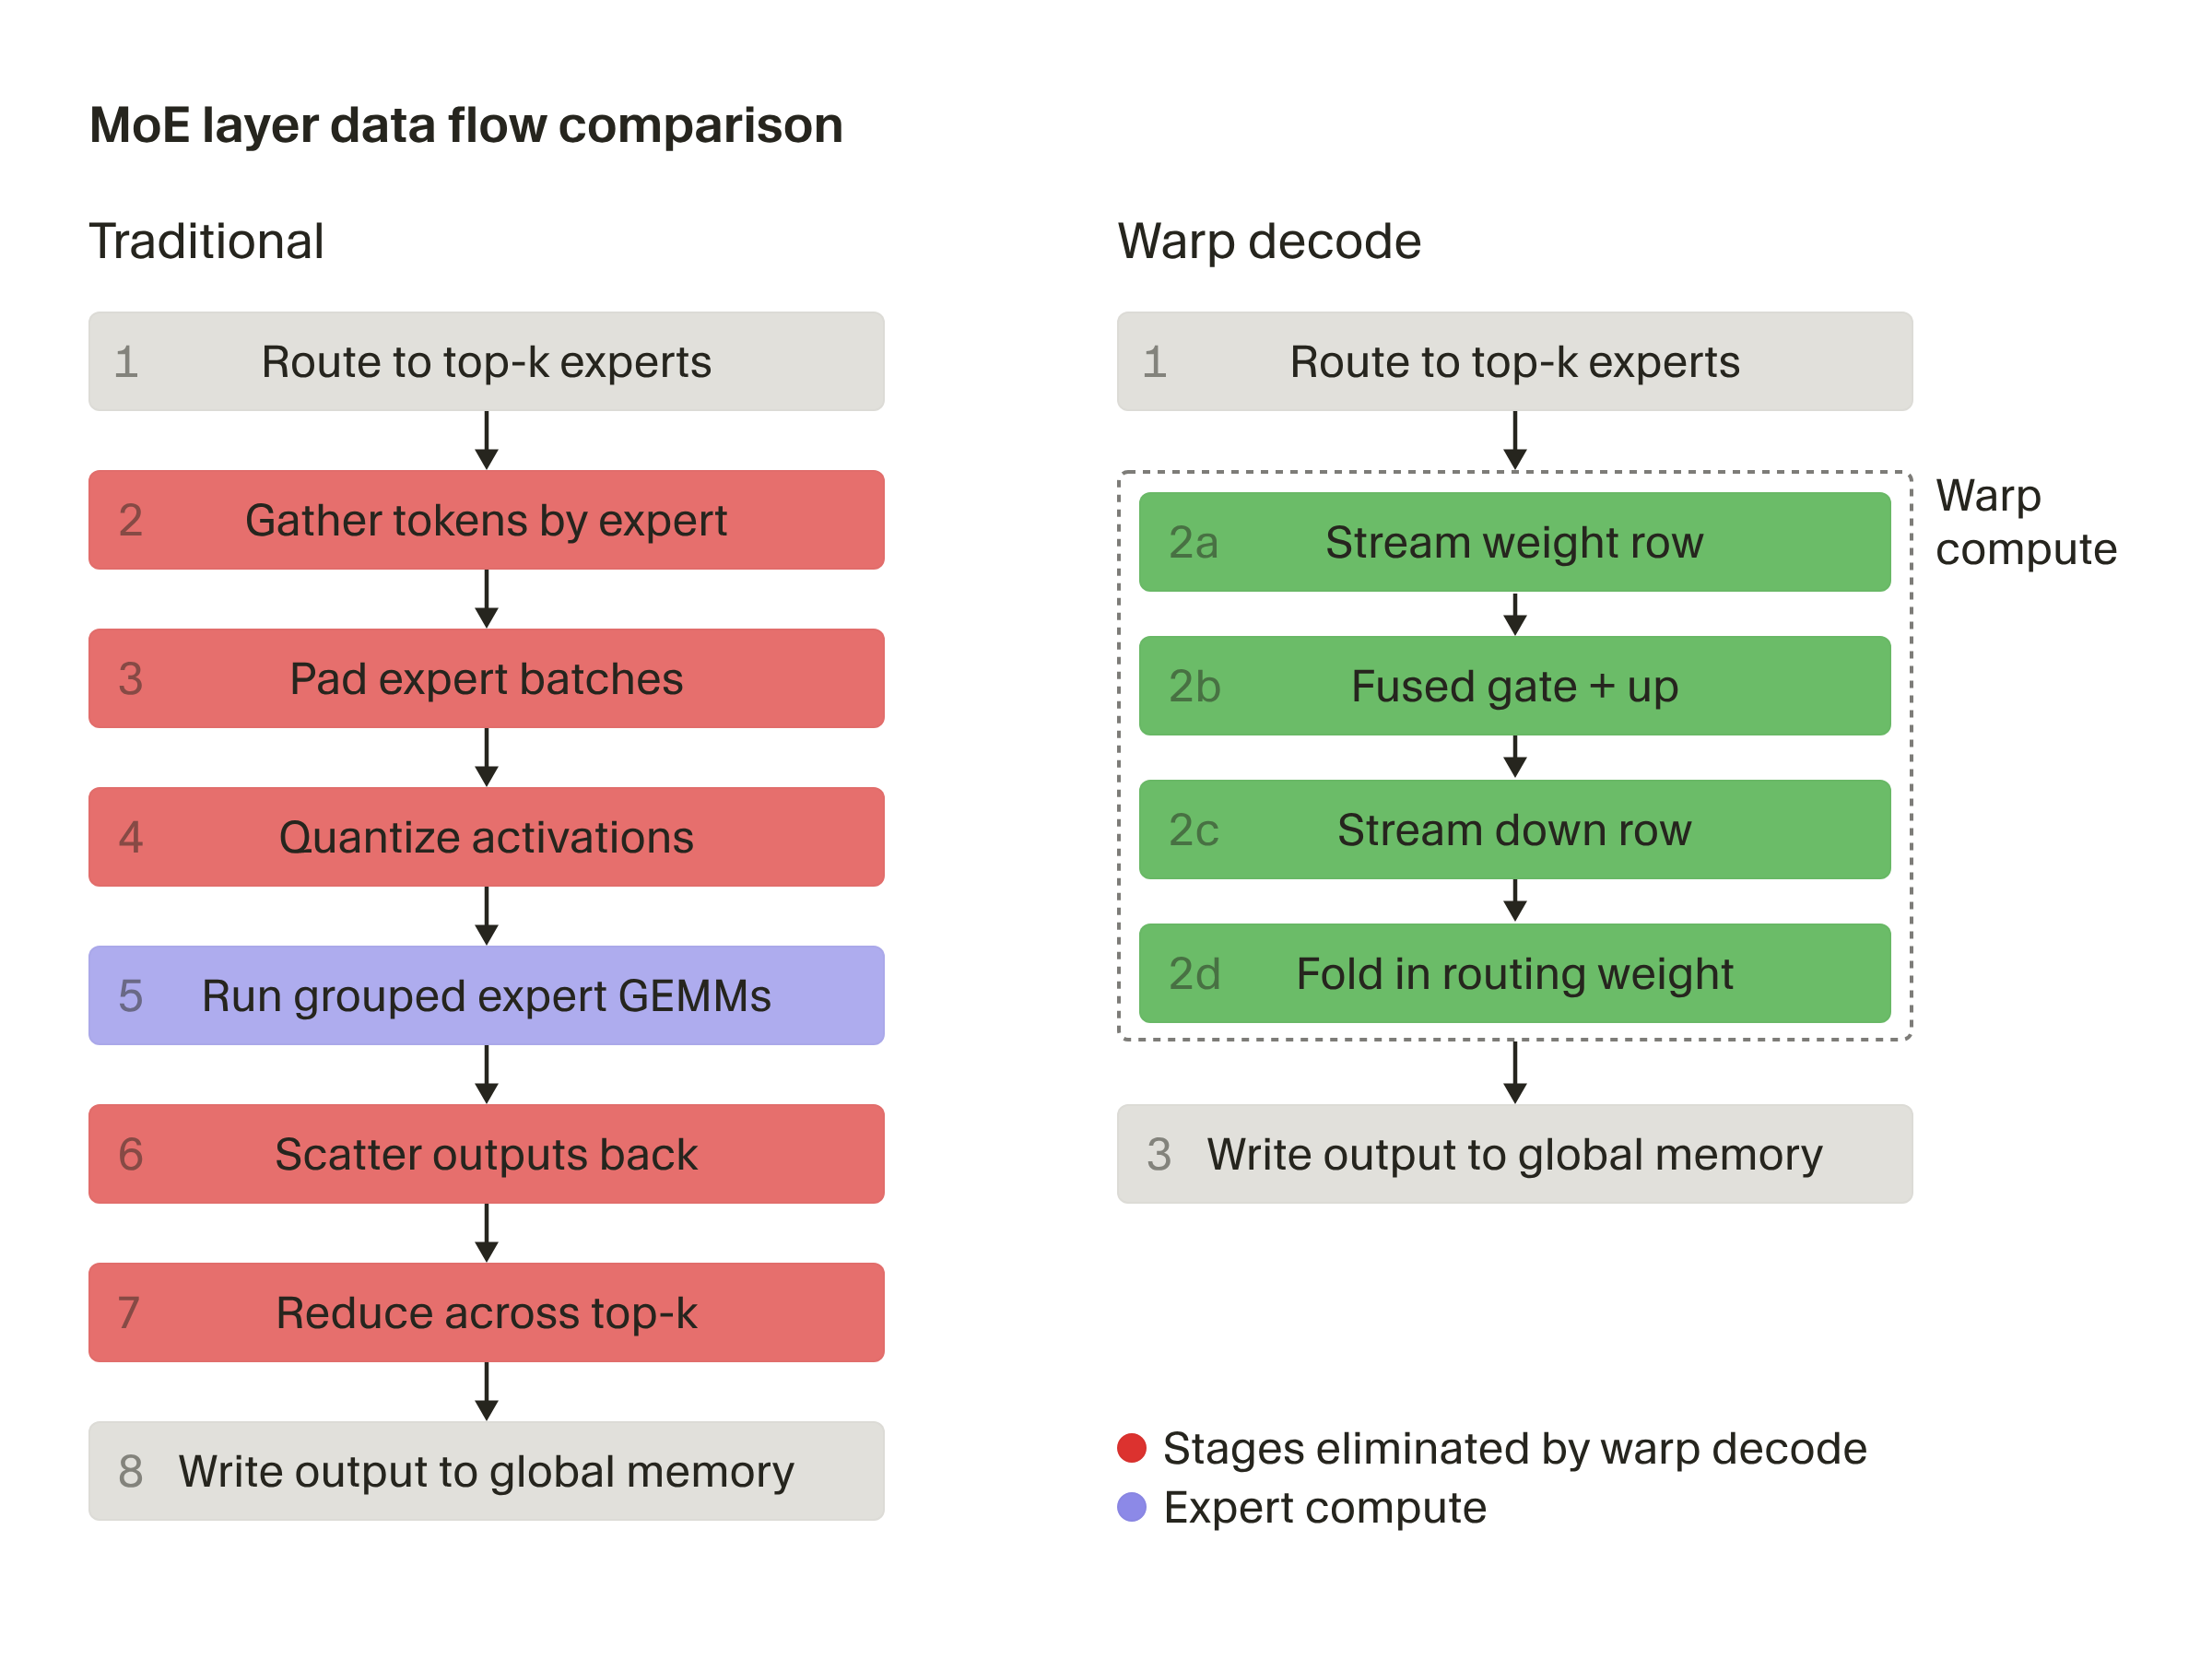
这种"以专家为中心"的架构在预填充和大批量推理时表现良好,因为多个token共享同一专家,组织数据的开销可以被摊薄。但在自回归解码阶段——每次只生成一个token时——没有足够的共享工作量来证明这些开销的合理性。传统路径8个阶段中有5个纯粹是为了管理数据布局,不执行任何实际计算。
这5个阶段包括:token填充对齐(padding到2的幂次或128字节边界)、激活向量按专家维度重排(scatter)、专家输出写入显存后的单独归约(combine),以及两个中间缓冲区的分配与释放。在batch size为1的解码场景下,这些都是无法摊薄的纯开销。
Warp Decode的核心思路:翻转并行轴
Warp Decode的出发点是追问:在Blackwell架构上,MoE解码的理论最大内存带宽是多少?这个问题引导团队彻底翻转了并行化轴——不再将warp分配给专家,而是将每个warp分配给一个输出值(神经元)。
GPU以32个并行处理通道为一组执行指令,这一组称为warp。在Warp Decode中,每个warp被分配恰好一个输出标量值来计算。warp直接从显存流式读取所需权重数据,在单个运行累加器中聚合所有8个被路由专家的贡献,然后写出一个结果。
这种设计使每个warp完全独立——无需暂存、数据交接、跨warp同步点或中间缓冲区。整个MoE计算层被压缩为两个kernel:moe_gate_up_3d_batched和moe_down_3d_batched。
两个Kernel的具体工作方式
Gate/Up Kernel中,每个CTA(协作线程数组)包含8个warp,每个warp负责一个中间神经元。warp加载被路由的专家ID,读取该神经元的gate和up权重行,流式遍历输入激活向量。MXFP8权重在计算过程中即时转换为FP32,两个点积在私有寄存器中累加。由于gate和up两个投影被融合为一次遍历,激活向量只读取一次即被两个投影复用,无需共享内存暂存。
Down Kernel中,每个warp负责一个token的一个输出维度。它遍历所有top-k被路由专家,加载对应的下投影权重行并流式处理中间激活,将每个专家的路由权重折叠进单个FP32运行累加器。最终通过__shfl_xor_sync指令执行warp级蝶形归约——这是一个直接编译为PTX硬件原语的指令,在warp内的通道间交换寄存器,完全绕过共享内存。
关键收益在于:不需要L1缓存往返、不存在bank冲突、不需要显式同步屏障。加权的top-k合并不是一个独立的后处理步骤,而是投影计算本身的一部分。
性能提升的三重来源
第一是阶段消除。填充、scatter和combine三个阶段被完全移除,这贡献了大部分吞吐量增益。需要注意的是,移除这些阶段不是简单地融合传统管线的步骤,而是需要从根本上重组并行化方式。
第二是缓冲区消除。传统路径需要两个中间缓冲区:一个用于将激活向量复制并重排为按专家排列的布局(batch size 1时是完全冗余的拷贝),另一个是每专家输出缓冲区。以8个专家、隐藏维度2048计算,后者每个token需要32KB BF16显存,分配后写入、读取一次即丢弃。Warp Decode通过将8个专家贡献折叠到32个warp通道的寄存器累加器中消除了这两个缓冲区,释放的L2缓存容量可用于真正影响性能的权重行。
第三是Warp独立性带来的调度优势。由于每个warp只拥有一个输出标量、只读取所需的权重行,不存在warp间的共享可变状态。GPU的warp调度器可以在任意时间、以任意顺序发射任意warp。当一个warp因等待内存加载而停滞时,调度器立即切换到另一个。在B200的148个流多处理器上有数千个warp同时执行,内存延迟几乎完全被其他warp的有效计算隐藏。
实测结果:1.84倍吞吐、1.4倍精度、58%硬件效率
在Cursor内部推理系统上使用Qwen-3风格模型和B200 GPU测试,Warp Decode实现了1.84倍端到端解码吞吐量提升,且增益在所有上下文长度区间保持一致——这说明它是纯粹的生成阶段优化,不依赖于提示长度。
精度方面,传统路径需要将BF16激活量化为MXFP8再转回,引入的舍入误差会在模型各层累积。Warp Decode全程保持激活在BF16、累加器在FP32,输出与完整FP32基准的接近程度比传统路径高1.4倍。
硬件效率方面,B200的峰值连续内存读取带宽为6.8 TB/s,Warp Decode在batch=32时持续带宽达3.95 TB/s,即峰值的58%。剩余差距可能来自专家路由导致的随机访问模式(token可能被路由到不相邻的专家如5、8、14、19)。与参考实现的一致性极高:最小余弦相似度>0.999996,最大绝对差异0.001953。
Warp Decode在Cursor技术栈中的位置
Warp Decode不是通用的专家推理替代方案。预填充和大批量推理仍然适合以专家为中心的方式,因为多token共享同一专家时,组织开销可以被摊薄。Warp Decode专门优化的是小批量自回归解码,这恰好是交互式编码助手最频繁的推理场景。
Cursor目前通过"实时强化学习"方法持续改进Composer模型,从生产环境的用户交互中提取训练信号,每约5小时就能发布一个改进版checkpoint。Warp Decode加速了这个反馈循环——推理更快意味着更多用户交互数据、更快的RL训练周期、更频繁的模型更新。
Composer 2在SWE-bench Multilingual上得分73.7,Terminal-Bench 2.0上得分61.7,以显著低于可比模型的推理成本实现了精度与成本的帕累托最优。Warp Decode是支撑这一成本优势的关键基础设施之一。
局限性与适用边界
Warp Decode目前仅针对NVIDIA Blackwell架构(B200 GPU)优化,在Hopper(H100)上是否有类似增益未被提及。它只适用于小批量解码场景,大批量推理和预填充阶段仍需传统的专家并行方式。58%的硬件效率利用率说明还有优化空间,随机访问模式是当前瓶颈。此外,该技术目前是Cursor内部使用,未作为开源项目发布,其他MoE推理框架(如vLLM、SGLang)无法直接受益。
 AI 速览