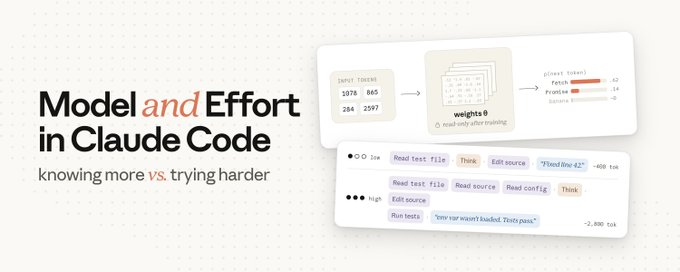
Claude Code 给了你两个看起来都能“让答案更好”的设置:模型和工作等级。那么你应该在什么时候选哪个呢? 人们很容易假设:选择像 Fable 这样更大的模型,就能得到比 Sonnet 更聪明的输出;而把工作等级调高,只是让 Claude 在回答前多思考一会儿。 第一个假设是对的。根据行业标准基准,我们最大的模型确实能力更强。
但工作等级远不止是“思考时间”。工作等级控制了 Claude 在你的请求上总体做了多少工作。这包括它思考多长时间,但也包括:
在更高的工作等级下,Claude 会采取更多这些行动(读取文件、运行测试、双重检查)才返回给你。在较低的工作等级下,它更愿意向你索要更多上下文,而不是自己花费 tokens 来弄清楚某些事情。
模型选择是如何工作的
要理解模型设置到底控制什么,最好从你按下回车的那一刻开始看。
Claude Code 会把你的消息、系统提示、工具定义、你的 CLAUDE.md、对话历史,以及上下文中所有文件,全部组装成一个请求发送给 API。
模型从来不会把这些内容当成普通文本看待。服务器上发生的第一件事是分词(tokenization):文本被切成小块,每一块映射成模型训练时固定词汇表里的一个整数。从这一刻起,你的提示就变成了一个整数数组。
模型的工作就是拿到这个数组,预测下一个 token 是什么。它会为词汇表里的每一个 token 计算概率,然后从中挑选。
把输入 token 变成这些概率的,是权重(weights,也叫参数)——数十亿个数值,组织成巨大的矩阵。权重就是模型“知道”的一切所在。
每个模型的权重都是在训练阶段确定的,等你发请求时它们已经是只读的了。你的提示、CLAUDE.md 或上下文,都无法改变这些权重。
所以,改变模型到底做了什么?它只是把处理你请求的那套冻结权重换掉了。
模型不会一次性生成整个答案。它会预测一个 token,把它加到序列里,然后重新跑一遍整个计算来得到下一个 token。这个循环就是你大部分等待时间(和输出费用)产生的地方。
模型设置决定了哪一套权重来处理你的请求,同时也决定了每个输出 token 的单价。
它不决定的是会生成多少个 token。这个数量对同一个提示可能差异很大,取决于 Claude 决定要做多少工作。
而这正是工作等级所控制的。
工作等级是如何工作的
在 Claude Code 处理任务时,它生成的 token 大致分为几类:
- 思考:你在流式输出中看到的推理过程,在行动之间也会出现。
- 工具调用:结构化的块,指定要用哪个工具(如 Read 或 Edit)以及参数,Claude Code 会解析并执行。
这些都是来自同一个循环的普通输出 token,按相同费率计费。
工作等级是作为请求的一部分直接发给模型的,和你的提示一起。模型在训练时就学会了在不同工作等级下该如何表现。
工作等级越高,Claude 通常会制定更深入的计划、读取更多文件、进行更多验证,并在必要时双重检查结果。
如何选择工作等级
对于大多数任务,使用模型的默认工作等级就够了。默认级别是 Claude 根据大多数人愿意为一个任务花费的 token 量来自动调节的。
把工作等级当成一个手动开关,用来控制 Claude 工作有多彻底、用多长时间。当你对彻底性或速度有强烈偏好时,再去主动调整它。
当 Claude 出错时该改什么
当 Claude 出错时,你的第一反应不应该是改设置,而应该先看你给它的上下文。
如果 Claude 已经拥有所有相关上下文,也确实努力了,但还是错了,那么你要问自己:是它知道得不够,还是它投入的工作不够?
模型:问题是太难了
当问题是真正困难的(比如微妙的 bug、不熟悉的领域、架构决策)时,选择更大的模型。
工作等级:Claude 投入的工作不够
如果 Claude 出错是因为跳过文件、没跑测试、没双重检查,就提高工作等级。
专才、专家和通才
我喜欢用下面这个类比来理解这两个设置:
工作等级决定的是他们中的任何一个在你的任务上花了多少时间。
没有哪一个是 universally 更好 的。模型设置大致对应能力高低,工作等级大致对应投入程度。大多数真实任务都需要两者兼顾一些。
工作等级、模型与 token 消耗
模型选择、工作等级和 token 消耗三者如何相互作用?取决于具体任务。
在常规工作且工作等级相同的情况下,两个模型通常都能做对。更大的模型会因为额外的验证步骤消耗更多 token,而且单 token 价格更高。
而在更难的多步骤工作中,较大的模型往往能用更少的步骤达到同样的质量标准。这在 Fable 上表现得最明显。
工作等级决定 Claude 愿意沿着那条曲线走多远。但这并不意味着 Claude 必须走那么远才能完成任务。
这篇文章由 Claude Code 团队技术成员 @lydiahallie 撰写。
 AI 速览