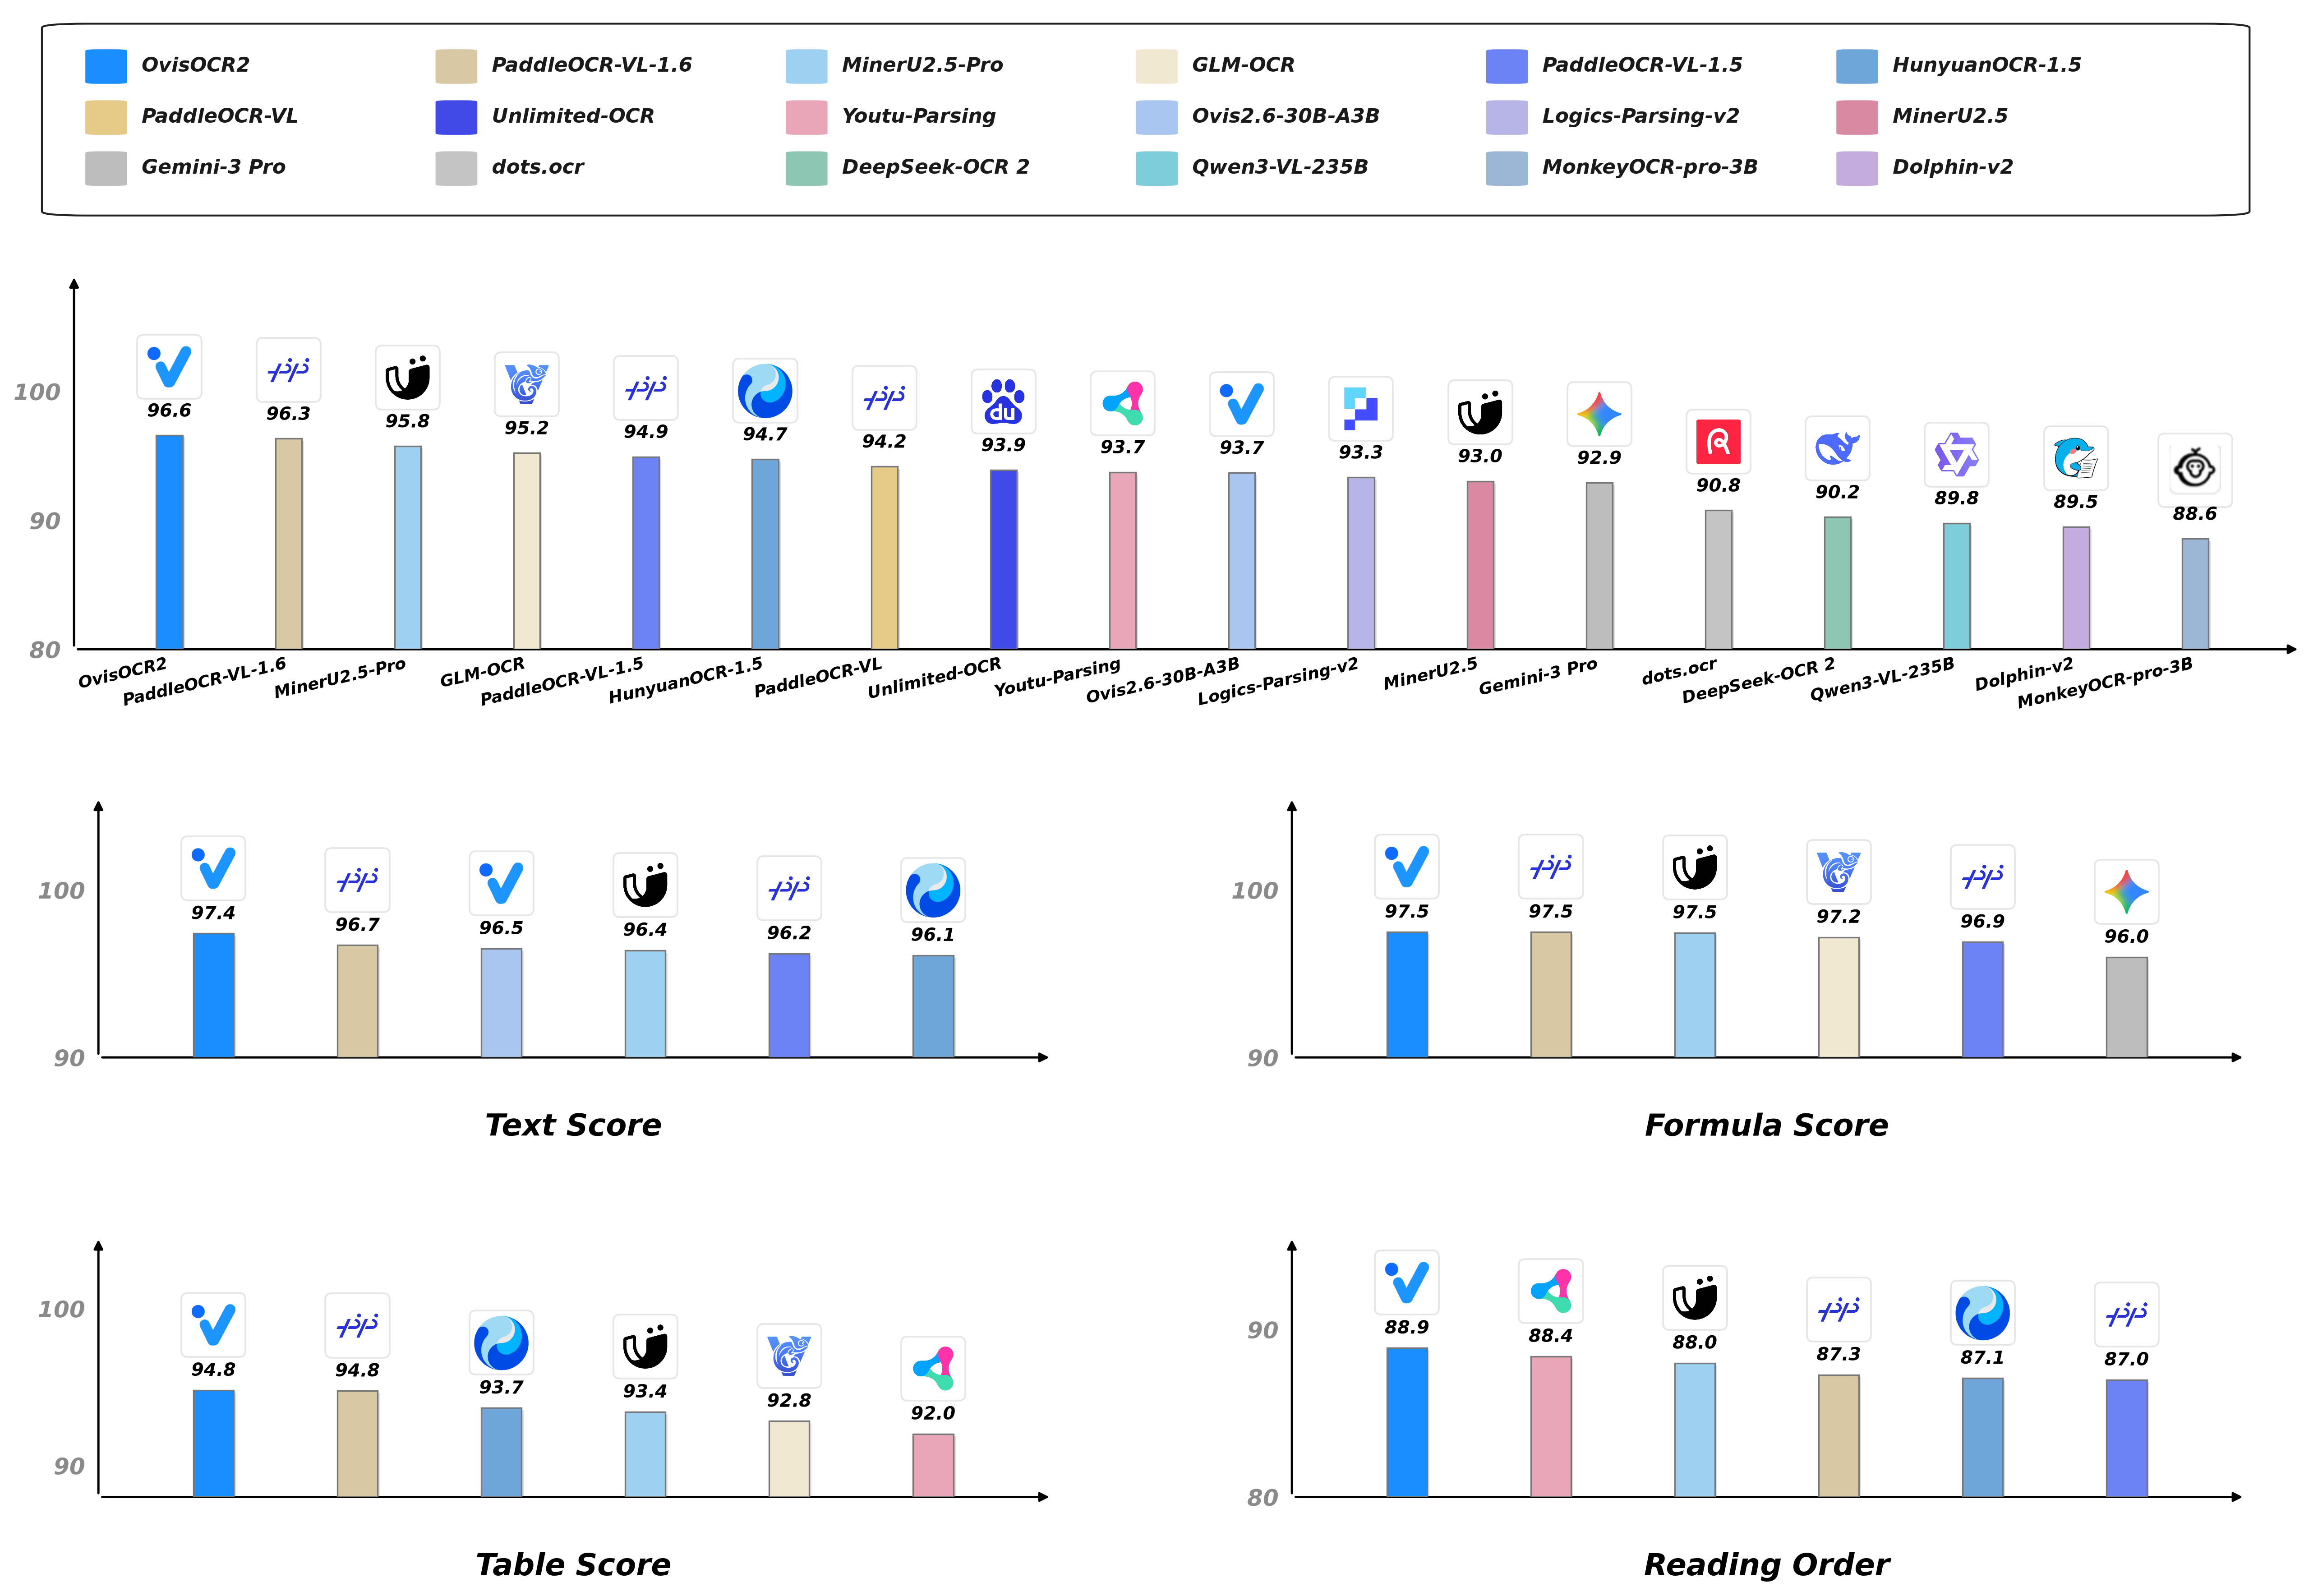
7月15日消息,阿里巴巴 Token Hub 团队在 Hugging Face 发布并开源文档解析模型 OvisOCR2。这是一个 0.8B 级的端到端模型,输入一张文档页图像,直接输出按自然阅读顺序排列的 Markdown,覆盖文本、公式、表格和图像区域。模型页称其在 OmniDocBench v1.6 上取得 96.58 的总分,刷新该榜单最高成绩,并成为首个登顶这一此前由 pipeline 方法主导的榜单的端到端模型。值得关注的信息有两点:一是端到端方案第一次在该榜单上压过传统的多模块流水线方案,二是达到这一成绩的模型体积只有 0.8B 级。需要说明的是,上述 benchmark 成绩来自模型页的官方自述,尚无第三方独立复测,模型页自身也提示在复杂文档上仍可能出错、关键场景需人工校验。
一个 0.8B 模型直接把文档页转成 Markdown
OvisOCR2 走的是端到端路线:不做版面检测、局部裁剪、专用识别器和启发式合并的多步拼接,而是把整页文档的视觉信号直接映射为结构化的 Markdown 输出。按模型页给出的推理设定,它把公式格式化为 LaTeX、把表格转为 HTML,并用带坐标的图像标签标记图表和图片区域,其余文本按标准 Markdown 转写,且要求保留原文、不做翻译或改写。
模型由阿里自家的 Qwen3.5-0.8B 后训练而来,采用了结合真实与合成数据的数据引擎,以及整合 SFT、RL 和 OPD 的多阶段训练流程。除了 OmniDocBench v1.6 的 96.58 分,模型页还称其在 PureDocBench 上取得 75.06 的 Avg3 最高分。模型以 Apache-2.0 许可开源,权重已在 Hugging Face 上线,采用 BF16,实际权重参数计数约为 0.9B。技术报告署名的第一作者为 Lu Shiyin,作者名单还包含 Ovis 系列核心成员罗为华(Weihua Luo)、Chen Qing-Guo 等。
发布主体方面,模型由阿里巴巴 Token Hub 团队推出,其 Hugging Face 账号 ATH-MaaS 即对应 Alibaba Token Hub。OvisOCR2 沿用了阿里 Ovis 多模态系列的命名与技术脉络,技术报告作者也与此前发布 Ovis 系列的阿里 AIDC-AI 团队有重合,属于阿里内部同一技术谱系下的产出。
端到端首次压过 pipeline 方法,是这次发布的范式看点
理解这次发布的分量,要放回文档解析的技术路线之争里看。长期以来,高精度文档解析的主流是"检测版面、局部裁剪、专用识别、再启发式合并"的流水线方案,OmniDocBench 这类榜单也一直由 pipeline 方法占据前列。这类方案的问题在于多个模块串联会累积误差,且全局阅读顺序的一致性难以保证。端到端模型把整页一次性映射为结构化输出,理论上减少了误差传播、改善了序列化一致性,但过去在精度上一直追不上成熟的流水线工具。
OvisOCR2 声称成为首个在 OmniDocBench v1.6 登顶的端到端模型,如果这一结果站得住,意味着端到端方案在文档解析这个具体任务上第一次追平并反超了流水线方案,且是用一个 0.8B 级的小模型完成的。对需要在资源受限环境部署文档解析能力的开发者和企业来说,"小体积 + 端到端 + 开源"的组合会直接影响选型。
从 OvisOCR 到 OvisOCR2:参数更小,榜单更新
把这次发布放在 Ovis 自己的迭代线上看,变化方向很清楚。上一代 OvisOCR 是一个 1.3B 参数的端到端文档解析模型,在 OmniDocBench v1.5 上取得当时的领先成绩。OvisOCR2 把参数压到 0.8B 级,同时把对标榜单更新到 v1.6 并登顶。参数下降而榜单成绩提升,反映的是这一代在数据引擎和训练配方上的投入,而不是靠堆模型规模换性能。这条"更小、更强"的路径,与近一年小模型能力密度持续提升的行业趋势一致。
真正的信号是路线和体积,不是榜单名次本身
这次发布容易被读成"又一个 OCR 模型刷了 SOTA",但单纯的分数刷新在文档解析领域并不稀缺。真正的增量在两处:其一是路线意义,端到端方案首次在该榜单越过流水线方法,若被第三方证实,说明文档解析的技术重心正在从多模块拼接向端到端 MLLM 迁移;其二是体积,0.8B 级模型达到这一成绩,把高精度文档解析的部署门槛显著拉低。
需要克制的地方同样清楚。96.58 与 75.06 都是官方自述的 benchmark 结果,benchmark 分数与真实业务中复杂版式、低质量扫描件、多语言混排文档下的可用性之间存在差距,模型页的免责声明也明确提示可能产生重复输出、内容缺失、表格或公式结构无效、阅读顺序不一致等问题。把榜单登顶直接读成"文档解析已被小模型解决",是目前材料不支持的过度解读。
接下来要看第三方复测与真实文档表现
后续最该观察的是独立验证。模型、权重和技术报告已开源,社区已有基于它的文档处理数据集出现,这让外部团队有条件在同一榜单和自有文档集上复跑,检验 96.58 的领先是否在中立执行下稳健,以及端到端方案越过 pipeline 是否是可复现的结论而非单次调优结果。与此同时,真实负载下的表现、推理部署的实际资源占用、以及在多语言和复杂版式上的稳定性,都需要时间来验证。训练配方中 OPD 等环节的具体细节,也有待技术报告进一步披露。
 AI 速览