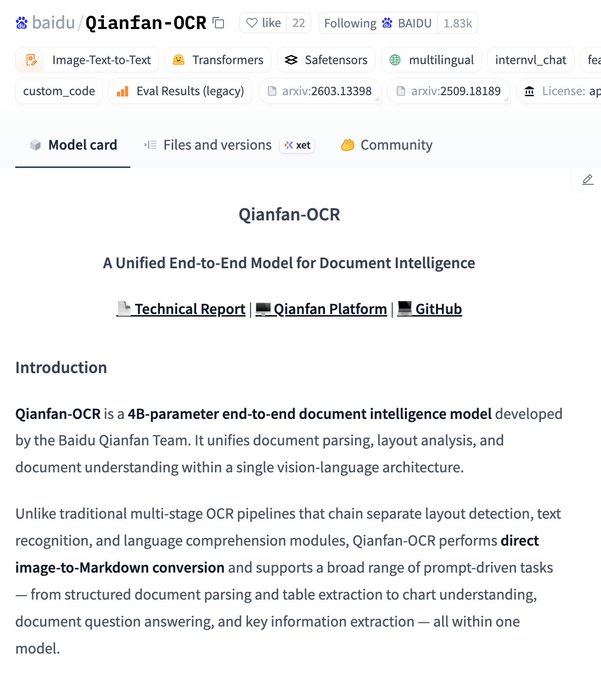
3月18日消息,百度智能云千帆团队正式开源全新文档智能模型Qianfan-OCR,模型权重及代码已上线Hugging Face平台。这是一个40亿参数的端到端文档智能模型,将文档解析、版面分析和文档理解整合在单一视觉语言架构中,支持192种语言的OCR识别,在1,024块百度自研昆仑芯P800芯片上完成训练,处理了2.85万亿个token。
与传统多阶段OCR流水线需要串联布局检测、文字识别、语义理解等多个独立模块不同,Qianfan-OCR可直接实现图像到Markdown的转换,并通过提示词驱动支持结构化文档解析、表格提取、图表理解、文档问答及关键信息抽取等多种任务。
在架构方面,Qianfan-OCR延续了此前Qianfan-VL的多模态桥接架构,视觉编码器采用Qianfan-ViT(24层Transformer,支持最高4K分辨率),语言模型基于Qwen3-4B,通过两层MLP适配器连接视觉与语言模态。
该模型的一大核心创新是"Layout-as-Thought"(版面即思考)机制。通过可选的⟨think⟩标记触发思考阶段,模型会先生成结构化版面分析结果(包括边界框、元素类型、阅读顺序),再输出最终内容,在复杂版面场景中显著提升准确率。
基准测试方面,Qianfan-OCR表现亮眼:在OmniDocBench v1.5文档解析基准中以93.12分位列端到端模型第一,超越DeepSeek-OCR-v2(91.09)和Gemini-3 Pro(90.33);在OlmOCR Bench上以79.8分同样排名端到端模型首位;在关键信息抽取任务中以87.9的综合均分超过Gemini-3.1-Pro、Seed-2.0及Qwen3-VL-235B等模型。 部署效率上,Qianfan-OCR在W8A8量化下可在单张A100 GPU上实现每秒1.024页的推理吞吐,已具备生产级部署条件。
值得注意的是,Qianfan-OCR是百度千帆视觉模型系列的最新成果。此前百度智能云于2025年9月开源了Qianfan-VL系列模型(3B/8B/70B),同样基于昆仑芯P800完成全流程计算。此次推出的Qianfan-OCR进一步聚焦文档智能垂直领域,在OCR识别、版面分析、表格和公式识别等企业级高频场景上实现了更精准的能力覆盖。
该模型采用Apache 2.0开源许可证,相关技术报告已发布于arXiv(论文编号:2603.13398)。
 AI 速览