- SEED 是一种面向智能体强化学习(Agentic RL)的自进化蒸馏框架,解决长程任务中稀疏奖励的监督断层问题
- 核心机制:策略模型将自身完成的轨迹分析为自然语言"事后技能",再通过有无技能条件下的概率偏移生成密集 Token 级蒸馏信号
- 联合优化目标 L_SEED = L_GRPO + λ · L_OPD,在 GRPO 基础上叠加自蒸馏损失,无需外部教师或过程奖励模型
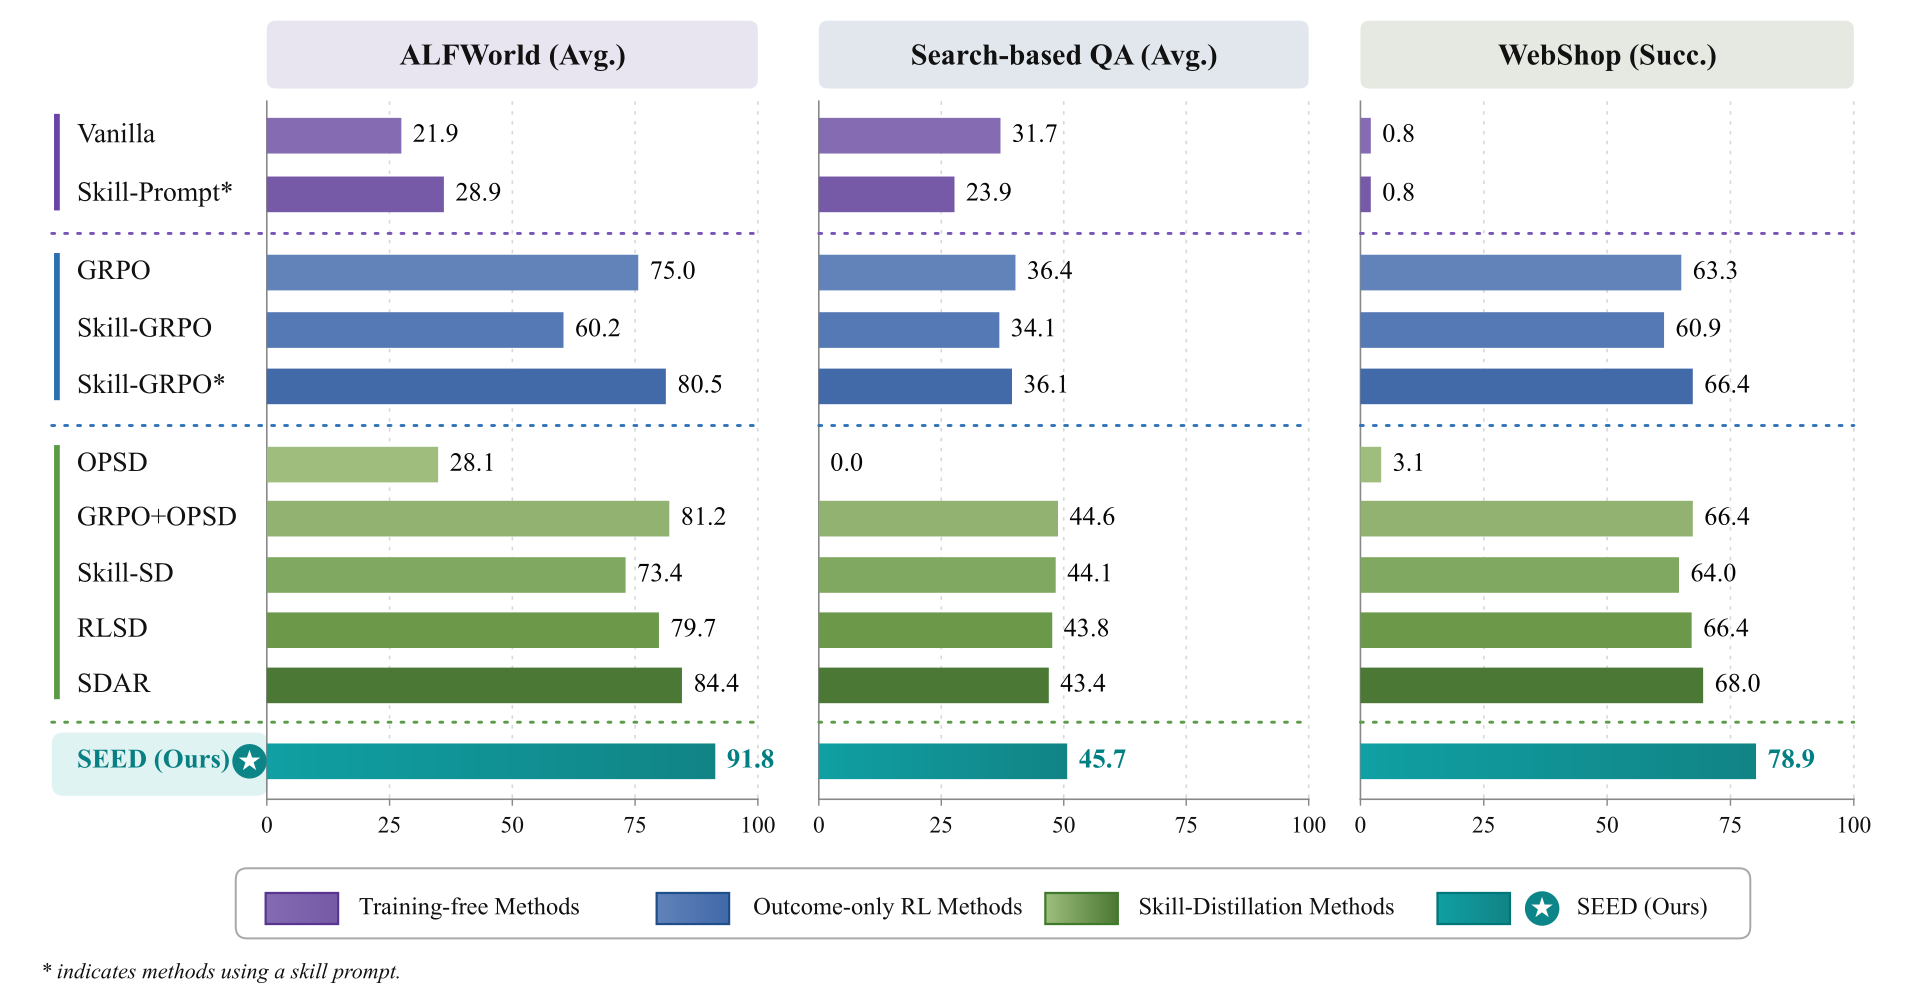
- ALFWorld 任务达到 91.8%(GRPO 基线 75.0%);1.7B 小模型提升更显著,从 46.1% 跃升至 92.0%
- 仅用约 60% 的轨迹数据即超越 GRPO 全量数据表现,未见场景泛化提升 +15.3 个百分点,推理时零额外开销
一句话说清楚:这论文在解决什么问题
训练一个能自主完成多步任务的 AI 智能体——比如让它在虚拟家居环境中找物品、在网上购物、或回答需要多轮搜索的问题——本质上是一个长程决策问题。智能体需要执行一连串动作,每一步都依赖前一步的结果,最终才能收到"成功/失败"的信号。
问题就出在这个信号上。当前主流的基于结果强化学习(如 GRPO)只在整条轨迹结束时给出一个奖励分数。智能体可能走了 30 步,其中 28 步是对的,2 步是错的,但它只知道最终结果——好或不好——完全不知道哪一步对了、哪一步错了、为什么错。这种稀疏奖励在短程任务中尚可,一旦任务链条拉长到几十步甚至上百步,智能体几乎无法从末端信号中有效学习中间决策。
SEED 的目标就是在不依赖人工标注、不引入外部过程奖励模型的前提下,让智能体从自己已完成的轨迹中"事后总结"出可复用的决策技巧,再把这些技巧转化为每一步的密集监督信号。
核心方法:它怎么解决的
SEED 的创新可以理解为一条自进化链路:跑轨迹 → 提取技能 → 用技能给自己打分 → 优化策略,闭环运行,教师和学生始终对齐。
用事后视角提取经验
SEED 让策略模型在完成一条轨迹后,回过头去分析自己刚走过的每一步。这个分析不是简单的对错判断,而是生成一段自然语言描述的"事后技能"——比如"当观察到冰箱里有牛奶但任务要求做早餐时,应该先拿鸡蛋再找平底锅"或者"查询数据库时如果第一次没结果,试试同义词"。技能的内容包括可复用的工作流、关键观察点和避错规则。关键是一点:生成技能的模型和正在训练的模型是同一个,而且随着策略变强,技能质量也在同步提升。这避免了传统离线蒸馏中教师更新不及时导致的错位问题。
用概率偏移创造密集信号
有了技能之后,SEED 做了一个精巧的"回放打分"操作。它对同一条轨迹中采样过的动作重新算两遍概率:一遍是在普通上下文中(标准提示+历史),另一遍是在技能增强的上下文中(标准提示+历史+事后技能)。如果加入技能后模型对正确动作的概率变高了,说明这条技能确实提炼出了有用的决策知识。这个概率差(Δ log-prob)经过一个 S 型门控处理后,就变成了一条逐 Token 的密集蒸馏信号。
这条信号和 GRPO 的稀疏结果奖励被联合优化:L_SEED = L_GRPO + λ · L_OPD。GRPO 负责大方向的成功/失败判别,自蒸馏信号负责每一步的精细引导,两者互补。训练完成后,技能已经被内化到模型权重中,推理时不需要任何额外的技能检索或提示注入。
成绩单与对比
SEED 在三个 Agent 基准任务上进行了验证,涵盖文本操作、网页交互和搜索推理三种典型场景。
在 ALFWorld 文本家居操作任务中,SEED 的 3B 模型平均成功率达到 91.8%,GRPO 基线仅为 75.0%,差距达到 16.8 个百分点。当模型规模缩小到 1.7B 时,差距进一步拉大:SEED 得到 92.0%,而 GRPO 仅 46.1%——这意味着在小模型上,GRPO 的稀疏奖励几乎无法有效训练,而 SEED 的密集信号弥补了这一缺陷。
在 Search-QA 搜索型问答任务中,SEED 平均得分 45.7,领先于技能蒸馏类方法(如 OPSD、SDAR 等)和纯结果 RL 方法,这些方法多在 43-44 分区间。在 WebShop 在线购物模拟任务中,SEED 成功率达到 78.9%,显著高于同类方法的 60-68% 水平。
数据效率方面也值得关注:SEED 仅使用约 60% 的轨迹数据就能达到甚至超越 GRPO 用全量数据训练的效果。泛化能力上,在未见过的测试集上 SEED 比基线高出 15.3 个百分点,说明从轨迹中提取的事后技能确实学到了可迁移的决策逻辑,而非简单记忆场景。
这些实验运行在标准 GPU 环境下,依赖的硬件配置与 GRPO 一致,没有额外算力开销。
意义与局限
SEED 的意义在于它指出了一个方向:强化学习智能体不一定需要外部教师、过程奖励模型或人工标注来学习中间步骤。只要设计好"如何从自身经验中提炼并消化知识"这个闭环,策略可以在训练过程中自我提升——而且提升后的策略反过来又能产出更好的经验,形成正反馈。
这种方法特别适合训练工具调用、多轮交互、网页操作等长程 Agent 任务。考虑到 GRPO 在 DeepSeek-R1 等推理模型上的广泛应用,SEED 的"叠加密集蒸馏"思路有望被快速集成到已有的 Agent 训练管线中。 但 SEED 也有明确的边界。当前验证场景局限于模拟环境,真实世界的 Agent 任务(如树莓派控制、浏览器自动化操作)中轨迹变异性更大、反馈更嘈杂,技能提取的质量会受影响。另外,SEED 的效果高度依赖策略模型本身的"内省"能力——如果模型太小(比如 1B 以下),可能连生成有意义的自然语言技能都困难。论文报告的实验集中在 1.7B-3B 规模,更大规模模型上的效果有待验证。社区也指出,SEED 的密集蒸馏信号本质上来自同一个策略的自我评价,存在"自证自"的潜在偏好偏差——当模型本身对某类错误不敏感时,蒸馏信号也无法指出错误。
作者、代码与资源
SEED 由清华大学自动化系团队联合多个机构完成,第一作者吴金阳(Jinyang Wu)及通讯作者陶建华(Jianhua Tao)等来自清华。论文发布时由 StepFun AI 的 Xiuyu Li 在 X 上推介,社区反响热烈,Hugging Papers 等账号也进行了专题介绍。
对开发者来说,代码仓库提供了完整的训练和评估管线,可直接在 ALFWorld 环境上复现。研究者也可以尝试将 SEED 的 OPD 损失模块替换到自己已有的 GRPO 训练脚本中,GitHub 上的实现以 PyTorch 为基础,便于实验适配。
 AI 速览