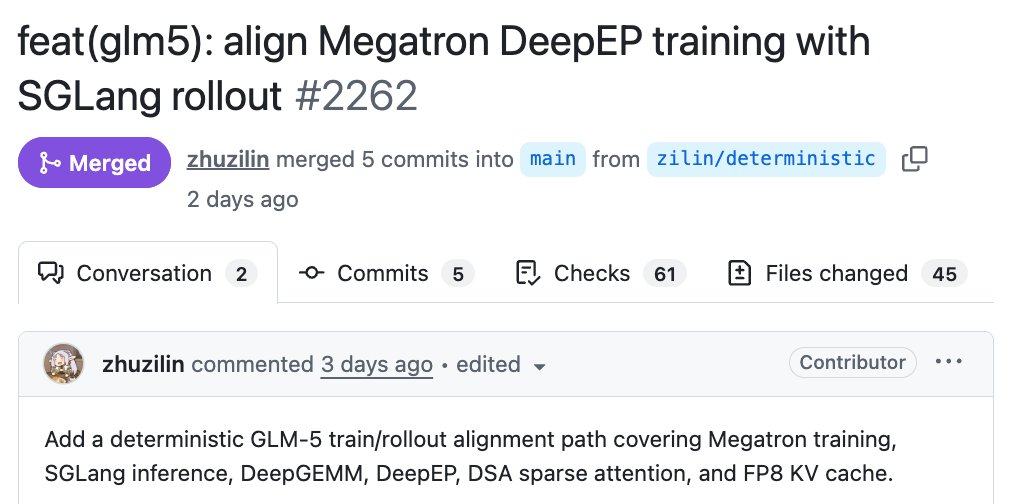
8月13日消息,开源强化学习框架 slime 合并了编号 2262 的变更,加入一条确定性的 GLM-5 训练与 rollout 数值对齐路径。路径覆盖 Megatron 训练、SGLang 推理、DeepGEMM、DeepEP、DSA 稀疏注意力,以及 FP8 KV 缓存。公开测试里,4096 个 token 的训练与 rollout 对数概率平均绝对误差为 1.89×10⁻⁷。这是已合并进仓库的对齐方案,不是 slime 第一次开源。
对齐的是训练栈和采样栈,不是再发一个框架
slime 的仓库在 THUDM 名下,智谱用它做大模型后训练。训练侧走 Megatron,rollout 侧走 SGLang。两边算子、通信和量化不一致时,同一组权重会给出不同的对数概率,强化学习会按漂过的数字更新。这次合入的方案,就是把这条缝对齐。
变更说明写明,DeepGEMM 一侧用与 SGLang 相容的 batch-invariant 块级 FP8 内核,替换部分密集层、indexer、共享专家和 grouped-MoE 前向;DeepEP 一侧在 Megatron 常规训练和 SGLang 低延迟 rollout 之间对齐 top-k 槽位顺序、路由元数据和 FP32 汇聚,并让 DeepEP 成为唯一支持的 MoE 对齐后端。DSA 稀疏注意力对齐融合 RMSNorm、索引投影、RoPE、确定性 top-k 和 FlashMLA 稀疏前向,并加入直通 FP8-E4M3 KV 缓存量化。相关 DeepEP、DeepGEMM 改动还指向作者自己的分支。
数字是 PR 自测口径。4096 个 token 上,训练与 rollout 的对数概率平均绝对误差为 1.894×10⁻⁷。解码器第 0 到第 5 层的隐藏状态差分在每层 4593 个匹配 token 上为 0。说明还写了 100 项针对性测试,以及 8 卡对数概率和对齐门禁。
slime 已用于 GLM-5.2 后训练,本次合入的是 GLM-5 对齐路径
slime 官方文档写它是 GLM-5.2、GLM-5.1、GLM-5 以及 GLM-4.7、GLM-4.6、GLM-4.5 背后的强化学习框架。GLM-5.2 的发布说明也写过后训练用 slime 做大规模 agentic RL 和 OPD。这次 PR 的标题和正文针对的是 GLM-5 的 train/rollout 对齐。
对要在 Megatron 加 SGLang 上接着做 GLM 系强化学习的人,这改变的是训练引擎和采样引擎能不能对上同一套对数概率,以及 MoE、稀疏注意力、FP8 KV 这些环节有没有可检查的误差。误差来自提交者自测,复现要以仓库里的 CI 和启动配置为准。目前没有第三方按同一口径复测这份 MAE。
 AI 速览