随着大模型赛道快速迭代,各类评测榜单层出不穷,不同榜单侧重方向、测试集、模型覆盖范围差异巨大,普通用户很难通过单一榜单判断模型真实水平。
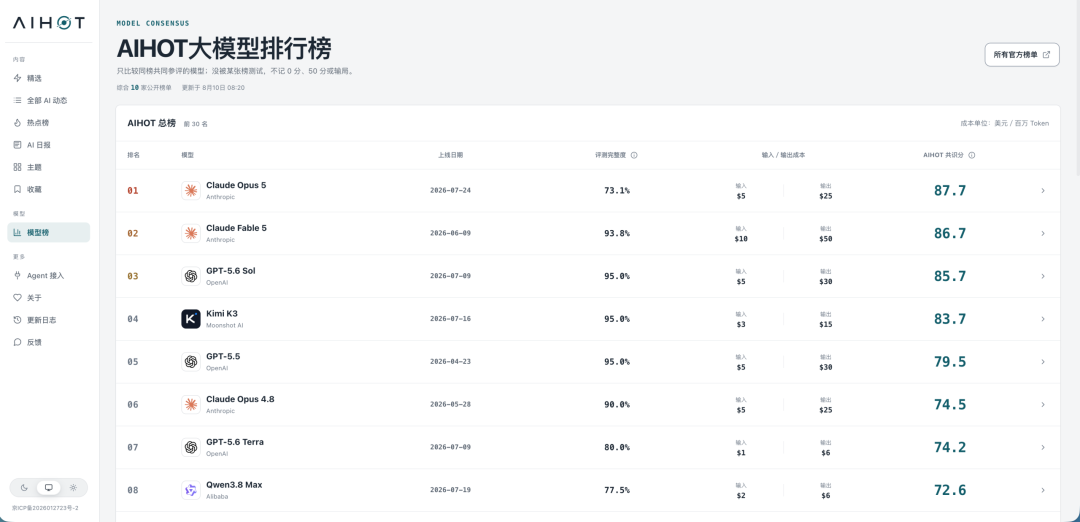
近日 AIHOT 平台正式上线大模型共识排行榜,首批聚合 10 个业内公认的权威评测源,基于自研 LatentRank 算法计算综合共识分,摒弃简单平均分的不合理逻辑,为用户提供更客观、更具参考性的模型性能对比,所有功能完全免费开放。
一、行业痛点:评测榜单泛滥,单一参考存在明显局限
当前大模型评测赛道高度分散,既有覆盖全维度的综合榜单,也有聚焦编程、推理、Agent 等垂直场景的专项测试,数量多达数十个。
不同榜单的模型数量、评分尺度、更新节奏差异极大:同样是第 5 名,在 10 个模型的小榜中仅属中游,在 200 个模型的大榜中则属于顶尖水平;部分榜单头部差距可达 30%,部分榜单分差不足 0.1%,含金量完全不同。 同时多数榜单存在模型覆盖不全的问题,部分模型仅在部分榜单中有数据,简单取平均、补零分或仅统计有效榜单的做法,都会造成结果失真。
用户往往需要同时对照多个榜单自行判断,信息筛选成本极高。这也是本次共识榜的开发初衷:筛选高可信信源,用科学算法输出综合参考。
二、核心算法:LatentRank 成对比较机制,解决多榜融合难题
项目最初仅计划做榜单聚合展示,开发团队原本认为简单取排名平均值即可完成,实际落地后发现该方案存在大量逻辑漏洞。最终团队跨领域借鉴教育测评与电竞排位的成熟方案,基于 Bradley-Terry 成对比较模型打造了 LatentRank 算法。
该算法的核心逻辑是将所有榜单中的模型两两对比转化为 “胜负关系”:同榜中排名更高的模型视为获胜,所有榜单的胜负关系共同构成完整对战网络,反向推算每个模型的真实潜在能力值。即便两个模型从未出现在同一榜单,只要拥有足够多的共同对比对象,也能完成能力校准。 为避免小样本偏差,算法额外加入先验约束与证据预算机制,限制参赛次数过少的模型评分波动;同时设置锚点模型将分数归一至 0-100 分制,保证分数尺度稳定。
针对数据缺失问题,该机制无需补零或强行平均,彻底解决了多榜融合的公平性问题。
三、产品功能:全透明数据展示,规则完全公开
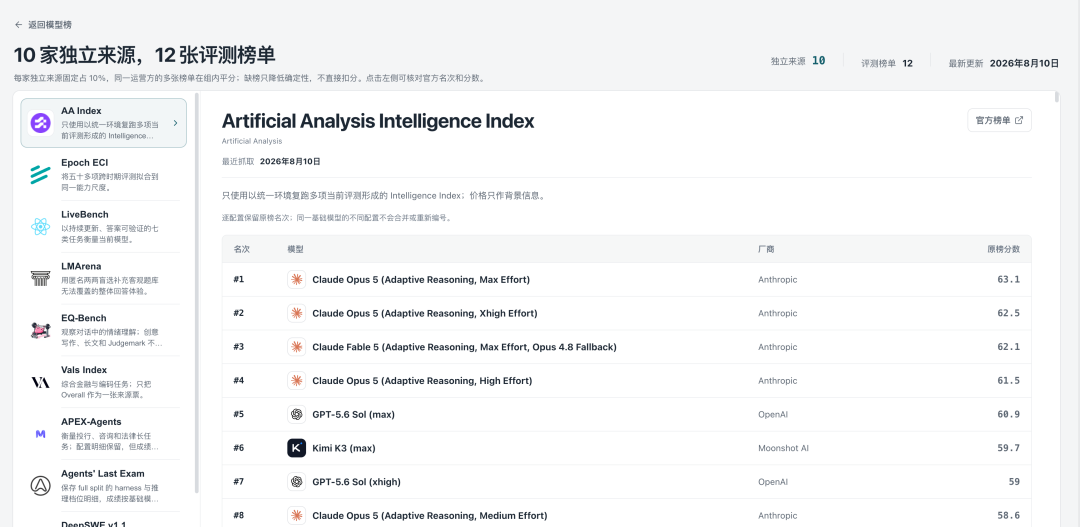
首批共识榜接入 10 个经过筛选的高可信度评测来源,后续还将持续扩充优质榜单。平台核心功能包含三大模块:
- 总榜共识分展示:所有模型按综合共识分排序,直观呈现行业整体梯队;
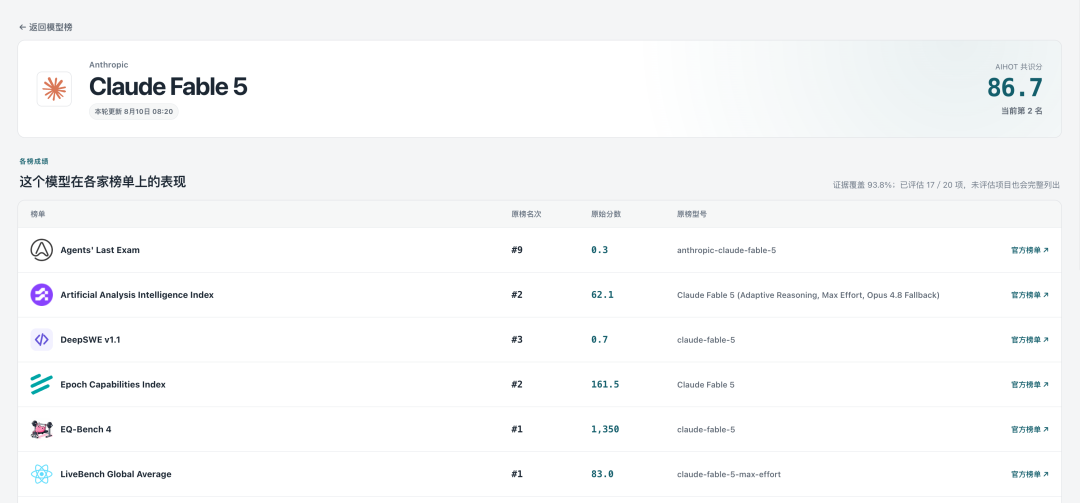
- 模型详情页:点击单个模型可查看其在每个来源榜单中的具体排名与得分,数据完全可追溯;
- 源榜聚合与跳转:平台汇总所有接入榜单的完整信息,支持一键跳转至官方源站查看细节。 同时整套算法规则已完整公开,用户可在规则页查看全部计算逻辑。平台明确表示该榜单并非绝对标准,仅作为多源汇总的参考,不定义模型能力的绝对边界。
四、行业价值:降低信息筛选成本,探索中立评测新范式
本次 AIHOT 共识榜的上线,为普通用户选择模型提供了更全面的参考维度,避免单一榜单的局限性。
其 “筛选可信信源 + 科学算法融合 + 全透明公开” 的思路,也为大模型评测领域提供了新的方向。 从开发过程来看,该项目也是跨领域解决技术问题的典型案例:跳出大模型评测本身的局限,从教育测评、竞技匹配领域寻找成熟方案,用更低成本解决了多榜融合的公平性难题。
目前榜单已在 AIHOT 官网免费开放,后续将持续扩充评测来源、优化算法,进一步提升榜单的客观性与参考价值。
 AI 速览