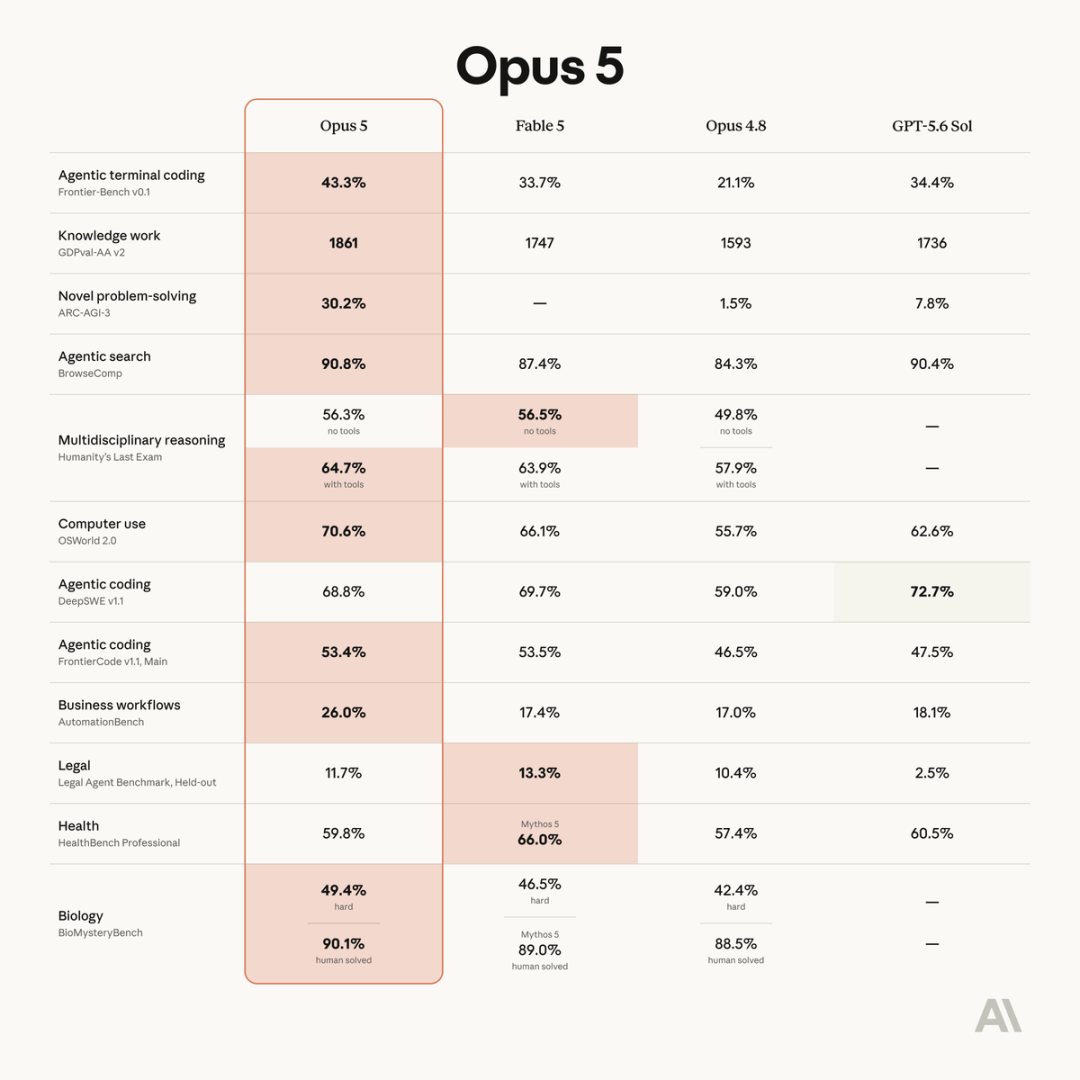
2026 年 7 月 Anthropic 悄然上线 Claude Opus5,100 万上下文窗口、知识库更新至 2026 年 5 月,定价维持 Opus4.8 标准,仅为 Fable5 一半。 综合性能大幅提升,同时官方精简 80% 系统提示语,优化 Agent 工具负载,成为兼顾算力成本与综合能力的主力模型。
一、定价与核心跑分:低成本实现顶尖推理能力
Opus5 计费标准:输入 5 美元 / 百万 Token,输出 25 美元 / 百万 Token;Fast 加速模式价格翻倍,推理速度提升 2.5 倍。核心评测表现亮眼:
- 泛化推理基准 ARC-AGI-3 得分远超 GPT-5.6,擅长陌生规则自主摸索,适合全新场景自主推演;
- Max 推理档位下综合成绩仅落后 Fable5 0.5%,多学科、Agent 编程、法律、医疗四大领域实现反超;
- 成本收益优势突出,高 / 超高 / 深度三档推理模式下,单位算力产出均优于市面主流竞品。 开发者工作流可重构:Fable5 负责顶层方案规划,Opus5、GPT-5.6 并行落地执行,大幅节约高端模型额度,控制 API 月度开支。
二、多场景实测:3D 交互、文本写作各有优劣
3D 游戏 / 交互场景 同等提示词条件下,Opus5 可生成带 NPC 逻辑、动态关卡完整逃生游戏,AI 敌人具备自主巡逻、追击逻辑;GPT-5.6 产出角色行为僵硬,交互可玩性差距明显,适合仿真、游戏开发类批量任务。
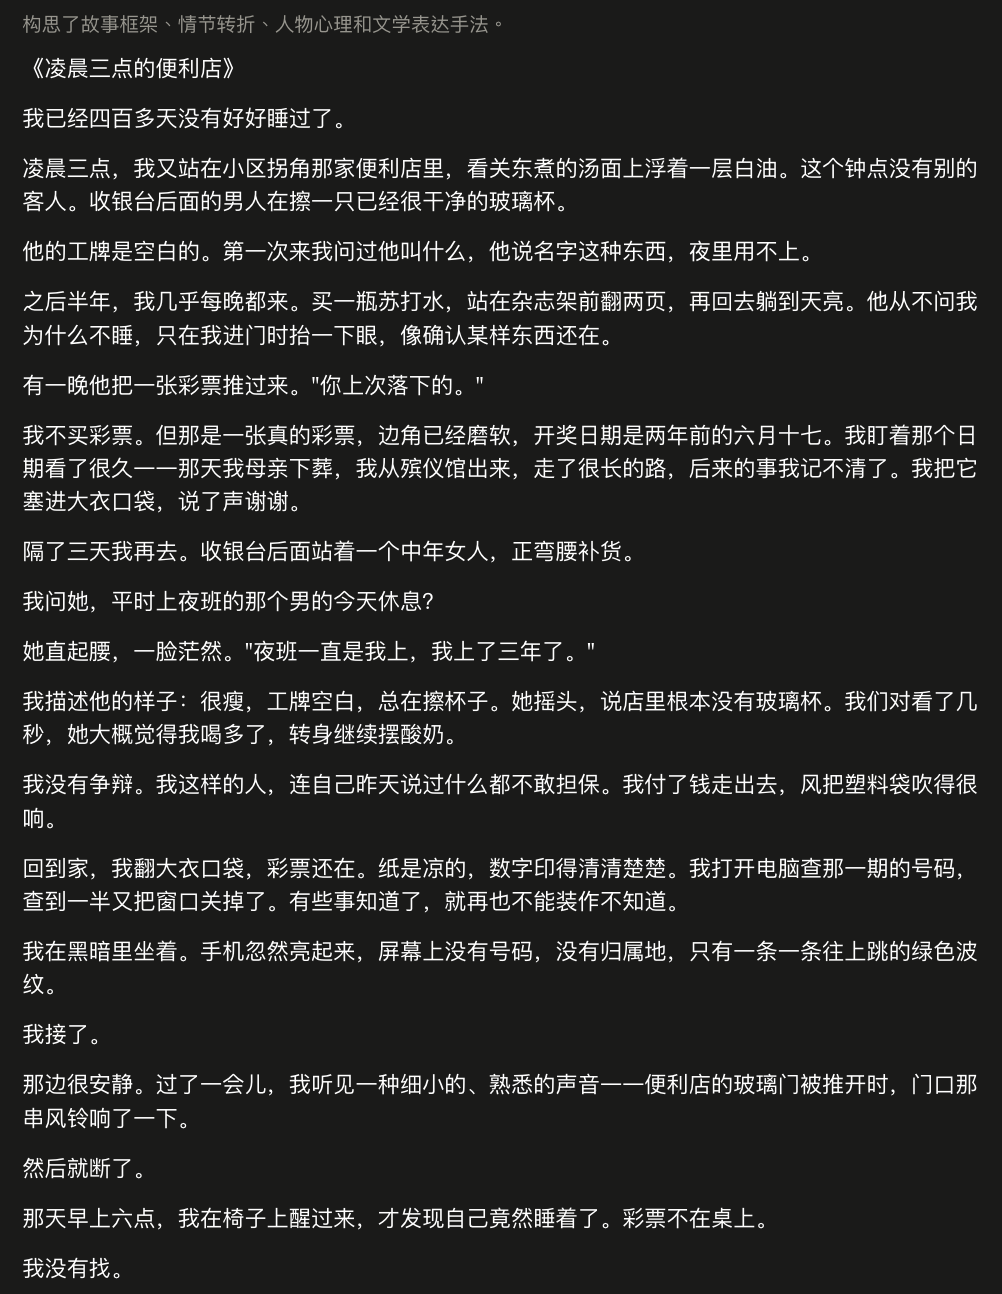
短篇文学创作 Opus5 故事逻辑连贯、剧情完整;Opus4.6 更擅长营造悬疑氛围感,二者各有风格,纯创意写作仍可沿用 4.6,综合文案、叙事类优先选用 Opus5。
三、核心优化:删减八成系统提示语,简化 Agent 工具体系
Opus5 理解能力大幅提升,Claude Code 配套精简 80% 系统提示词,剔除冗余禁令、重复约束、过量示例。 行业对照实验证明:简化提示词后代码评测分数提升 10%-15%,Token 消耗下降 41%-66%,整体成本降低三成以上。大量老旧 Skill、插件会造成指令冲突,拖慢模型思考速度。
官方提供/doctor诊断工具,可自动扫描插件占用资源;配套分层 Skill 管理方案,按使用频率分为高频常驻、项目专属、低频归档三类,低频工具仅保留触发入口,不长期占用上下文,兼顾使用便捷与推理效率。
四、开发者落地价值:重塑模型分层使用逻辑
此前行业普遍依赖 Fable5 完成全流程任务,高额 Token 成本限制日常批量迭代。Opus5 补齐中端模型能力短板,形成分层落地体系:
- 批量开发、3D 内容、常规文案、代码迭代:Opus5;
- 深度代码审计:网页 GPT-5.6 Sol Pro。 对于中小企业、独立开发者,Opus5 大幅降低高端 AI 能力使用门槛,不用再为额度不足妥协使用幻觉更高的旧版 Opus4.8,平衡开发效果与算力预算,成为常态化主力推理模型。
五、行业趋势:大模型自主理解能力持续进化
随着模型基础智力提升,人工堆砌规则、海量约束提示词的模式逐步淘汰。未来 AI 工作流核心不再是编写复杂限制指令,而是搭建轻量化运行环境,让模型自主判断、规划、纠错,减少人为干预带来的上下文损耗,进一步降低全链路 AI 使用成本。
 AI 速览