- Qwen-CUA 是 Qwen 团队与 XLang Lab 联合推出的原生计算机使用智能体,只读屏幕截图,直接输出键盘与鼠标动作,不依赖 DOM、无障碍树或任务专用 API
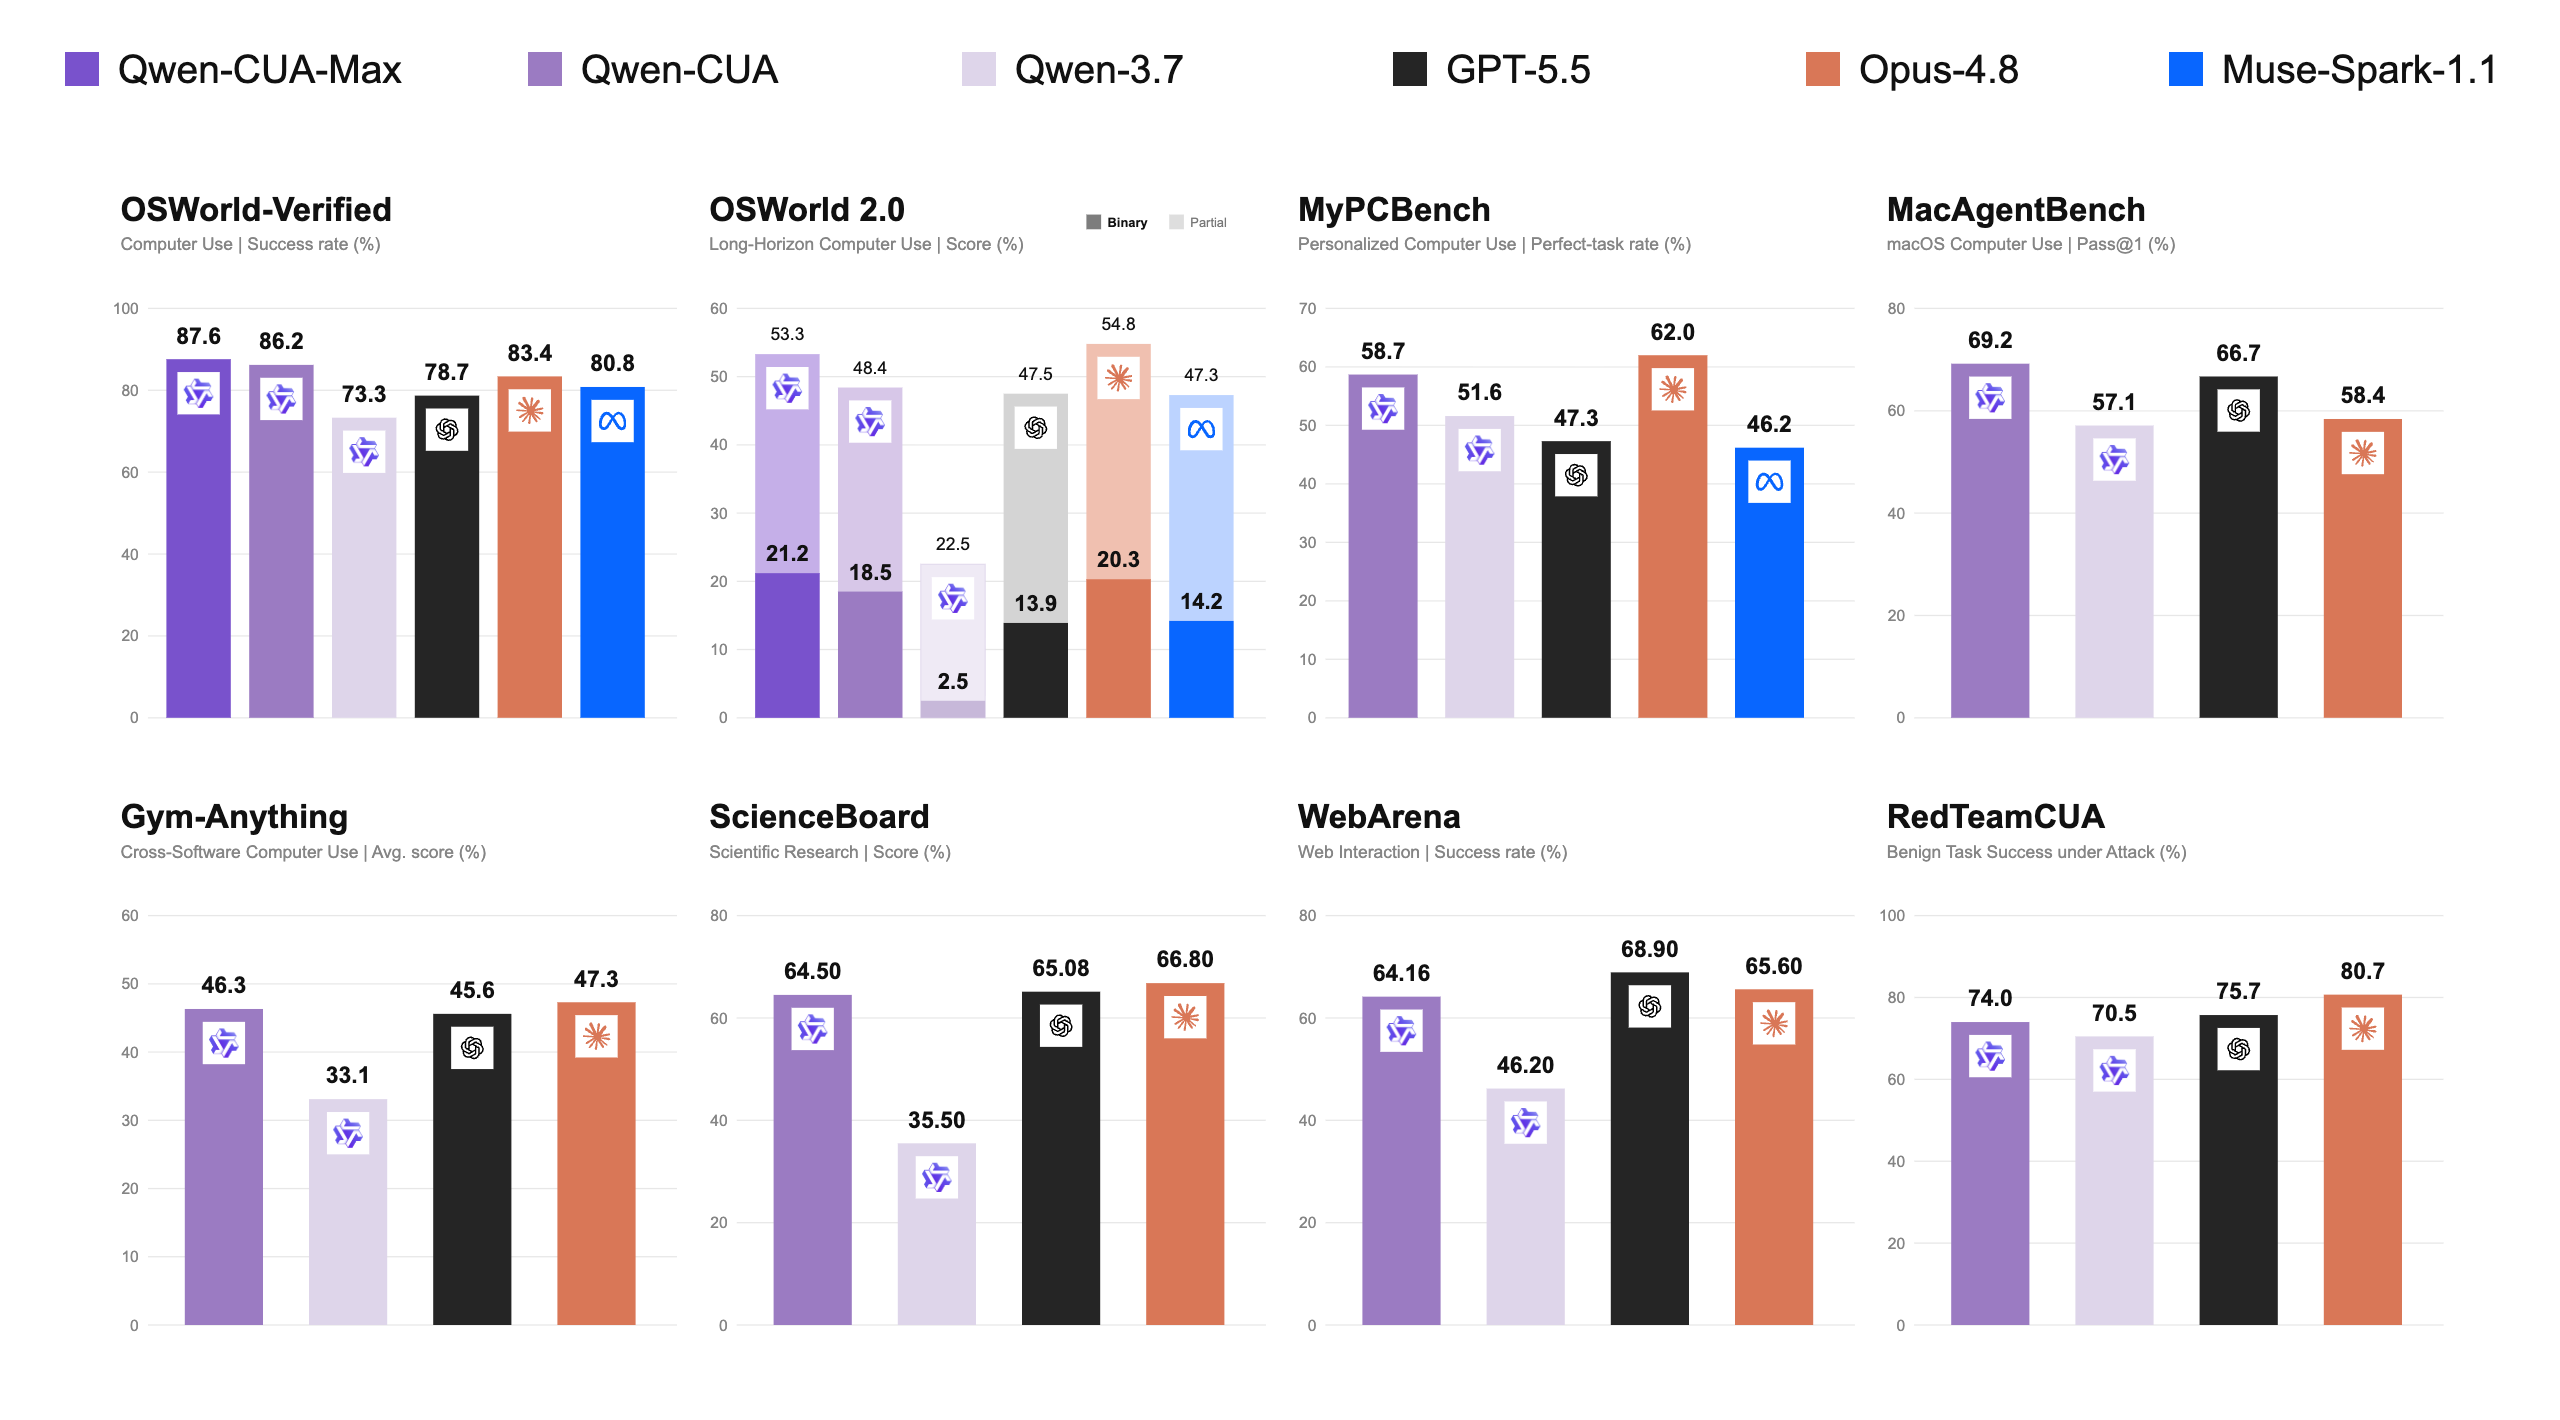
- 模型为 397B-A17B 混合专家架构,扩展版 Qwen-CUA-Max 总参数超 1T;OSWorld-Verified 得分 86.2,Max 版 87.6
- 效率对比:Qwen-CUA 单任务约 3.6K 输出 tokens 拿到 86.2 分,Claude Opus 4.8 用 21.8K tokens 拿 83.3 分
- 训练配套约 4 万可验证任务、近 10 万 vCPU 推演基础设施与数万并发环境;长程视觉上下文保留 20 张截图
- 覆盖桌面使用、长程工作流、个性化计算、科学研究、网页交互、macOS、对抗鲁棒性等八大基准,Apache-2.0 开源
- 官方自述局限:目前单 turn 只输出一个动作,多动作批量执行与自适应工具路由是下一步方向
Qwen-CUA 是什么:截图进,鼠标键盘动作出
Qwen-CUA 是 Qwen 团队与 XLang Lab 联合出品的计算机使用智能体,发布于 2026 年 8 月 3 日。它的输入是屏幕截图流,输出是键盘与鼠标的原生操作事件,输入输出之间没有 DOM 树、无障碍元数据或其他机器可读状态参与。简单说,它把"看屏幕、点界面"这件事做成了模型的原生能力。
这句话的关键在"原生"二字。代码、API 和计算机使用是智能体的三大交互界面,前两者现有模型已经很强,第三个界面(为人类设计的图形界面)长期依赖外围脚本或任务专用接口。Qwen-CUA 的选择是直接吃掉截图、直接发出动作,不绕道。官方给出的模型规模为 397B-A17B,即总参数 397B、激活 17B 的混合专家结构,采用 Apache-2.0 许可,代码与技术报告都在 GitHub 仓库 github.com/xlang-ai/Qwen-CUA 公开。
核心技术:20 张截图的长程视觉记忆与可验证任务训练
第一个核心创新是长程视觉上下文。计算机操作轨迹天然是图像密集的,每交互一步就多一张截图,任务一长,视觉上下文成本就失控。Qwen-CUA 用两个互补机制解决:活动视觉历史保留最近 20 张截图的完整画面,这是 Qwen 各代从 1 张、5 张、10 张一路扩到 20 张的延续;块状折叠(blockwise folding)则把超出预算的更早截图,每 10 张一次性折叠成固定占位符,推理与动作记录留在轨迹里,近期画面保持全量。可以这样理解:像人的记忆,久远步骤只剩摘要,眼前几步保持清晰。折叠算子与训练时切分长 RL 轨迹用的是同一个确定性操作,训练与推理对齐,不需要单独的摘要模型,前缀稳定还提升了 KV 缓存复用。
第二个核心创新是可验证任务的规模化训练。官方构建了约 4 万个可验证任务,部署了近 10 万 vCPU 的推演基础设施,支持数万个并发计算机环境。训练数据与任务集在每轮之间刷新:未解决的任务和弱领域被用于补充新一轮 SFT 数据,RL 任务集围绕可解但未饱和的案例重建。这套流程的成果体现在效率上:OSWorld-Verified 上,Qwen-CUA 以约 3.6K 输出 tokens 拿到 86.2 分,Claude Opus 4.8 用 21.8K tokens 拿到 83.3 分,性能不是靠堆推理长度换来的。
适用场景与效果边界:八大基准与官方承认的短板
官方在覆盖日常桌面使用、长程工作流、个性化计算、科学研究、网页交互、macOS 及对抗鲁棒性等八大计算机操作基准上公布了成绩,其中 OSWorld-Verified 86.2、OSWorld 2.0 二值完成率 18.5、部分完成率 48.4。部分完成率远高于二值完成率,说明长任务能推进到相当程度,但完整走通仍是难点。把同一套方案扩展到总参数超 1T 的 Qwen-CUA-Max 后,三项指标分别提升到 87.6、21.2、53.3,官方认为额外容量对困难的长程工作流尤其有价值。
官方在发布中主动写明了当前短板:在 OSWorld 2.0 上,Qwen-CUA 的交互轮次更多,因为它目前每个 turn 只输出一个原生动作,而 GPT-5.5 与 Claude Opus 4.8 可以在一个 turn 里批量执行多个动作。官方把更紧凑的多动作执行与自适应工具路由列为下一步方向。社区的反应同样值得参考:有研究者评价 Qwen-CUA 是今年 CUA 领域最好的训练管线,与 OSWorld 2.0 基准、CUA-Gym 训练环境同属一批成果;也有用户在发布帖下追问验证循环,即动作是否真正落地、失败后如何恢复,认为这比读懂屏幕更难。这些问题在技术报告中都有对应章节,实际效果建议自己跑一遍。
快速上手:克隆仓库,接一个多模态端点
上手路径已经公开。先克隆 GitHub 仓库 github.com/xlang-ai/Qwen-CUA,进入 demo 目录,把 .env.example 复制为 .env,填入一个 OpenAI 兼容的多模态端点,启动 operator 控制台即可开始操作。官方提供的参考 agent 以浏览器优先,用 Playwright 为每个会话做隔离,运行时会包含动作验证、审批请求与回放证据保存,方便观察每一步发生了什么。技术报告全文在同仓库的 paper 目录下,模型权重与演示代码均采用 Apache-2.0 许可。如果本地没有现成的多模态端点,可以先看官方演示与基准数据,再决定接入方式。
生态定位:三大交互界面的最后一块拼图
Qwen-CUA 的定位是补齐智能体的第三个交互界面。代码适合大规模确定性改造,API 适合结构化调用,图形界面则是人类软件的真实入口,大量专业软件没有 API 或开放接口。把三者放进同一个模型的输入空间,是官方提出的完整接口栈。对开发者,这意味着自动化测试、RPA 替代、老旧软件操作这类此前需要逐任务写脚本的场景,有了统一的基础模型;对普通用户,它意味着能用人机界面完成的事,智能体也能完成。需要提醒的是,当前成果均出自官方与实验室口径,社区批量验证与真实业务部署的反馈,要等开源发布一段时间后才会完整浮现。
 AI 速览