8月4日消息,腾讯混元发布新一代语音识别模型 Hy ASR 3.0 preview。官方介绍称,该模型基于最新大语言模型 Hy3,融合高精度语音识别与深度语义理解,在通用识别、上下文感知、复杂声学场景与方言覆盖等维度全面提升。Hy ASR 3.0 preview 已上线腾讯云提供内测 API,腾讯元宝完成首发上线,用户按住说话即可体验。 从"逐字转写"走向"理解语境"
官方将 Hy ASR 3.0 preview 的定位概括为一次范式演进:从"逐字转写、单点优化"到"理解语境、兼容场景、一键直出"。能力提升集中在四个方向。通用识别上,模型在通用语音、方言与中英混说场景下的准确性提升,重点减少错字、漏字以及长音频中的错误累积。意图理解上,结合上下文精准捕捉语境,智能纠错同音词,消除语义歧义。专业场景适配上,支持热词注入增强,帮助模型快速识别品牌名、人名与行业术语,降低业务接入成本。复杂环境稳定性上,针对高噪、耳语、悄悄话等声学场景进行专项优化。
WER:开源评测集多语种约 3%
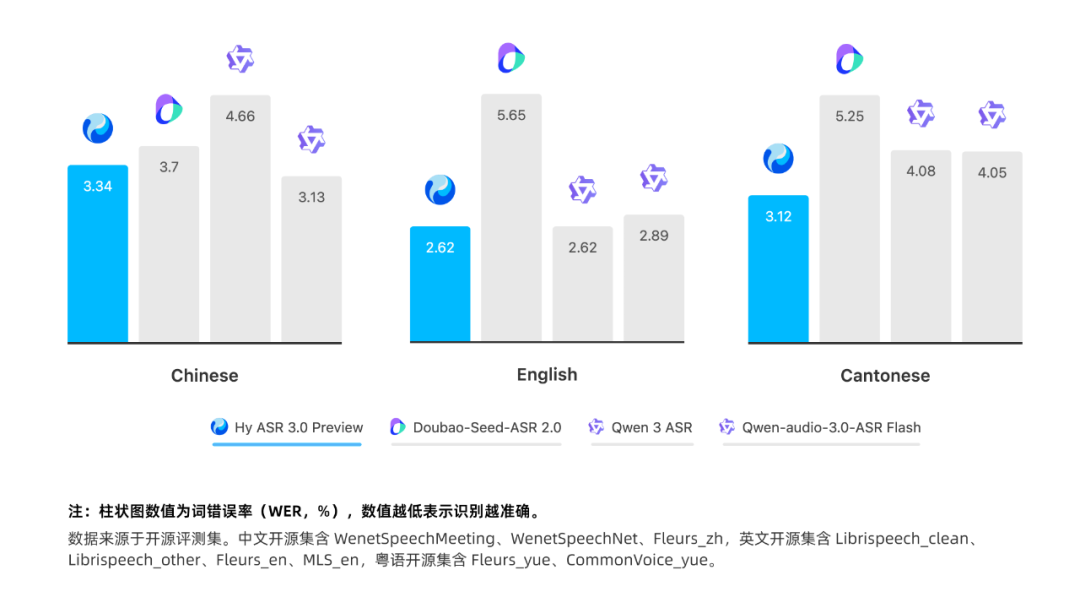
据官方公布的数据,Hy ASR 3.0 preview 在开源评测集上的多语种词错误率(WER)控制在 3% 左右,其中中文普通话 3.34%、英语 2.62%、粤语 3.12%。自建评测集覆盖通用识别、方言识别、上下文理解、专词理解与高噪耳语等场景,官方称 WER 同样保持较低水平。
架构、数据与后训练
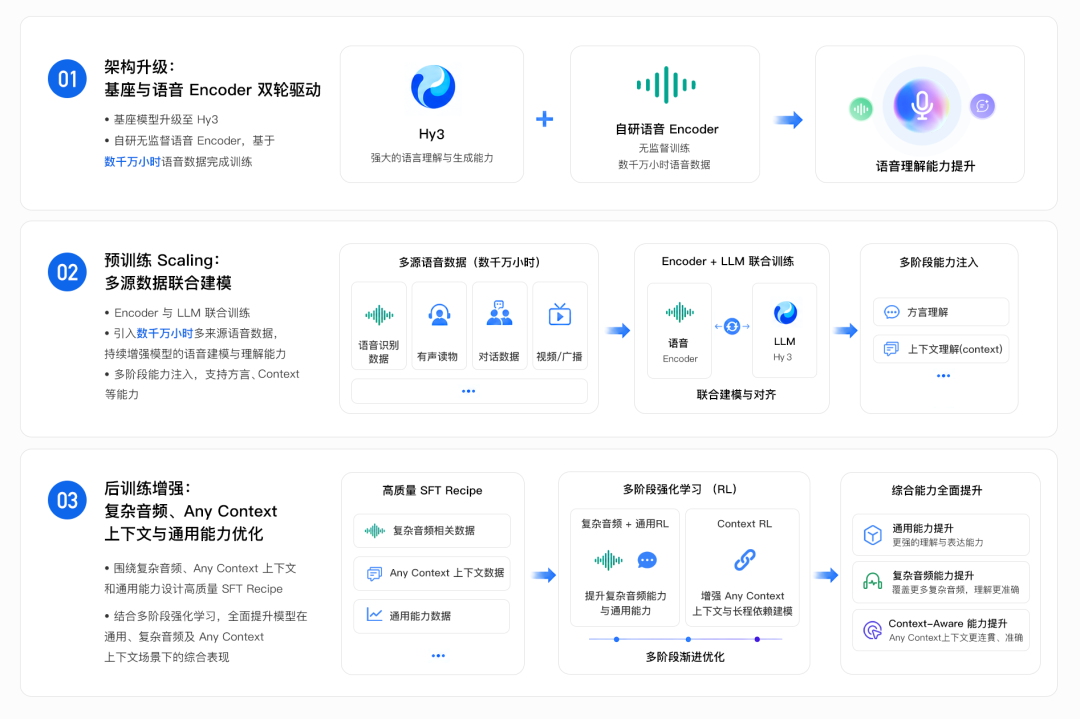
官方披露,模型能力提升来自架构、数据与后训练三方面共同作用。架构上,Hy ASR 3.0 preview 采用 MoE 并升级基座至 Hy3,进一步增强语言理解、上下文建模与语义推理能力。语音侧,团队自研无监督语音 Encoder,通过数千万小时级无监督语音数据训练,使其能从复杂音频中提取高质量声学表征。
数据与训练上,混元团队对语音 Encoder 和大语言模型进行联合训练,引入数千万小时级、多来源的语音数据,覆盖多种方言、口音和声学环境。在大规模联合预训练的基础上,通过多阶段能力注入,逐步获得上下文感知、复杂场景适应和方言识别等能力;SFT 数据体系覆盖 10 大方言片区与 20 余个二级小片区。后训练阶段,团队进一步引入多阶段强化学习,分别针对通用转写准确性、Any-context 上下文能力和复杂长尾场景优化,降低复杂声学环境中的误识别和漏识别。
两个落地入口:元宝与腾讯云 API
Hy ASR 3.0 preview 已通过两条路径对外提供:腾讯元宝完成首发,腾讯云提供内测 API。
腾讯元宝是体验门槛最低的入口。元宝深度参与共研并完成首发上线,用户打开 App 或网页版按住说话即可调用,方言识别、上下文智能纠错与复杂环境转写等能力对用户免费开放,无需写代码。
腾讯云面向开发者。官方文档《混元 ASR(内测版)》(文档 ID 1093/135476)已上线,通过调用腾讯云实时语音识别 WebSocket API,在请求参数中将 engine_model_type设为 Hy-ASR-3.0-preview即可启用该模型。接口支持长语音流数据,实时返回识别结果,实现"边说边出文字"。内测期提供免费并发 20 路,计费按腾讯云大模型 2.0 方案执行。
支持范围与内测限制
腾讯云文档列出的支持范围是中文普通话、英语及 20 种方言,方言包括粤语、东北话、河南话、陕西话、成都话、重庆话、武汉话、贵阳话、青岛话、济南话、长沙话、合肥话、河北话、昆明话、兰州话、银川话、南昌话、北京话、四川话、天津话。
需要特别留意的是,腾讯云文档明确标注当前版本为"内测版本仅作为体验",存在三方面限制:仅支持 1 分钟以内的语音识别;仅支持 16k 单声道 PCM 音频输入;不支持话者分离、VAD、词汇替换与噪音参数阈值。更关键的是,官方公告强调的"上下文理解"与"热词注入增强"两项能力,在内测版 API 中标注为"即将开放体验"——元宝侧已可体验上下文智能纠错,腾讯云 API 侧需要等后续开放。以这两项能力为测试重点的开发者,当前建议以元宝体验为准。
WorkBuddy 等产品也在陆续接入中。对开发者与企业,这是一个处于内测期、由混元统一维护的低成本接入选项,20 种方言覆盖对智能客服、内容理解、语音搜索等场景直接可用;但接入前需核对内测限制是否满足业务需求,尤其是 1 分钟时长与 16k 单声道 PCM 的格式约束。对语音识别市场,理解型 ASR 的入场意味着竞争维度从"谁转写得更准"延伸到"谁更懂上下文"——这场较量的前提,是内测版的能力边界与官方 WER 口径能经得起大规模实测检验。 参考链接
 AI 速览