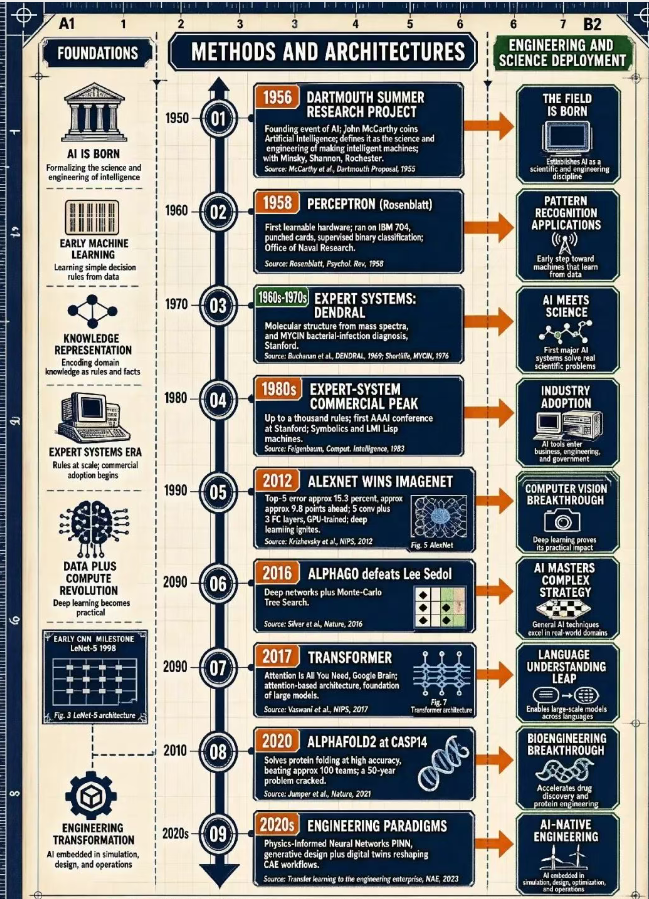
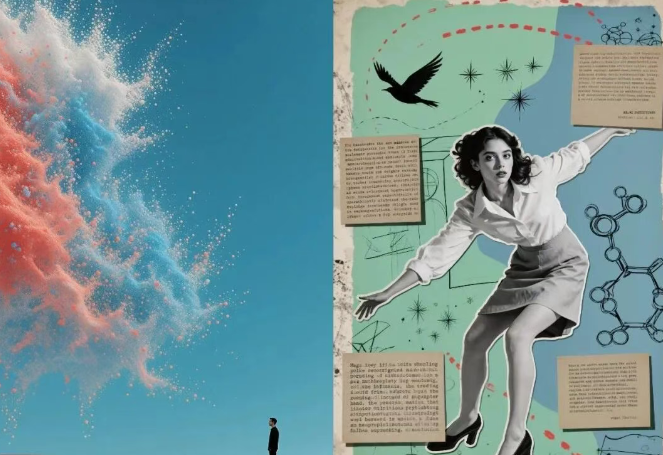
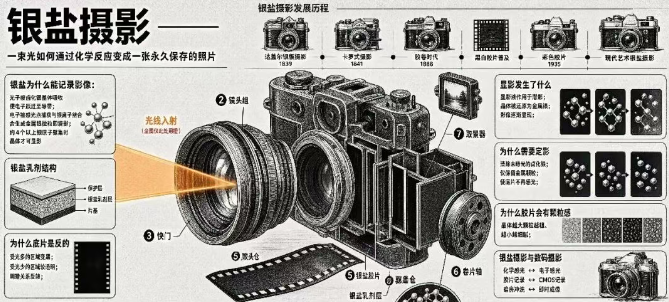
商汤正式面向社区开源 SenseNova U1.5-Lite-Preview 轻量级原生统一多模态模型,基于自研 NEO-Unify 架构,以仅 8B-MoT 的参数量实现 4K 分辨率原生直出,同时具备复杂指令理解、版式生成、精准局部编辑等进阶能力。不同于传统生图模型仅能单点输出素材,该模型可支撑信息图制作、版式复刻、多轮改稿等完整创作流程,更贴近真实设计与内容生产的工作需求。
一、轻量体量大画质:打破参数与分辨率的绑定逻辑
作为早期预览版本,SenseNova U1.5-Lite 最直观的突破是在轻量参数下实现了高画质输出。
模型仅 8B-MoT 参数量,通过重新设计生成头、弱化视觉 Token 网格对画面的影响,并将训练扩展至 4K 分辨率,实现原生 4K 画质直出。放大后画面纹理、材质与光影细节饱满,有效降低了传统低参模型常见的网格感、拼接痕迹与纹理断裂问题。
定位上它并非单纯的生图工具,而是原生统一多模态模型,将语言理解、视觉语义分析、像素生成与编辑能力整合在同一架构内,覆盖视觉理解、推理、生成、修改全链路,为多轮迭代创作提供了底层基础。
二、全链路创作能力:从生成到改稿,适配真实生产场景
该模型的核心优势并非单纯的画质提升,而是对设计工作流的深度适配,解决了传统生图模型 “只能生成、不好修改” 的行业痛点。
高信息密度内容生成方面,模型可承接长篇、分层化的复杂指令,一次性输出信息图、海报、知识长图等结构化内容,能同时梳理时间线、知识模块、视觉层级,保证内容逻辑清晰、版式规整,不会因元素过多出现画面混乱。
版式理解与复用方面,模型可读取参考图的设计框架,保留布局节奏、版式结构与整体风格,仅替换主题内容与视觉元素,相当于快速复刻设计模板,大幅提升系列化内容的生产效率。
精准编辑能力方面,支持红框定位、坐标标记、局部文字修改、氛围色调调整等多种编辑方式,小到单个字符替换、大到整体光影重构,都能做到 “改指定部分、保留其余内容”,无需全图重生成,完美匹配真实工作中反复改稿的需求。同时支持多张参考图融合,可分别提取版式、内容、风格等不同维度的特征,组合输出成品。
三、技术底座:原生统一架构,实现理解生成一体化
能力背后的核心支撑是 NEO-Unify 原生统一多模态架构,它将语言、视觉语义与像素生成放在同一套模型中联合建模,而非多个模块简单拼接。
这意味着模型从读懂指令、分析参考图、判断修改范围到最终生成像素,可在统一框架内完成,对画面的理解深度远高于传统生图模型。也正是这种一体化设计,让编辑操作更精准:修改文字时,模型能理解文字与画面元素的融合关系;调整氛围时,能准确区分主体与背景的边界,避免改动扩散到无需调整的区域。
此外配套的 Prompt Enhance 技术,进一步增强了长提示词的控制能力,用户可逐层明确布局、风格、元素、禁忌项,提升复杂需求的完成度。
四、开源赋能:预览版先行,推动视觉 AI 落地生产
评测数据显示,相比上一代产品,U1.5 预览版在多项基准测试中提升显著:Qwen-Image-Bench 得分从 47.14 提升至 55.20,ImgEdit-Bench、中英文编辑评测均有明显涨幅,编辑能力处于同量级模型第一梯队。
目前开放的为轻量预览版本,正式版后续也将完成开源。对于行业而言,这款轻量、开源、兼具生成与编辑能力的模型,将推动 AI 视觉工具从 “素材生成器” 向 “生产协作工具” 升级,降低高质量视觉内容的生产门槛,让 AI 生图真正融入日常设计、办公、营销等场景的工作流中。
 AI 速览