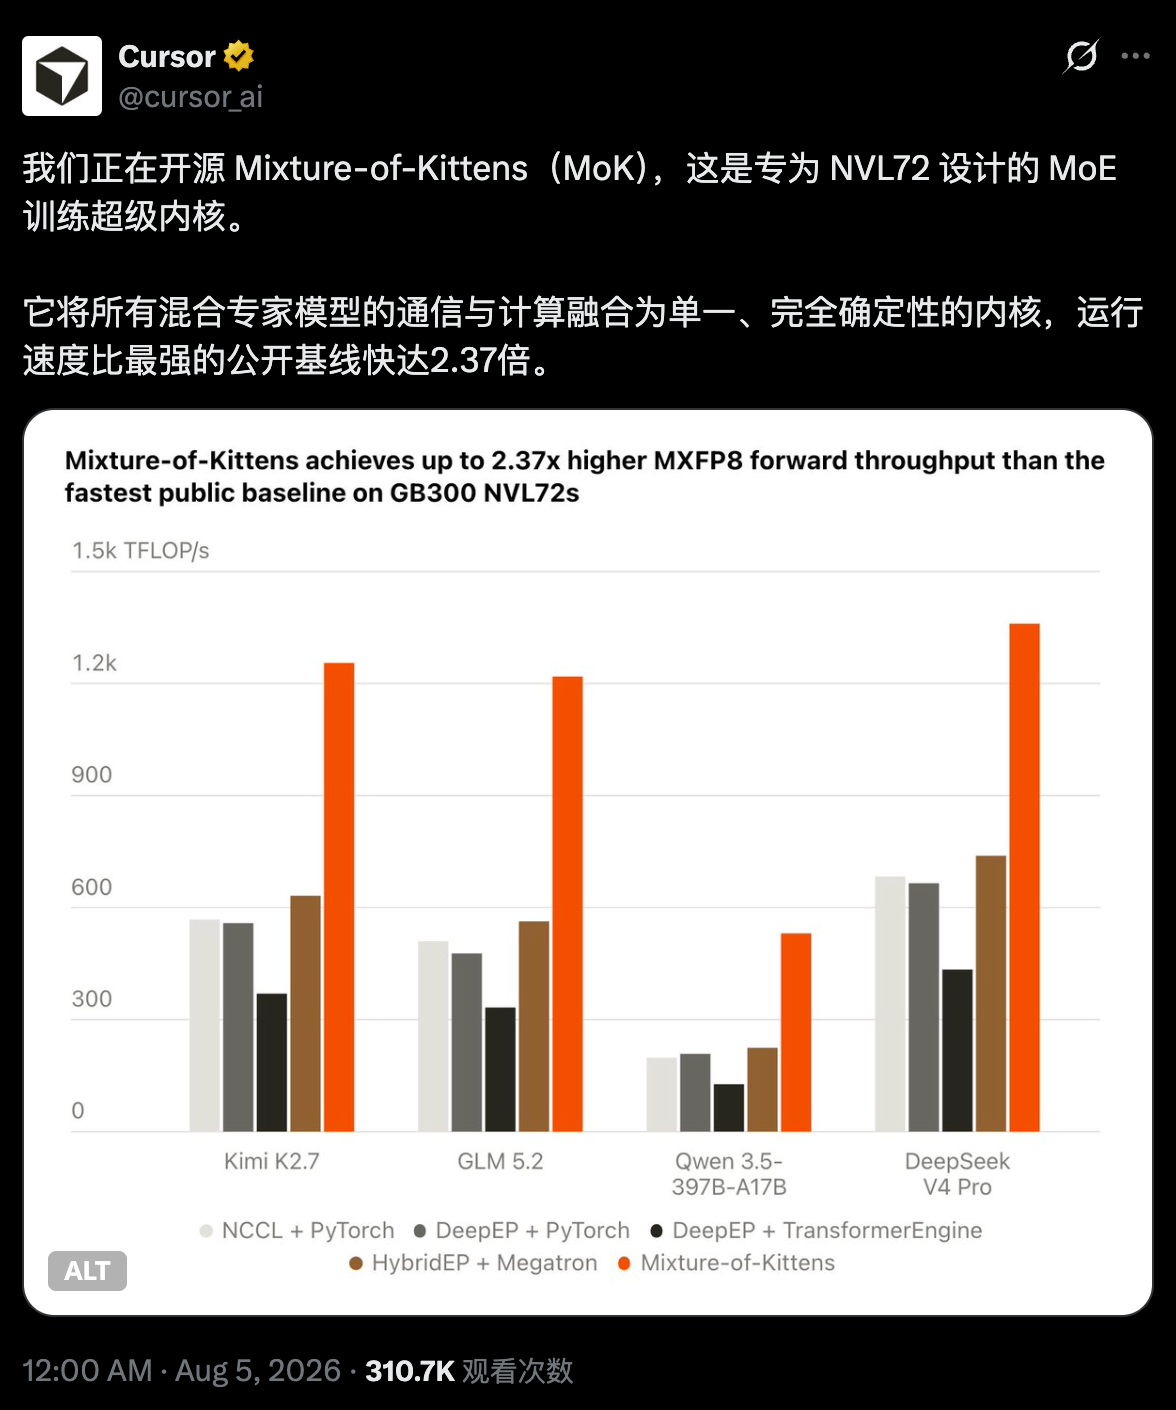
8月5日消息,Cursor 开源 Mixture-of-Kittens(MoK),一套专为 NVIDIA NVL72 设计的确定性 MoE 训练内核,代码以 Apache-2.0 协议发布在 GitHub。官方称,MoK 已支撑 Cursor 自家模型 Composer 在数万张 GPU 上的生产训练,公开基准显示其 MXFP8 前向吞吐比最快的公开基线高 2.37 倍,端到端训练约 1.41 倍。
单内核、全确定性:MoK 的设计
MoK 的核心是把 MoE 训练中的通信与计算融合进单个内核。传统训练栈里,expert 路由的通信(all-to-all)与矩阵计算由不同模块完成,CPU 与 GPU 之间需要反复同步;MoK 把两者合成一个 megakernel,通信与计算按可配置粒度重叠,并彻底消除 CPU-GPU 同步。官方称其完全确定:相同输入产出逐位一致(bitwise-identical)的输出,这在训练复现上是个实用特性。
内核的若干设计围绕 NVL72 的硬件特性展开。NVL72 是 72 张 GPU 组成一个 NVLink 域的多节点机架,GB300 上第五代 NVLink 带宽 1.8 TB/s;MoK 用环形 token 缓冲(macrobatch)处理 token 动态性,反向传播用 reversed ring 减少重放,前向 dispatch 与 combine 分别采用 pull 与 push 两种通信方向,跨 SM 的计算与通信通过本地计数器同步。它支持 BF16 与 MXFP8 两种精度,共享 expert 保持 BF16。
官方基准:四档数字,基线未点名
官方给出两层基准。独立 MoE 层对比中,MoK 的 MXFP8 前向比最快的基线快 2.37 倍,MXFP8 后向 1.78 倍,BF16 前向 1.92 倍,BF16 后向 1.58 倍。端到端训练在 512 张 GPU(多个 GB300 NVL72 机架)上测得:每秒 token 数从 DeepEP-based 栈的 760.9 提升到 MoK 的 1070.2,约 1.41 倍。
对照基线有四个:NCCL 加 PyTorch、DeepEP 加 PyTorch、DeepEP 加 TransformerEngine,以及 HybridEP 加 Megatron(官方称后者是 NVIDIA 在 NVL72 上的推荐方案)。「最快的公开基线」是这四个中表现最好的一个,官方未点名具体是哪套。以上均为官方自测口径,基准代码与配置已随仓库公开。
生产验证:Composer 数万 GPU 在用
MoK 不是实验室产物。官方称其「现在支撑着 Composer 在数万张 GPU 上的训练」,Composer 是 Cursor 的 agentic coding 模型,此前 Cursor 的生产训练栈基于 DeepEP 加自定义 MXFP8 计算内核。另一个背景是 Composer 2.5 以 Kimi 2.5 为基座。Cursor 在开源社区模型之上训练自己的 agent 模型,现在把训练内核也开源出来。 开源原因的官方表述是降低 AI 研究门槛,让更多研究团队高效训练模型;项目将持续维护并接受社区反馈,官方还特意提到目标是「容易修改,让 agent 能帮我们适配到其他平台」,内核层也开始用 agent 来迭代。
训练内核开源的坐标
MoK 落进的是一个已有玩家、但开源选择不多的位置。DeepEP(DeepSeek 开源)是 expert-parallel 通信库,TransformerEngine 与 Megatron 来自 NVIDIA,HybridEP 加 Megatron 被 NVIDIA 列为 NVL72 推荐方案。MoK 以 Apache-2.0 全量开放,且直接对标 NVIDIA 推荐栈的性能。这是应用公司反哺训练基础设施的一个少见案例:Cursor 首先是 coding agent 产品公司,训练内核开源是其第二次向基础设施层开放。 应用公司开源训练内核
对训练 MoE 模型的团队来说,MoK 的价值在于可复现的完整实现:Apache-2.0 协议、基准代码公开、生产环境验证过。但它的使用门槛不低:要求 GB200/GB300 NVL72、CUDA 13.0 与 PyTorch 2.10 以上,面向的是有 NVL72 机架的实验室与云厂商,不是消费级硬件。
 AI 速览