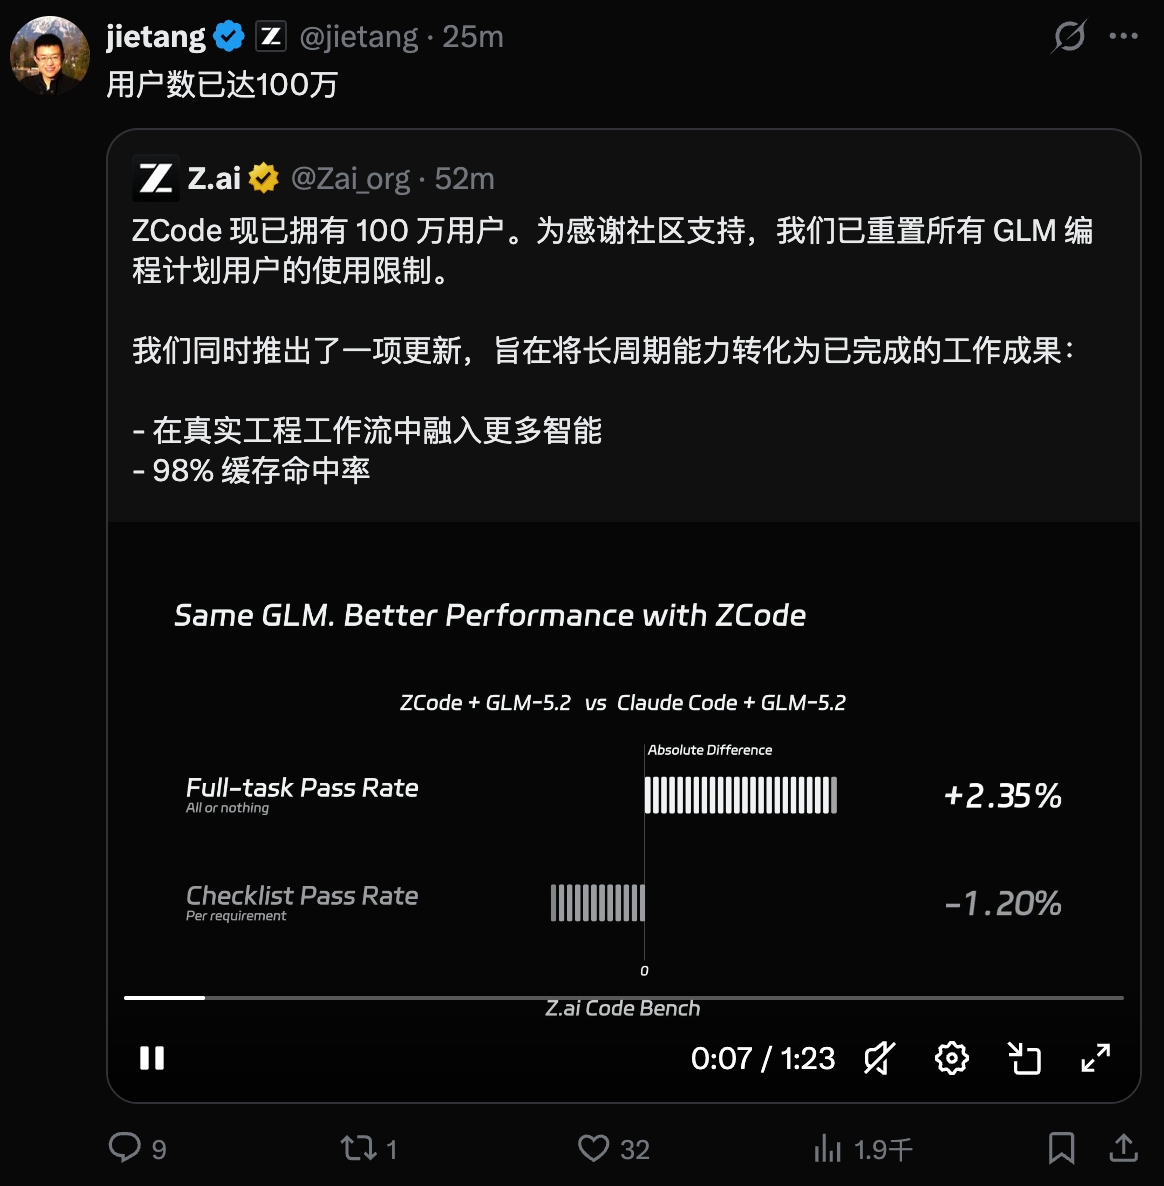
8月11日消息,智谱宣布 AI 编程产品 ZCode 迎来重大升级,Goal、Subagents、Remote Control 与闲时任务四大功能正式上线,同时官宣用户数突破 100 万。作为百万用户里程碑的回馈,GLM Coding Plan 全体用户额度已于当天 13:00 统一重置。智谱官方将 ZCode 定位为针对 GLM 深度优化的 Coding Harness,是百万开发者用 GLM 写代码的首选入口;随升级发布的缓存优化与限时活动叠加后,GLM 整体使用量接近常规额度的 1.8 倍。
让复杂任务自主交付:Goal 与 Subagents
升级的核心变化是让 Agent 自己把复杂任务跑完。Goal 模式改变了过去的交互流程:开发者只需设定一个明确、可验收的目标,例如把首屏加载时间控制在 2 秒以内并确保现有测试全部通过,ZCode 会自动拆解任务、修改代码、运行命令和执行测试,再根据文件、命令输出与测试结果判断目标是否完成,没有达标就进入下一轮,直到完成。每轮的进度、耗时与执行结果在 Goal 面板中可见。
Subagents 让一个 Agent 变成可并行协作的开发团队。ZCode 内置两类子智能体:General-purpose 负责修改代码、修复问题和运行命令;Explore 负责只读探索,适合定位代码、分析调用链和在改动前收集证据。用户也可以创建自己的子智能体,配置模型、权限范围和提示词,并在聊天框中用斜杠直接调用。对全栈功能开发、跨文件重构和复杂 Bug 定位,这种方式比单 Agent 从头做到尾更高效,也减轻了长任务对主对话上下文的占用。
把 ZCode 装进手机:Remote Control 与闲时任务
Remote Control 将当前 ZCode 桌面窗口临时开放给手机访问。长任务在电脑上运行时,开发者可以通过手机查看进度、继续输入指令、创建新任务或重新连接断开的工作区。除了扫码和浏览器链接,ZCode 支持微信、飞书与 Lark,可以直接从会话中打开工作区跟踪执行进度。手机只作为控制界面,代码和命令仍在桌面端原有环境中运行,不会把项目同步到手机,也不会额外创建云端环境;本地、SSH、WSL 与 Docker 工作区均可使用。 闲时任务面向不着急但耗时长的工作:GLM Coding Plan 用户提交后,ZCode 会在低峰时段自动执行,在闲时任务权益范围内不扣减用户积分。
GLM 的最佳 Harness:Z.ai Code Bench 对比
智谱官方给出的定位判断是:模型决定能力上限,Harness 负责上下文管理、工具调用、任务调度、缓存和结果校验,决定模型能力能发挥出多少,同一个模型放在不同 Coding Agent 里实际表现可能差很多。为支撑这一判断,智谱用内部自研的 Z.ai Code Bench 做了对照测试:使用 GLM-5.2 分别搭配 ZCode 与 Claude Code,结果显示 GLM 加 ZCode 的任务整体通过率高 2.39%,检查项通过率低 1.22%;优势更集中在需要跨文件、跨环节协作并完成最终验收的复杂任务上。 Z.ai Code Bench 是智谱自研评测,围绕真实用户需求场景,按 Full Stack、Bug Fix、Feature Implementation 等细分类别构造任务,通过回归测试、新功能测试、前端模拟交互与代码质量评估等维度评估复杂长程编程能力。评测口径为官方自研,2.39% 与 1.22% 的差距属于单次对照测试结果,实际体感仍需开发者按自己任务验证。
缓存优化与额度重置
ZCode 对上下文缓存复用做了专门优化。根据智谱对多款 Coding Agent 的测试,GLM 在 ZCode 中的缓存命中率超过 98%,让更多重复上下文命中缓存并以更低积分系数抵扣,GLM Coding Plan 有效 Token 量因此提升约 30%;即日起至 2026 年 8 月 31 日,在 ZCode 中使用 GLM Coding Plan 还可获得 1.5 倍限时额度加成,两项叠加后整体使用量接近常规额度的 1.8 倍。98% 与 1.8 倍均为官方口径,智谱未公布缓存命中率的测量细节。
Harness 成为模型能力的变量
ZCode 升级公告与近期第三方评测指向同一个方向:编码 Agent 的实际表现不只由模型决定,Harness 的上下文管理、缓存策略与任务调度直接进入结果与账单。Composio 用同一个 DeepSeek V4 Flash 在 8 个工具链上测试时,每成功任务成本差约 7 倍,结论同样是应评测模型与工具链的组合。ZCode 以 GLM 最佳 Harness 定位切入这一竞争,把缓存命中率、目标模式与多智能体协作做成产品差异。官方自研评测与官方口径数据之外,这些能力在真实工程中的效果,需要开发者用实际任务验证。
 AI 速览