Ollama是一个开源(MIT 协议)的本地大语言模型运行工具,让你用一行命令在自有电脑上运行 Llama、Mistral、Gemma、Qwen、DeepSeek 等 100+ 开源模型,无需云端 API、无需付费、数据完全留在本地、支持离线使用。本文详解 Ollama 的定义、功能、安装使用方法、硬件要求与云端方案对比。 Ollama是什么
Ollama 是一个面向本地推理的LLM 运行与管理平台,常被称为"Docker for LLMs"——它把模型权重、量化配置与运行环境打包,用户只需 ollama run llama3.1 一条命令,就能自动下载并启动对话,省去了手动配置 CUDA/ROCm、调量化参数等复杂步骤。底层基于高效的 llama.cpp 框架构建。
它解决了"本地跑大模型"最大的技术门槛:模型下载管理、量化(4bit/8bit 省显存)、GPU/CPU 自动调度、统一 API 接口。启动后 Ollama 会在本机 localhost:11434 提供 REST 服务,相当于在你电脑上跑了一个"本地版 OpenAI API"。
- 核心定位:一行命令在本地运行、管理与调用开源大模型。
- 模型生态:100+ 模型,涵盖 Llama 3.x、Mistral/Mixtral、Gemma 2、Phi-3、CodeLlama、Qwen 2.5、DeepSeek-R1、Llava 多模态等。
- 支持平台:macOS 11+、Windows 10/11、Linux,支持 NVIDIA(CUDA)、AMD(ROCm)与 Apple Silicon。
Ollama的主要功能
Ollama 围绕"下载—运行—管理—集成"提供完整能力:
- 一行命令运行模型:ollama run llama3.1 自动下载并进入对话模式,支持单次问答、管道输入与参数调整。
- 模型管理:ollama list 查看已装模型、ollama pull 仅下载、ollama rm 删除释放空间、ollama ps 查看运行中模型。
- 自动量化与调度:内置 4bit/8bit 量化节省显存,自动在 GPU/CPU 间调度,低配机器也能跑。
- Modelfile 自定义:通过 Modelfile 定义系统提示词、参数与行为,ollama create 生成专属模型。
- 本地 REST API:默认端口 11434 提供 API,兼容 OpenAI 格式(/v1),现有 OpenAI 代码几乎无需修改即可切换。
- 生态集成:官方 Python 库(pip install ollama)、LangChain(langchain-ollama)、Open WebUI 图形界面、Embedding 模型本地 RAG 等。
Ollama怎么安装和使用
安装门槛极低,基础使用路径如下:
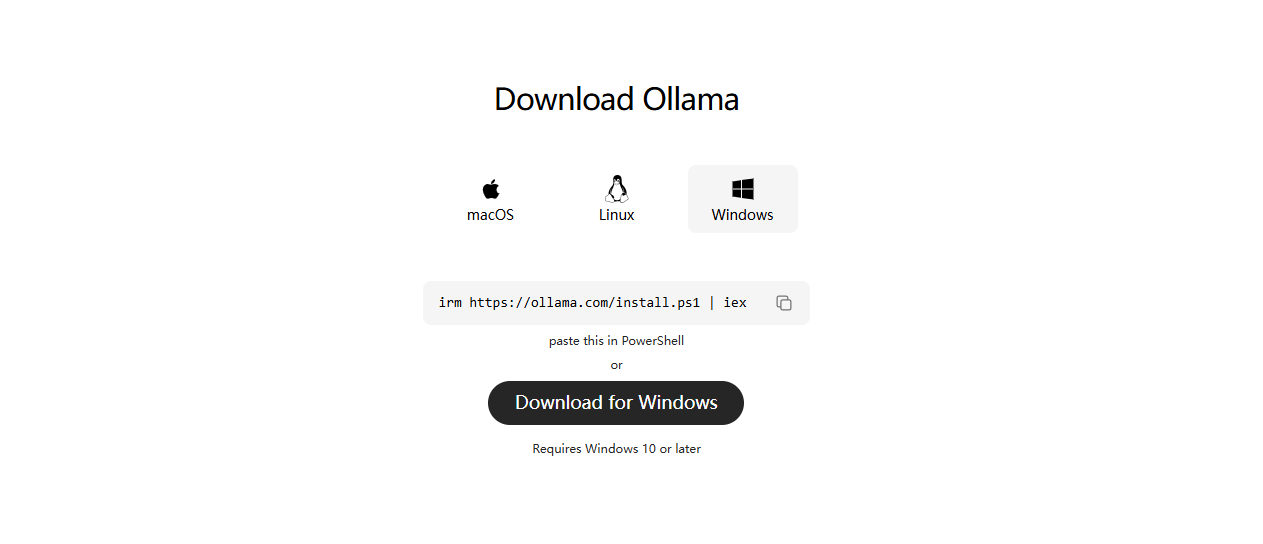
- 安装:macOS/Linux 执行 curl -fsSL https://ollama.com/install.sh | sh;Windows 到 ollama.com 下载安装包,安装后验证 ollama --version。
- 运行第一个模型:执行 ollama run llama3.1,自动下载(约 4.7GB)并进入对话,输入 /bye 退出。
- 按需选模型:中文场景推荐 ollama run qwen2.5;代码场景 ollama run codellama;轻量低配用 ollama run phi3.5;推理数学用 ollama run deepseek-r1:7b。
- 调用 API:启动后访问 http://localhost:11434,用 OpenAI 客户端把 base_url 指向 http://localhost:11434/v1 即可接入本地模型。
- 搭界面(可选):用 Docker 一键部署 Open WebUI(默认端口 3000),获得类 ChatGPT 的本地图形界面。
提示:显存(VRAM)或内存(RAM)决定你能跑多大的模型——7B 模型建议 16GB 内存、8B 模型建议 6GB 以上显存;70B 量化模型需要 24GB+ 显存或 64GB 统一内存。
Ollama的系统要求与硬件配置
硬件需求随模型规模线性上升,参考配置如下:
| | |
|---|
| | Llama 3.2 3B、Phi-3.5 Mini、Gemma 2B |
| | Llama 3.1 8B、Mistral 7B、Qwen 2.5 7B |
| | CodeLlama 13B、Llama 3.1 13B |
| | Llama 3.1 70B、Qwen 2.5 72B(量化) |
速度参考:NVIDIA 8GB 显存跑 8B–13B 模型约 20–40 tokens/秒;纯 CPU 跑 3B–7B 约 3–10 tokens/秒;Apple Silicon(M3/M4 Max 64GB 统一内存)可流畅运行 70B 量化模型,约 20 tokens/秒,是性价比很高的便携方案。
Ollama和云端API(ChatGPT/Claude)的区别
本地运行与云端方案各有取舍:
简言之:Ollama 胜在隐私、零成本、离线与无限使用,适合敏感数据场景(医疗、法律、企业内部)与本地开发调试;若追求顶级模型能力或不想折腾硬件,云端 API 仍是首选,两者可混合使用。
Ollama的注意事项
- 硬件门槛真实存在:本地跑大模型对显存/内存要求高,70B 级模型需 24GB+ 显存或 64GB 统一内存,选型前先评估硬件。
- 模型能力有天花板:开源模型整体弱于 GPT-4/Claude 等顶级闭源模型,复杂推理、长文与多模态任务需放低预期。
- 遵守模型许可证:模型各自有许可(如 Llama 采用社区许可),商用前确认是否符合授权条款。
- 磁盘占用大:单个模型 2GB–40GB+,装多个模型前预留充足磁盘空间。
- 本地≠绝对安全:数据不出本机是优势,但模型输出仍可能有偏见或错误,重要结论需人工核验。
以上内容基于公开资料与官方文档整理,Ollama 的功能、模型库与系统要求可能随版本更新变化,请以官方网站(ollama.com)及 GitHub 仓库最新信息为准。
 AI 速览